Simulace dynamiky Bose-Hubbardova modelu s volitelným kódováním
Tento průvodce sestavuje obvod pro časovou dynamiku jednorozměrného Bose-Hubbardova modelu, od zápisu hamiltoniánu až po kontrolu vyvinutých hustot míst oproti přesné referenci. Zajímavou tuto cestu činí jediná myšlenka:
Nevybírej kódování bosonů na qubity při sestavování obvodu. Sestav obvod nad bosonovými módy a nech transpiler rozhodnout, jak se tyto módy stanou qubity.
U bosonů téměř vždy musíš kódování odložit. Bosonový mód pojme libovolný počet částic, takže jeho Fockův prostor je nekonečně rozměrný a žádné kódování neexistuje, dokud nejprve nezvolíš ořezání (počet obsazovacích úrovní, které ponecháš). V kódu se ořezání zadává jako největší obsazení, které mód může mít, max_occupation , takže mód, který ponechává úrovně , má max_occupation = 2 a .
Ořezání se tak stává parametrem kódování, ne fyziky, a je to parametr, který chceš měnit: příliš malý a výsledek je špatně, příliš velký a obvod je zbytečně široký. Pokud kódování odložíš na dobu transpilace, můžeš ořezání procházet, aniž bys měnil obvod, hamiltonián nebo seskupení.
Průvodce operátory k datové struktuře operátoru, průvodce mappery ke kódováním a receptu na psaní vlastního mapperu a průvodce transpilací k fázím transpileru, na které se průběžně odkazuje.
Ořezání a jeho cena
Když mód ořežeš na úrovní, porušíš kanonický komutátor na nejvyšší ponechané úrovni [1], takže žádné kódování není izomorfismem algeber: bosonové kódování zobrazuje stavy a operátory působící uvnitř ořezaného podprostoru. Pro vše následující jsou důležité dva důsledky:
-
musí omezovat obsazení dosažitelné dynamikou, nejen obsazení počátečního stavu.
-
Zobrazení nekomutuje s normálním uspořádáním, takže jednou rozhodni, zda je tvůj hamiltonián definován v normálně uspořádaném tvaru, a drž se toho.
Průvodce mappery odvozuje defekt a ukazuje oba důsledky na běžícím kódu.
1. Hamiltonián
Bose-Hubbardův model na mřížce s vazbami je
s . Interakce počítá páry bosonů na místě, takže vyžaduje, aby místo pojalo dvě částice najednou. V normálním uspořádání , což je tvar používaný dále.
Geometrie vstupuje pouze přes seznam hran, takže nic není specifické pro řetězec:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Stojí za to nejprve zkontrolovat dvě vlastnosti. Hamiltonián musí být hermitovský, aby bylo unitární, a zachovává celkový počet bosonů:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Nyní bosonová otázka: kolik úrovní tento operátor vyžaduje?
>>> hamiltonian.max_occupation()
2
Interakční člen aplikuje dva kreační operátory na jeden mód, takže mód musí pojmout dva bosony, aby člen vůbec působil. To je maximální obsazení 2, což je číslo, které LevelSpec přijímá jako max_occupation. Mód, který ponechává obsazení , má úrovně, takže max_occupation >= 2 je stejný požadavek jako .
Toto je pouze dolní mez: plyne z jediné aplikace operátoru a opakovaná aplikace během časového vývoje může sáhnout dál. Vylučuje meze, které jsou jistě příliš malé, a krok 6 pro tento model a stav určí, jak velká mez musí být. mode_occupations() hlásí mez pro každý mód zvlášť, s čímž se porovnává mez pro jednotlivé módy.
2. Seskupení před zobrazením
Vývoj je Trotterizován a to, jak je hamiltonián rozdělen, určuje, co dostane syntéza. Dvě úvahy míří stejným směrem.
Za prvé fyzikální: jednotlivý přeskokový člen není hermitovský. Hermitovský je pouze pár . Pokud vyvíjíš pod jediným nehermitovským členem, operace není unitární a zobrazený operátor by nesl komplexní koeficienty, které PauliEvolutionGate odmítne. Dva přeskokové členy každé vazby proto musí zůstat pohromadě.
Za druhé efektivita: všechny místní interakční členy jsou diagonální v obsazovací bázi a navzájem komutují, takže mohou sdílet jednu skupinu a být syntetizovány společně. Totéž platí pro vazby, které se nedotýkají žádného společného místa. Na řetězci je takovou množinou každá druhá vazba: vazby 0 a 2 působí na disjunktní dvojice módů, takže jejich přeskokové členy komutují a mohou sdílet skupinu, a vazba 1 tvoří vlastní skupinu. Pokud seskupíš sudé a liché vazby, potřebuješ tedy tři skupiny, kdežto jedna skupina na vazbu jich potřebuje čtyři. Méně skupin znamená méně činitelů a také mělčí obvod: s Grayovým kódem při max_occupation = 2 je hloubka dvouqubitových hradel 95 oproti 139. Mřížka rozhoduje, které vazby mohou sdílet skupinu, a proto se rozdělení volí zde.
Atribut groups přenáší toto rozhodnutí do obvodu: hradlo Evolution nad seskupeným operátorem se rozloží na jeden podvývoj na skupinu. Rozdělení se volí na bosonové úrovni, dokud je struktura mřížky ještě viditelná, a přežije zobrazení beze změny. Průvodce seskupováním popisuje kontroly, které by seskupení mělo splnit.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Každá skupina musí být sama hermitovská, což zajišťuje předchozí párování. groups_are_hermitian() zkontroluje všechny skupiny jedním voláním:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Chceš-li vidět, co která skupina obsahuje, skupiny oddělíme:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Seskupení na sudé a liché je volba a alternativu lze snadno změřit. Pokud dáš každé vazbě vlastní skupinu, potřebuješ čtyři skupiny a stejný obvod pak stojí větší hloubku dvouqubitových hradel. Hloubka se počítá po rozložení obvodu s Grayovým kódem při max_occupation = 2, což vysvětluje krok 4:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Bosonový obvod
Všimni si, co v obvodu chybí. Není tam žádné ořezání, žádné kódování a žádný počet qubitů. Působí na čtyři bosonové módy:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Dráty jsou bosonové módy, ne qubity. Všimni si, že InitializeModes přijímá celá čísla, ne příznaky: mód může pojmout libovolný počet bosonů, takže Fockův stav je seznam obsazovacích čísel.
Jediné volání decompose() promění seskupení z kroku 2 na jedno hradlo na skupinu:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
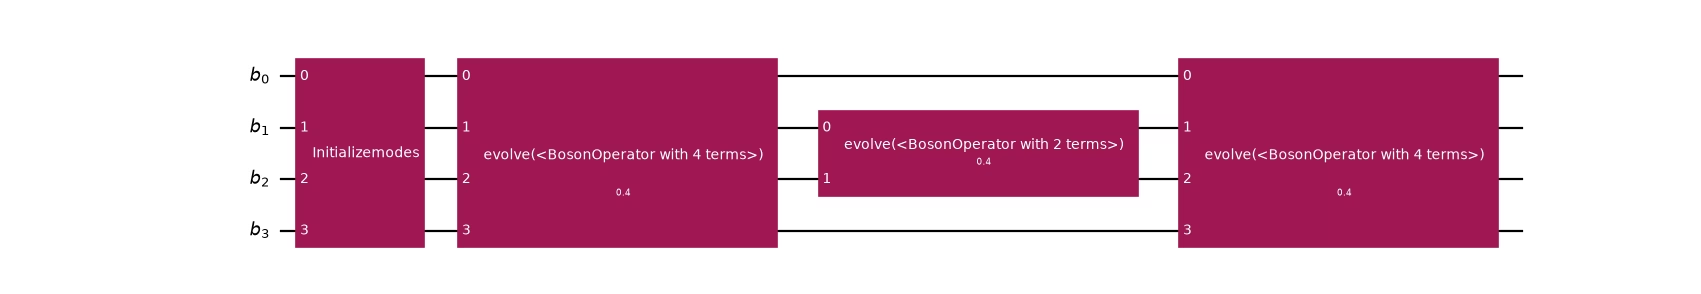
První skupina obsahuje vazby na módech 0 a 1 a na módech 2 a 3, takže její hradlo zasahuje všechny čtyři módy, stejně jako skupina místních členů. Prostřední vazba má vlastní hradlo na módech 1 a 2.
Pokud tento rozklad vynecháš, seskupení se prostě ignoruje. Která metoda dělení provádí, určuje synthesis hradla, přičemž výchozí je BosonicLieTrotter; alternativy ukazuje Syntéza hradla Evolution v bosonovém prostoru.
4. Výběr kódování v době transpilace
Tady je odměna. Stejný obvod se rozloží čtyřikrát, pod čtyřmi různými hodnotami LevelEncoding, změnou jediného argumentu. LevelSpec páruje kódování s ořezáním každého módu a následující preset z této jediné specifikace odvodí rozložení, přípravu stavu i zobrazení operátoru (viz Popis ořezání pomocí LevelSpec). Řetězec jako "gray" je přijat všude, kde je přijat LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Tato čísla odporují přirozenému odhadu. Unární kódování používají qubitů na mód oproti u kompaktních kódů a při kompaktní kódy vyhrávají v obou ohledech zároveň: méně qubitů a výrazně méně provázacích hradel. Obě unární varianty se liší v operátoru, který generují, ne v rozložení: LevelEncoding.UNARY_PROJECTED nese projektor na každém druhém qubitu módu, což z něj dělá nejnákladnější ze čtyř při vývoji, a LevelEncoding.UNARY_UNPROJECTED projektory vynechává a na one-hot podprostoru s ním souhlasí. Průvodce mappery ukazuje oba operátory vedle sebe a vysvětluje, proč Grayův kód u přeskokových členů poráží standardní binární kód (SB).
Sawaya et al. uvádějí stejné pořadí [2]:
ačkoli unární kód má tendenci vyžadovat více qubitů, ale méně operací, často je SB nebo Grayův kód efektivnější z hlediska počtu qubitů i počtu operací
Jejich závěr je, že nejlepší kód závisí na hamiltoniánu a na , což je nejsilnější argument pro to, nefixovat volbu v obvodu.
Při kódování úrovní mód zahrnuje několik qubitů, takže qubitový registr je širší než registr módů. Preset používá OccupationB2QLayout, který odvozuje šířku registru z LevelSpec. Průvodce transpilací provází fázemi, které preset spouští.
5. Ověření oproti přesné dynamice
Žádný z předchozích kroků neprokazuje, že je obvod správný. K tomu porovnej hustoty míst po vývoji s přesnou referencí vypočtenou na zakódovaném hamiltoniánu.
Referenci je třeba vypočítat ve stejném ořezaném prostoru, ve kterém obvod pracuje, protože srovnání s neořezaným výpočtem by směšovalo Trotterovu chybu s chybou ořezání, což jsou různé věci, které stojí za to oddělit (viz Ořezání Fockova prostoru).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
S těmito podklady přesný vývoj v ořezaném prostoru:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
Bosony se šíří z obsazeného konce řetězce k prázdnému a oba bosony se zachovávají:
>>> bool(np.isclose(sum(reference), 2.0))
True
Nyní obvod. Všimni si, že předchozí reference byla sestavena přímo z initial, takže obvod, který se s ní porovnává, musí obsahovat pouze vývoj, protože hradlo InitializeModes by znovu připravilo stav, který je již připraven.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
Chyba se při zdvojnásobení počtu kroků zmenší na polovinu, což je signatura součinového vzorce prvního řádu. To je důkaz, že nesrovnalost je Trotterova chyba a kódování je věrné.
Opakování pocházejí ze synthesis hradla, které Trotterizuje v bosonovém prostoru, kde seskupení ještě existuje: každý krok aplikuje každou skupinu jednou a kroky následují jeden po druhém. To je jiné, než předat LieTrotter s reps > 1 pluginu syntézy na úrovni qubitů. Tam je každá skupina již vlastním PauliEvolutionGate, takže vzorec pouze dělí členy uvnitř skupiny a skupiny nikdy nepřekládá. Skupiny navzájem nekomutují, takže zbývá jediný vnější Trotterův krok, jehož chyba se nezmenšuje, ať je reps jakkoli velké. Syntéza hradla Evolution v bosonovém prostoru oba přístupy porovnává a pokrývá vyšší řády.
Předchozí volání decompose() je zásadní. evolve() používá přesnou definici PauliEvolutionGate a součinový vzorec zcela obchází. Pokud ověřuješ proti nerozloženému obvodu, uvidíš téměř dokonalou shodu i pro záměrně špatnou syntézu. Nerozložený obvod také nutí sestavit hustý operátor , zatímco rozložený obvod aplikuje hradla jedno po druhém. Jiné simulátory mohou s hradlem zacházet jinak, takže tato kontrola závisí na simulátoru, zatímco hardware vždy potřebuje rozložený tvar.
Nakonec ústřední kontrola: fyzika nesmí záviset na tom, které kódování bylo zvoleno.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Počty qubitů, Pauliho struktury i hloubky obvodů se liší a fyzika souhlasí na deset desetinných míst. Kódování je implementační volba, a proto patří transpileru. Obě unární varianty se zde shodují, protože simulovaný stav zůstává na one-hot podprostoru; mimo něj by se lišily.
6. Ořezání je parametr konvergence
Poslední krok je specifický pro bosony. Dosud bylo vše fixováno na max_occupation = 2, tedy . Ořezání však není volná volba: je to parametr konvergence a odpovědi lze důvěřovat až poté, co se přestane měnit (viz Ořezání Fockova prostoru).
Obvod žádné ořezání nenese, takže se obvod sám při změně meze nemění: opakuje se pouze transpilace. Mění se velikost výstupu a procházení je tak levné, jako je zde, jen proto, že systém je maličký. Následující reference je přesná klasická simulace ořezané dynamiky, což je možné pro čtyři místa a roste exponenciálně s počtem qubitů. U problému mimo tento dosah není s čím přesně porovnávat a konvergenci je třeba posuzovat jinými prostředky.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
Při max_occupation = 1 () každé místo pojme nejvýše jeden boson, takže interakční člen, který potřebuje dva na místě, nemůže vůbec působit a hustoty se liší asi o . Když přidáš třetí úroveň, výsledek zachytí interakci a od max_occupation = 3 je výsledek stacionární až na strojovou přesnost: zkonvergoval.
Důvodem, proč se to zastaví u max_occupation = 2, je počet částic. Hamiltonián zachovává počet bosonů a tento stav jich obsahuje dva, takže žádné místo nemůže nikdy pojmout více než dva, ať je doba vývoje jakákoli a ať je interakce odpudivá nebo přitažlivá. Pokud vyvíjíš do místo nebo otočíš znaménko , hustoty při max_occupation = 2 a vyšším zůstanou nezměněny na .
Požadavek zvyšuje počet bosonů. Tři bosony na stejném řetězci se mezi max_occupation = 2 a 3 po stejně krátkém vývoji změní asi o a po asi o . To je tvrzení o tomto modelu a zachované veličině a je to mez pouze pro operátory zachovávající počet částic; není to obecné pravidlo, takže mez je třeba procházet, ne odhadovat.
Procházení má cenu i na straně obvodu, což přesná reference neukazuje. Stejný bosonový obvod rozložený s Grayovým kódem při každé mezi:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Každá další úroveň stojí hloubku a počet qubitů skočí vždy, když překročí mocninu dvou. Při konvergenci v tedy vyměňuješ přesnost za velikost obvodu, takže procházení je víc než numerická kontrola.
Všimni si také, že téměř správné je shoda okolností daná pozorovatelnou: hustoty míst se sotva mění, zatímco podkladový stav je kvalitativně špatně (nemá dvojnásobně obsazenou složku). Pokud jedna pozorovatelná konverguje, neprokazuje to, že zkonvergovala jiná.
Co si odnést
-
Kódování je záležitost transpilátoru. Bosonový obvod v kroku 3 nezmiňuje žádné omezení (truncation), žádné kódování ani počet qubitů. Čtyři kódování ho pak převedla na čtyři různé obvody, všechny reprodukují stejnou fyziku. Nic před transpilátorem se nemuselo měnit.
-
U bosonů to není jen pohodlné. Omezení (truncation) je konvergenční parametr, který je třeba proměřit, a žije uvnitř kódování. Obvod postavený pro pevné kódování by se musel přestavět pro každou hodnotu .
-
Seskup před mapováním a seskup kvůli hermiticitě. Jediný hopping člen není hermitovský a nelze ho exponenciovat; dvojice vazby je naopak hermitovská, a proto ji exponenciovat lze. Rozdělení rozhodni na bosonové úrovni, kde je mřížka ještě vidět. To je fyzikálně nezbytné a atribut
groupsexistuje právě proto, aby toto rozhodnutí předal dál. -
Nepředpokládej, že kódování s nízkou váhou je to levné. Při kompaktní kódy porážejí obě unární varianty zároveň v počtu qubitů i hradel a projektovaná varianta je ze všech nejdražší. Měř; bod zlomu závisí na .
-
Omezení (truncation) porušuje algebru, a to kvantifikovatelným způsobem. Jen na nejvyšší zachované úrovni, o . To je také důvod, proč mapování nekomutuje s normálním uspořádáním.
Další kroky
Tento příklad lze rozšířit dvěma směry. Pokud seznam hran řetězce nahradíš vazbami čtvercové mřížky, žádná další změna není potřeba, protože dříve definovaná funkce bose_hubbard je už na geometrii nezávislá. Vlastní kódování (například blokově unární kód, který interpoluje mezi unárním a kompaktním) se také zapojí přes stejné rozhraní MapperFnEvolutionSynthesis, které používá předvolba.
-
Principy návrhu reprezentací operátorů vysvětluje datovou strukturu operátoru za hamiltoniánem.
-
Mapování reprezentací operátorů pokrývá kódování a psaní vlastního mapperu.
-
Transpilace bosonových obvodů provádí fázemi, které předvolba spouští.
-
Syntéza hradla Evolution v bosonovém prostoru ukazuje, jak snížit Trotterovu chybu v bosonovém prostoru.
Každá uvedená hloubka platí pro abstraktní, plně propojený registr. Mapování na skutečnou konektivitu hardwaru je samostatná fáze a per-módové bloky qubitů u okupačního kódování dávají routeru poněkud jinou strukturu než jeden qubit na mód.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.