Simulace 1D Fermi-Hubbardovy dynamiky pomocí flow sets
Funkce popsané v tomto návodu jsou aktuálně dostupné pouze v Python API. Ekvivalentní funkcionalita bude v C API zpřístupněna v budoucím vydání.
Tento návod sestaví obvod pro časovou dynamiku jednorozměrného Fermi-Hubbardova modelu, od zapsání hamiltoniánu až po kontrolu vyvinutých hustot na místech. Zajímavou tuto cestu činí jediná myšlenka převzatá z frameworku flow set od Gandona a kol. [1], práce, která také motivovala TransferVertexOperator v tomto balíčku:
Místo seskupování členů hamiltoniánu po mapování fermionů na qubity je seskupit před ním, do flow sets, jednorozměrných podmnožin orientovaného grafu fermionových interakcí, jejichž transferové operátory navzájem komutují.
Tato volba určuje vše níže. Vyžaduje následující:
-
Vlastní kódování fermionů na qubity přizpůsobené flow sets, které zde spotřebuje jeden pomocný qubit (ancilla), takže počet qubitů spojených s implementací daného členu hamiltoniánu již neroste s počtem fermionových módů (jako je tomu u Jordan-Wignerova kódování (JW)).
-
Vlastní syntéza, která využívá komutativitu uvnitř každé množiny. Výsledkem je obvod, jehož dvouqubitová hloubka je konstantní vzhledem k velikosti systému, na rozdíl od lineárního růstu u trotterizace člen po členu založené na JW.
Mechanismus, který dostane tvé vlastní kódování do transpilátoru (CustomF2QLayout a MapperFnEvolutionSynthesis), se přenáší na libovolný model.
Návod k transpilaci pro fáze transpilátoru, na které se odkazuje v celém textu, a návod k mapperům pro obecný postup psaní vlastního mapperu.
Transferové operátory a flow sets
TransferVertexOperator je sestaven z vrcholových operátorů a transferových operátorů . V pojmech fermionových kreačních a anihilačních operátorů,
takže měří obsazení módu (je , když je prázdný, a , když je obsazený), zatímco přenáší fermion podél orientované hrany . Všimni si, že dva indexy nejsou zaměnitelné. První index nese kombinaci s minusem a druhý s plusem, což odlišuje od a dává hraně orientaci.
Ty splňují smíšené komutační relace. Dva transferové operátory působící na disjunktní místa komutují triviálně, protože každý je sudým součinem fermionových operátorů. Zajímavý je případ sdíleného místa. Tam oba komutují, pokud šipky přes toto místo protékají (jedna přichází, jedna odchází), a antikomutují, pokud se střetnou (obě přicházejí, nebo obě odcházejí).
Pravidlo je nejlépe vidět na obrázku. Nakreslíme-li vrcholy jako uzly a každé jako šipku z do , dostaneme orientovaný graf interakcí, zde pro čtyřmístný řetězec použitý v celém tomto návodu, který nese obě orientace každé vazby:

Projdi si pravidlo na obrázku. Podívej se například na a . Jedna šipka do místa 2 přichází a druhá z něj odchází, takže fermion proudí rovnou skrz a oba operátory komutují. Podívej se naopak na a . Obě šipky mířt do místa 2. Střetnou se a tyto dva antikomutují.
Právě to umožňuje flow sets. Vyber množinu šipek tvořících orientovanou cestu a každá dvojice se buď potkává hlavou k patě, nebo se nepotkává vůbec, takže celá množina komutuje, i když se jednotlivé operátory překrývají na sdílených místech. Evoluce pod jedinou flow set proto nemá žádnou Trotterovu chybu a, jak ukazuje krok 7, lze ji provést i s konstantní hloubkou obvodu.
1. Fermi-Hubbardův hamiltonián
1D Fermi-Hubbardův model na místech (bez spinu, otevřené okrajové podmínky) je
Podle rovnice (9) z Ref. [1] je skokový člen . Interakce je diagonální, proto se vyjadřuje přes vrcholové operátory pomocí :
Obě části se sestaví přímo jako TransferVertexOperator. Všimni si, že je uloženo jako diagonální položka (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
Vnitřní místa dostávají u koeficient , protože se vyskytují ve dvou vazbách, zatímco okrajová místa jen v jedné. Každý zde uvedený člen se vyskytuje v grafu nakresleném výše. Členy T(j,k) jsou jeho šipky a členy V(j) jeho uzly.
2. Rozdělení na flow sets
Dále označ každý člen flow set, do které patří. K tomuto účelu slouží atribut groups. Hradlo Evolution nad seskupeným operátorem se rozloží na jedno Evolution na skupinu (krok 6 to využívá), takže seskupení rozhodnuté zde na fermionové úrovni přežije až do obvodu.
Pro 1D řetězec jsou dvě skokové flow sets šipky orientované na východ () a šipky orientované na západ (). Diagonální interakční členy komutují se vším diagonálním a tvoří třetí skupinu:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
Skupiny 0 a 1 jsou dvě flow sets. Každá množina je orientovaná cesta podél řetězce, takže podle vlastnosti toku všechny členy uvnitř skupiny komutují.
Každá skupina také musí být sama o sobě hermitovská, protože součinový vzorec exponenciuje skupiny samostatně a unitární evoluci má jen hermitovský faktor. groups_are_hermitian() to potvrdí:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Stojí za to se u toho zastavit, protože obě skokové skupiny jsou jednosměrné: skupina 0 obsahuje jen členy orientované na východ a skupina 1 jen na západ. Takové rozdělení hamiltoniánu by normálně narušilo hermitovskost, protože potřebuje po boku svůj sdružený protějšek . TransferVertexOperator se problému vyhne, protože je již samo o sobě hermitovské. Je to součin dvou Majoranových operátorů (viz jeho definice v kroku 1), nikoli holé , takže jeho Jordan-Wignerův obraz nese reálný koeficient místo imaginárního. Volba této reprezentace operátoru je tedy to, co činí jednosměrnou flow set oprávněným Trotterovým faktorem.
Označení východ/západ použitá v tomto návodu jsou geometrická, s řetězcem nakresleným zleva doprava a indexy módů rostoucími tímto směrem; míří na východ a na západ. Ref. [1] je v tomto pojmenování vnitřně nekonzistentní (text a obrázky si odporují), takže tento návod záměrně nenásleduje text a ponechává označení z obrázku. Při souběžném čtení s článkem přiřazuj flow sets podle jejich Pauliho vah (1 a 3 níže), nikoli podle světových stran.
3. Napsání vlastního kódování
Část IV B z Ref. [1] klasifikuje podoby, které může mít lokální kódování fermionů na qubity při omezení na flow set. Prosté Jordan-Wignerovo kódování používá qubitů a mapuje každý skokový člen na Pauliho operátor s váhou 2. Klasifikace ukazuje, že vynaložení dalších qubitů kupuje strukturu v kódovaných operátorech.
Zde implementované kódování je konstrukce s delokalizovanou paritou z dodatku B 2 (rovnice B4 a B5), která používá jeden pomocný qubit (ancilla), tedy . Fermionová parita je delokalizována přes dvojici qubitů:
Index v posledním výrazu vynucuje přídavný qubit. Poslední vazba řetězce má , takže její padne na qubit , o jeden za posledním fermionovým módem . Tento koncový qubit je ancilla a proto je a nikoli . Stejný dosah se projevuje u , jehož leží pro na ancille.
Výhoda je patrná okamžitě; jedna celá flow set se zobrazí na součet Pauliho operátorů s váhou 1.
Předfaktory jsou dány normalizací a relativní znaménko minus mezi oběma orientacemi je dáno součinovou identitou , kterou výše uvedené Pauliho operátory splňují. Chyba v kterémkoli z nich vede k operátoru, který splňuje komutační relace, ale již nereprezentuje stejný hamiltonián, proto bys měl kódování ověřit numericky, jak je ukázáno v kroku 4.
Napsat kódování znamená napsat funkci, která mapuje jeden zobecněný transferový operátor na Pauliho řetězec; map_transfer_vertex_generators() se postará o iteraci přes členy a jejich skládání:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn očekává signaturu (operator, num_qubits) a návratovým typem musí být SparseObservable, díky čemuž je funkce přímo použitelná jako plugin transpilátoru. Viz krok 6.
Aplikací na hamiltonián z kroku 1 dostaneme kódovaný operátor na qubitech:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Je zde 14 členů ve třech tvarech: skok se stal X a ZXZ, interakce ZZ a úvodní [] je identita, která přispívá jen globální fází. Všimni si, že členy ZZ dosahují k nejbližším i druhým nejbližším sousedům; zasahuje qubity až , což je cena za delokalizaci parity.
Seskupení podle flow set odhalí asymetrii, kterou konstrukce přináší. Vypiš Pauliho váhy přítomné v každé skupině:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Flow set orientovaná na východ (skupina 0) sestává výhradně z Pauliho operátorů s váhou 1. Její časová evoluce je proto vrstva jednoqubitových rotací a nepotřebuje žádná provázací hradla, zatímco u Jordan-Wignera je každý skokový člen s váhou 2 a ta vyžaduje. Toto je výměna prostoru za čas z Ref. [1] v nejjednodušší podobě: jeden přídavný qubit promění polovinu skokového hamiltoniánu na jednoqubitové rotace.
Flow set orientovaná na západ (skupina 1) za to platí váhou tři a interakce (skupina 2) leží na váze dva, kde položka s váhou nula je identita. Nic z toho zatím není tvrzení o obvodu; co syntéza z těchto vah vytvoří, je tématem kroků 6 a 7.
4. Ověření kódování
Vlastní kódování je užitečné, jen pokud je věrné, a ručně napsané by se mělo zkontrolovat. Protože toto kódování používá qubitů, je qubitový Hilbertův prostor dvakrát větší než fermionový, takže kódovaný hamiltonián se nemůže rovnat Jordan-Wignerovu člen po členu. Obě jsou místo toho svázána isometrií.
Odkud isometrie pochází: U Jordan-Wignera je bázový stav řetězec obsazení; qubit drží . Toto kódování naopak ukládá kumulativní parity. Definuj
takže bit zaznamenává paritu všech obsazení až do místa včetně. Pro obsazení existuje takových bitů, odtud se bere ancilla. Obsazení se obnoví jako rozdíl sousedních bitů, . Obsazené místo se proto projeví jako doménová stěna mezi dvěma sousedními bity, což je důvod, proč se tomu říká kódování doménových stěn (neboli Kramers-Wannierovo). Proto také : součin dvou sousedních přečte tento rozdíl.
Zapsání tohoto zobrazení pro několik stavů zpřesňuje strukturu (všimni si, že je pevně dané, takže v obrazu leží jen polovina z stavů qubitů, a jde proto o izometrii, nikoli o unitární zobrazení):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Jeden fermion na místě 0 překlopí každou kumulativní paritu nad ním, což je právě delokalizace v praxi. Sloučením těchto sloupců do matice získáme izometrii a kódování je věrné, když oba hamiltoniány propojuje (intertwines):
To znamená, že zobrazení fermionového stavu do prostoru qubitů a jeho následný vývoj tam musí dát stejný výsledek jako nejprve vývoj ve fermionovém prostoru a zobrazení až poté.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
Propojovací vztah platí přesně, a to zvlášť pro každou množinu toků. Právě toto druhé, silnější tvrzení využívají pozdější kroky: součinový vzorec vyvíjí skupiny jednu po druhé a součin propojených faktorů je sám propojený, takže jakákoli aproximace vytvořená z těchto skupin se mezi oběma kódováními shoduje, přestože se kódování liší. Důsledkem je, že se spektra musí shodovat, přičemž každé vlastní číslo Jordan-Wignerova kódování se ve větším prostoru objeví dvakrát, jednou pro každou hodnotu neomezené globální parity:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Sestavení fermionového obvodu
Dříve než se zapojí jakékoli qubity, vyjádří se dynamika na fermionové úrovni. FermionicCircuit působí na fermionové módy, nikoli na qubity, a hradlo Evolution nad hamiltoniánem tvoří celý obvod:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

Je zde jedna neprůhledná skupina přes všechny čtyři módy a zajímavé je, na co se rozkládá. Argument synthesis říká jak: FermionicLieTrotter je součinový vzorec prvního řádu, který operátor rozdělí podle jeho groups a každou skupinu vyvíjí postupně. Rozdělení na množiny toků z kroku 2 tedy je trotterizace a jediné volání decompose() ji provede a vytvoří jedno hradlo Evolution na každou množinu toků v pořadí skupin: východ, západ a poté diagonální interakce, s 3, 3 a 8 členy.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
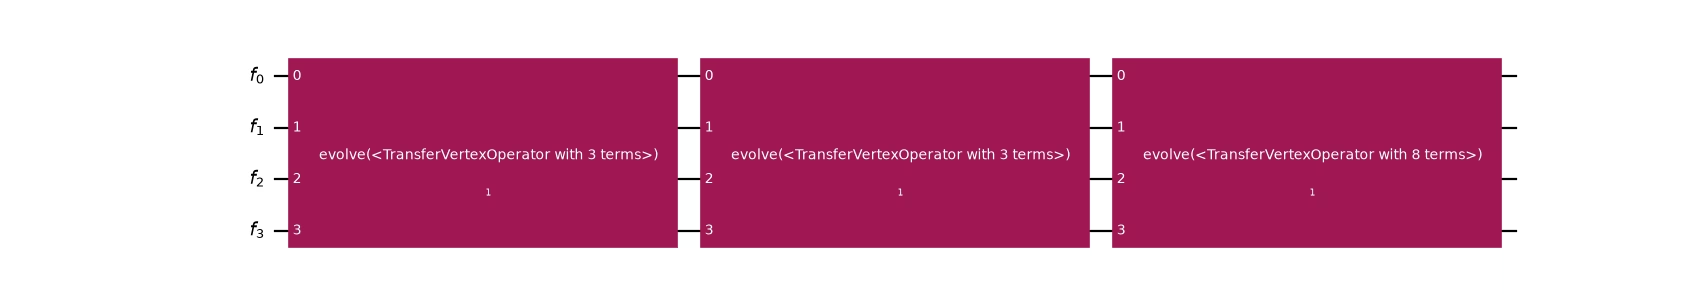
Všimni si, že se to celé odehrává ve fermionovém prostoru: žádný qubit zatím nebyl zmíněn a aproximace je už provedena. Počet Trotterových kroků proto patří také sem, jako reps, který dělí čas a opakuje celý průchod:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Devět hradel: tři množiny toků, projité třikrát, každá po třetině času. Právě toto cyklení z toho dělá trotterizaci, a ne pouhé nové rozdělení jedné skupiny. Opakování jediné skupiny by nic nepřineslo, protože po sobě jdoucí exponenciály téhož operátoru komutují, takže A(t/3) A(t/3) A(t/3) je prostě A(t). Vzorec, který skupiny čte, je může prokládat; vzorec použitý až po zobrazení to nedokáže, protože seskupení už je pryč.
Tento krok způsobuje, že na seskupení záleží. Každé vygenerované hradlo se zobrazuje a syntetizuje samostatně, takže vše dále po proudu pracuje s rozdělením určeným na fermionové úrovni. Vynechání rozkladu předá celý operátor další fázi a seskupení se ignoruje.
6. Transpilace s vlastním kódováním
Kódování je nyní připraveno k použití transpilátorem. Potřebujeme ještě dvě věci:
-
Layout. Výchozí
TrivialF2QLayoutpředpokládá jeden qubit na mód, což je v této situaci chybné.CustomF2QLayoutpřiřadí fermionový registr kQuantumRegisterjiné velikosti, a právě tak se do procesu dostávají pomocné qubity (ancilly). -
Syntézní plugin.
MapperFnEvolutionSynthesispřijímá přímo mapovací funkci, zobrazí s ní hamiltonián hradlaEvolutiona vytvoříPauliEvolutionGate, přičemž zachová konvenci . Jehoproduct_formularozhoduje, jak se toto hradlo převede na rotace. Všimni si, že jde o druhý, nezávislý součinový vzorec, který působí na qubity po zobrazení: sem se předává QiskitLieTrottera krok 7 jej nahradí vzorcem, který o množinách toků ví.
Protože každé následující srovnání tento proces znovu spouští, vyplatí se jej jednou zabalit:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Čtyři fermionové módy se staly pětiqubitovým obvodem, přičemž ancillu dodal vlastní layout.
Teď se podívejme, co výsledný obvod vlastně obsahuje. Opakovaný rozklad redukuje hradla evoluce až na U a CX, takže dvouqubitové náklady obou níže porovnávaných syntézních strategií se měří ve stejné měně: count_ops() pak uvede počet CX a depth() přijímá filtrovací funkci pro měření dvouqubitové hloubky. Všimni si, že toto reps je hloubka rozkladu, nesouvisející s počtem Trotterových kroků součinového vzorce, který se později v tomto průvodci také nazývá reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Dvacet šest hradel CX ve dvaceti třech vrstvách, takže téměř nic neběží paralelně. Proč tomu tak je, ukáže vykreslení obvodu:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
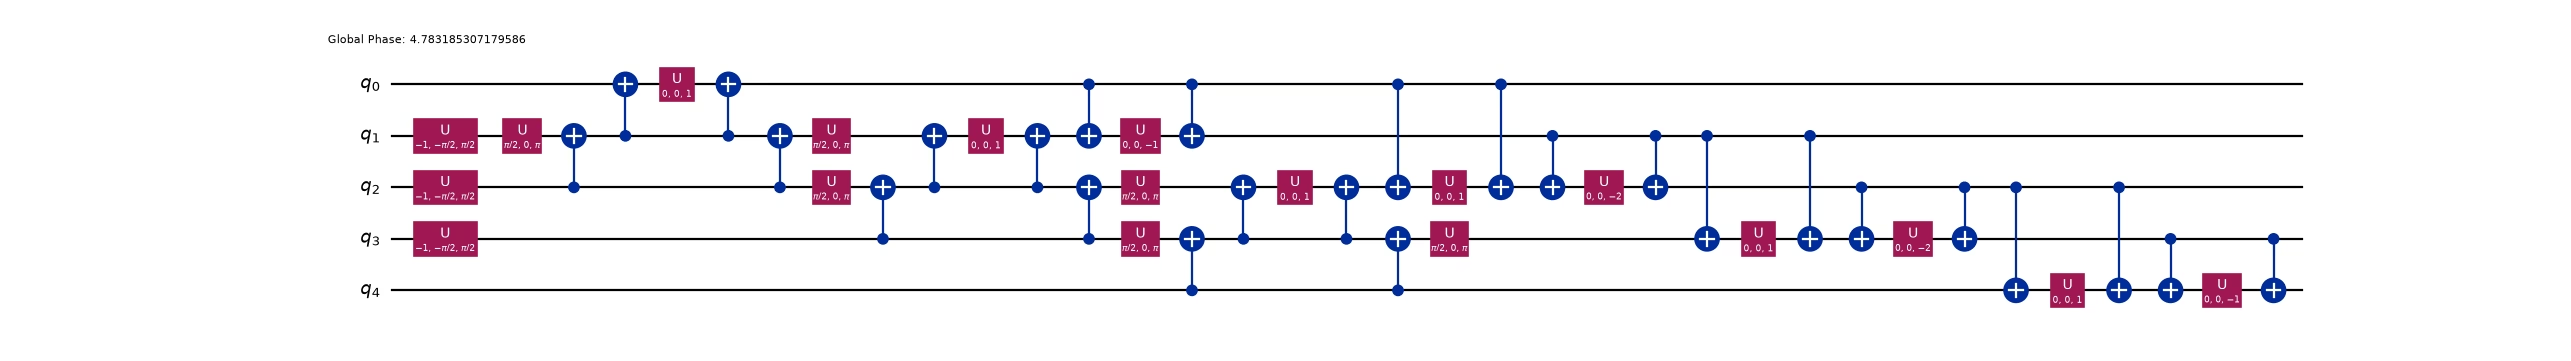
Každý člen byl zkompilován izolovaně: změna báze, žebřík CX až k jediné rotaci a poté se žebřík vrátí zpět. Množina toků o váze 1 je zadarmo; její členy jsou samostatné rotace bez žebříku okolo, ale každý člen o váze 3 stojí čtyři hradla CX a protože se žebříky vydávají sekvenčně, nic se nepřekrývá.
Seskupení tedy přežije celým procesem (tři množiny toků, tři zobrazená PauliEvolutionGate) a stále přináší téměř nic. Fermionová trotterizace z kroku 5 svou práci odvedla; plýtvá jí vzorec na straně qubitů. LieTrotter dostane množinu členů, o níž se mu nic neřekne, a každý zkompiluje izolovaně. Nemůže vědět, že navzájem komutují, a proto sériově zpracuje to, co by mohlo sdílet jednu změnu báze.
To je mezera, kterou má toto kódování zaplnit: pracují dva součinové vzorce a strukturu dosud dostal jen ten fermionový. Další krok dodá syntézu na straně qubitů, která ji využívá také.
7. Syntéza respektující množiny toků
Obnovení výhody vyžaduje sdělit syntéze na straně qubitů strukturu. Jde o oddíl IV C v Ref. [1]: protože všechny členy jedné množiny toků komutují, lze je současně diagonalizovat jediným Cliffordovým obvodem, otočit v jedné sdílené bázi a otočit zpět, místo aby se to dělalo pro každý člen zvlášť.
Pro toto kódování je Clifford jednoduchý. Konjugace řetězcem hradel CZ mezi nejbližšími sousedy zobrazí
současně pro každé . Jeden řetězec CZ promění celou množinu toků o váze 3 (západ) ve vrstvu nezávislých jednoqubitových rotací . Rozhraní EvolutionSynthesis vyžaduje pouze metodu synthesize(), a právě tu tato třída implementuje. Nenese žádný počet Trotterových kroků, protože dostává vždy jednu množinu toků a nemůže tedy rozdělit evoluci mezi množiny. Toto rozdělení patří o úroveň výš, do fermionového prostoru, kde F2FSynthesisPlugin vidí všechny najednou (viz krok 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Dva detaily snadno uniknou pozornosti. Vlastní EvolutionSynthesis musí zpřístupnit atribut preserve_order, který čte průchod high-level syntézy.
Oba pomocné nástroje vydávají svá hradla v explicitních vrstvách, nikoli v pořadí členů, protože depth() plánuje hradla co nejdříve, v pořadí, v jakém byla přidána. Jelikož všechna hradla v rámci jedné z těchto množin komutují, pořadí lze volit libovolně. Syntéza člen po členu volí pořadí špatně. Sekvenční vydávání překrývajícího se řetězce CZ hlásí hloubku, která roste s počtem qubitů, místo konstantní hloubky 2, jaké by hardware dosáhl.
Proto výše uvedená syntéza nenese žádný počet Trotterových kroků. Dostává jednu množinu toků na hradlo, takže opakování uvnitř by opakovalo v rámci množiny, místo aby cyklilo mezi množinami:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
První forma nic nepřináší: po sobě jdoucí exponenciály téhož operátoru komutují, takže A(t/2) A(t/2) je prostě A(t) a chyba zůstává na hodnotě jednoho kroku bez ohledu na to, kolik kroků se požaduje.
Počet kroků proto patří fermionovému FermionicLieTrotter z kroku 5, který čte groups a může je prokládat. Právě toto dělení práce je smyslem: fermionový vzorec rozhoduje o počtu kroků a o pořadí, a tato třída rozhoduje o tom, jak levně se každá výsledná množina realizuje.
Pro výběr pořadí jej předej do MapperFnEvolutionSynthesis.product_formula, což je argument, který přijímá flow_set_pass_manager. Nic jiného na procesu (ani na fermionovém obvodu, na kterém běží) se nemění:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
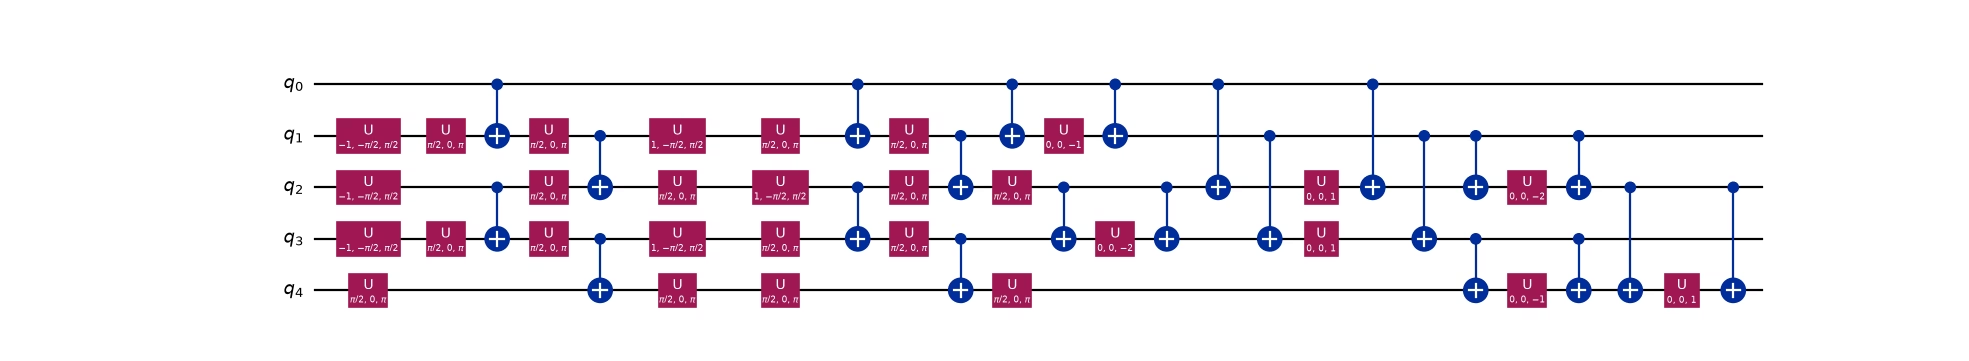
Z hloubky 23 s 26 hradly CX na hloubku 12 s 22 hradly CX. Všimni si, že je to méně provázacích hradel a téměř poloviční hloubka. Při porovnání obou obrázků není rozdíl v tom, že by hradla byla levnější, ale v tom, že se skládají na sebe. Sériové žebříky zmizely; provázací hradla nyní leží nad sebou ve sdílených vrstvách, protože celá západní množina toků se otáčí v jediné sdílené bázi a interakce se vydává ve vrstvách disjunktních dvojic.
FlowSetSynthesis porovnává vzory absolutních indexů qubitů, což je zde bezpečné jen proto, že každá množina toků tohoto hamiltoniánu zahrnuje celý registr. Fermionový součinový vzorec zúží každý faktor na módy, kterých se skutečně dotýká, takže seskupení, jehož množiny by pokrývaly jen část řetězce, by dorazilo přeznačené a výše uvedené vzory by neodpovídaly.
Oba obrázky ukazují obvod po decompose(reps=6), který vše přepíše do báze U a CX, takže hradla CZ, Rx a Rzz vydaná FlowSetSynthesis jako taková vidět nejsou. To je záměr: obě obvody tak leží ve stejné bázi, což je jediný způsob, jak jsou výše uvedené dvouqubitové počty a hloubky srovnatelné. Pozoruhodná je na těchto obrázcích struktura vrstev, nikoli označení hradel.
8. Konstantní hloubka ve velkém měřítku
Zajímavou otázkou není počet při čtyřech módech, ale to, jak škáluje. Dvě vrstvy zděného vzoru z hradel CZ s délkou řetězce nerostou, takže dvouqubitová hloubka jednoho Trotterova kroku by měla být konstantní. Měříme ji přímo na úplném Fermi-Hubbardově hamiltoniánu, daleko za hranicí toho, co lze simulovat hrubou silou:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
Dvouqubitová hloubka zůstává na 12 od čtyř módů do 100, zatímco LieTrotter roste lineárně až na 407. Množiny toků mu umožňují trochu paralelizovat v rámci procesu, ale každá množina je stále trotterizována člen po členu, takže růst je jen zpomalen, nikoli odstraněn:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Počet hradel roste lineárně u obou (je třeba aplikovat členů, což je nevyhnutelné), ale syntéza po množinách toků je aplikuje v konstantním počtu paralelních vrstev. To je výsledek konstantní hloubky z Ref. [1].
Hloubka 12 se rozděluje mezi tři množiny toků jako 0 + 4 + 8, při každé délce řetězce. Východní množina toků přispívá nulou; jsou to čisté rotace Rx. Západní množina stojí 4, ze dvou vrstev zděného vzoru CZ při vstupu a dvou při výstupu; vynecháním interakce zůstane dvouqubitová hloubka čtyři při jakékoli délce řetězce. Zbývajících osm je interakce, jejíž členy Rzz působí na nejbližší i druhé nejbližší sousedy, a proto potřebují čtyři disjunktní vrstvy, každá za dvě hradla CX. Čtyři je zde optimum: každý vnitřní qubit nese čtyři hradla Rzz (dvě k jednomu sousedovi a dvě k druhému nejbližšímu) a může se účastnit vždy jen jednoho, takže žádný rozvrh nemůže dopadnout lépe.
Dvě třetiny hloubky tvoří interakce, což ukazuje, že toto kódování vyniká u přeskoků, a tedy u dynamiky řetězce volných fermionů. Všimni si však, že interakce s přeskoky nekomutuje. Její vynechání není aproximací Fermi-Hubbardova modelu, ale jiným modelem. Kde leží rovnováha pro daný problém, stojí za prozkoumání.
9. Kontrola dynamiky
Při doménově-stěnovém zobrazení se obsazovací vzor stává řetězcem kumulativních parit, takže počáteční stav se připravuje jinak než u Jordan-Wignera. Je to snadno přehlédnutelný praktický důsledek delokalizace parity. Pomocná funkce z kroku 4 dává správné označení:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
S připraveným stavem zbývají dvě otázky, které je nejlepší klást zvlášť: počítá syntéza po množinách toků správnou věc a počítá ji levněji?
Nejprve správnost. FlowSetSynthesis a Qiskit LieTrotter dostávají stejné zakódované množiny toků ze stejné fermionové trotterizace, takže musí realizovat stejný unitární operátor až na globální fázi. Vlastní Cliffordovy obvody práci jen přeorganizují; výsledek nemění. Náhodné stavové vektory odhalí jakoukoli odchylku mnohem levněji než sestavení celého unitárního operátoru:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Obě poloviny této kontroly jsou důležité. Překryv s jednotkovým modulem na jediném stavu je nutný, ale nikoli postačující: syntéza, která by špatně určila fázi závislou na stavu, by ji stále ukázala. Požadavek stejné fáze napříč několika náhodnými stavy tuto mezeru uzavírá. Důležité je také zkontrolovat více než jednu hodnotu reps, protože to potvrzuje, že shoda přežije prokládání množin toků a neplatí jen pro jediný průchod.
Volba syntézy na straně qubitů tedy nemá žádný vliv na přesnost, což činí srovnání nákladů smysluplným. Zbývá otázka, co kódování jako celek přináší oproti samozřejmé alternativě: prostému Jordan-Wignerovi na num_sites qubitech, bez ancilly a bez vlastních Cliffordů. Mezi oběma sloupci se liší kódování i syntéza na straně qubitů, ale výše uvedená kontrola ukázala, že ta druhá výsledek ovlivnit nemůže, takže fidelity testují kódování. Oba procesy také začínají ze stejné fermionové trotterizace, takže jakýkoli rozdíl ve fidelitě by ukazoval na chybu, nikoli na kompromis. Dva sloupce jsou kódování, množiny toků proti Jordan-Wignerovi:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Nejprve si přečti sloupec fidelity: shodný na každou vytištěnou číslici, ve dvou různých Hilbertových prostorech pod dvěma různými kódováními. To je fermionová trotterizace, která prosvítá. Aproximace byla pevně stanovena v kroku 5, dříve než bylo zvoleno kterékoli kódování, takže oba obvody nesou přesně chybu vzorce prvního řádu nad třemi množinami toků, která klesá zhruba čtyřnásobně při zdvojnásobení počtu kroků.
Kódování se liší v nákladech a tento kompromis stojí za to říct otevřeně. Množina toků utratí více provázacích hradel: 22 oproti 18 při jednom kroku. Důvodem není ancilla, protože sama nenese žádné dvouqubitové hradlo. Důvodem je interakce, přesně jak varoval krok 3: delokalizace parity promění tři členy ZZ mezi nejbližšími sousedy v sedm, které zahrnují nejbližší i druhé nejbližší sousedy, a každý stojí dvě hradla CX. To je cena za zlevnění přeskoků.
V hloubce také vítězí jen těsně při této velikosti (12 oproti 14), protože čtyři módy jsou příliš málo na to, aby se asymptotika projevila. Podstatné je škálování změřené v kroku 8: hloubka 12 je konstantní, zatímco hloubka Jordan-Wignera s řetězcem roste. Při 14 módech je to už 12 oproti 34.
Výše uvedená volání decompose() jsou nezbytná, a to ze dvou nezávislých důvodů.
evolve() a Operator používají přesnou definici PauliEvolutionGate a obcházejí vlastní syntézu na straně qubitů. Ověřování proti nerozloženému obvodu hlásí dokonalou fidelitu i pro záměrně chybnou syntézu.
Totéž platí o úroveň výš, pro fermionovou syntézu. Hradlo Evolution, které se nikdy nerozloží, jde celé do fáze fermion-na-qubit, která je zobrazí bez nahlédnutí do Evolution.synthesis, takže reps by tiše nemělo žádný účinek. trotter_steps z kroku 5 tento rozklad provádí; proces, který nastavuje metodu pomocí F2FSynthesis, získá stejné rozvinutí z tohoto průchodu.
Jako závěrečná křížová kontrola musí hustoty míst spočtené v zakódovaném prostoru reprodukovat výsledek Jordan-Wignera. Tato kontrola se týká kódování, nikoli obvodu, takže do ní nevstupuje žádná Trotterova aproximace. Oba časové vývoje se počítají přesně, maticovou exponenciací příslušných hamiltoniánů. Jakákoli odchylka by tedy ukazovala na kódování, nikoli na součinový vzorec:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Hustoty se shodují na deset desetinných míst.
Co si odnést
-
Seskupuj před zobrazením. Množiny toků jsou definovány na orientovaném fermionovém grafu interakcí, takže seskupení se volí, dokud je struktura problému ještě k dispozici. Atribut
groupsje přenese do obvodu, kde jedinédecompose()je promění v jedno hradloEvolutionna množinu toků. -
Ancilly kupují strukturu. Jeden qubit navíc promění celou množinu toků v Pauliho operátory o váze 1, jejichž evoluce nepotřebuje žádná provázací hradla. Ref. [1] pozoruje tento kompromis obecně. Větší poměry qubitů k fermionům umožňují mělčí obvody evoluce.
-
Vlastní kódování je jedna funkce. Zobraz jediný zobecněný transferový operátor na Pauliho řetězec; zbytek udělají
map_transfer_vertex_generators()aMapperFnEvolutionSynthesis. -
Samotné zobrazení a seskupení nestačí. Rozdělení evoluce po množinách toků jen zpomalilo lineární růst hloubky; syntéza každé množiny člen po členu stále zahodila skutečnost, že její členy komutují. Teprve dodání
EvolutionSynthesisrespektující množiny toků učinilo hloubku konstantní. Vlastní kódování, seskupení a vlastní syntéza se doplňují: potřeba jsou všechny tři. -
Dva součinové vzorce, dvě úlohy.
FermionicLieTrotterstanoví aproximaci ve fermionovém prostoru, kde je seskupení ještě viditelné, takže samo určuje Trotterovu chybu a počet kroků.EvolutionSynthesisna straně qubitů pak rozhoduje jen o tom, jak levně se každá množina realizuje: krok 9 potvrzuje, že obě volby dávají stejný unitární operátor. Oddělení obou je to, co umožňuje ladit přesnost a náklady nezávisle. Viz Syntéza hradla Evolution ve fermionovém prostoru. -
Ověřuj. Kódování, které splňuje komutační relace, může stále reprezentovat jiný hamiltonián, pokud je chybný prefaktor nebo znaménko. Kontrola propojovacího vztahu (nebo, levněji, spektra) to odhalí.
Výše uvedený FlowSetSynthesis je záměrně napsán pro toto kódování na 1D řetězci. Porovnává konkrétní Pauliho označení, která kódování produkuje, a na cokoli jiného vyhodí chybu, místo aby tiše sklouzl k obecnému součinovému vzorci. Obecná implementace má dvě poloviny. Čtení struktury množin toků z groups operátoru je to, co už dělá F2FSynthesisPlugin pro evoluci. Odvození diagonalizujícího Cliffordova obvodu ze stabilizátorové grupy, jak je popsáno v oddílu IV C Ref. [1], je polovina, která zůstává specifická pro kódování.
Delokalizace parity také způsobuje, že interakční člen má váhu 2 místo toho, aby byl diagonální v jednotlivých qubitech, což je protějšek nákladů levnějších přeskokových členů.
Dále: dvě dimenze
Vše výše je jednorozměrné, a to záměrně. Na řetězci jsou množiny toků pouze dvě orientace šipek a kódování potřebuje jedinou ancillu. Žádné z těchto zjednodušení ve dvou dimenzích nepřežije, a právě tam jsou potřeba lokální kódování.
Na rovinné mřížce je množina toků orientovaná cesta (nebo sjednocení vrcholově disjunktních orientovaných cest) grafem interakcí a nalezení malé množiny takových cest, která pokryje každou hranu, se stává samostatným kombinatorickým problémem, a ne dvouřádkovou klasifikací. Kódování také mění charakter; místo jediné ancilly pro celý řetězec přidávají jednu na místo mřížky nebo buňku. Verstraete-Cirac páruje každé fermionové místo s vlastním pomocným qubitem, tedy s poměrem qubitů k módům , zatímco Derby-Klassen umisťuje jeden do středu každé liché plakety, s poměrem . Rozložení registru pak má skutečnou dvourozměrnou strukturu a stabilizátorová grupa, na kterou je třeba promítat, už není triviální. Zakódovaný hamiltonián je věrný jen na podprostoru, což mění přípravu stavu i ověřovací postup z kroku 4.
Části, které tento průvodce staví, jsou ty, které se přenášejí: CustomF2QLayout pro registr, jehož velikost se liší od počtu módů, map_transfer_vertex_generators() pro samotné kódování, MapperFnEvolutionSynthesis pro zapojení do transpilátoru a vlastní EvolutionSynthesis, aby se struktura množin toků vyplatila. Liší se jen kódování a rozklad na množiny toků.
Průvodce 2D množinami toků navazuje zde a probírá Verstraete-Ciracovo kódování na čtvercové mřížce: čtyři množiny toků, Cliffordův obvod hloubky 2 pro každou a stabilizátorovou projekci, kterou ověření poté potřebuje.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.