Potlačení a přizpůsobení chyb
Potlačení chyb může označovat jakoukoli techniku, která předjímá a snaží se předejít určitým typům šumu a chyb. Nejsnadněji se to vysvětluje na konkrétních příkladech, je však třeba mít na paměti, že tyto metody nejsou omezeny jen na zde uvedené příklady a neustále se zkoumají nové metody. Někdy není možné chyby potlačit, ale je možné ovlivnit způsob, jakým se hromadí. Pokud dokážeme zpomalit hromadění chyb, mohli bychom to popsat jako potlačení celkové chyby, přesněji se to však chápe jako přizpůsobení šumu (noise tailoring). V této lekci se budeme věnovat klasickým příkladům potlačení chyb (dynamické odpojování) a přizpůsobení/tvarování šumu (Pauliho twirling).
Video doprovázející tuto lekci bude spuštěno v příštích několika dnech a bude zde vloženo.
Dynamické odpojování
Začněme velmi jednoduchým stavem na jediném qubitu a zaveďme jednoduchý model šumu. To nestačí k úplnému vysvětlení dynamického odpojování, ale poskytuje nám to jasný příklad. Předpokládejme, že máme qubit připravený do superpozičního stavu pomocí Hadamardova hradla:
Tento stav je znázorněn na Blochově sféře, jak je vidět níže vlevo. V ideálním případě s nulovým šumem by tento qubit zůstal v tomto stavu až do provedení další operace. Z předchozí lekce však víme, že to není to, co pozorujeme. Šum způsobuje degradaci kvantové informace.
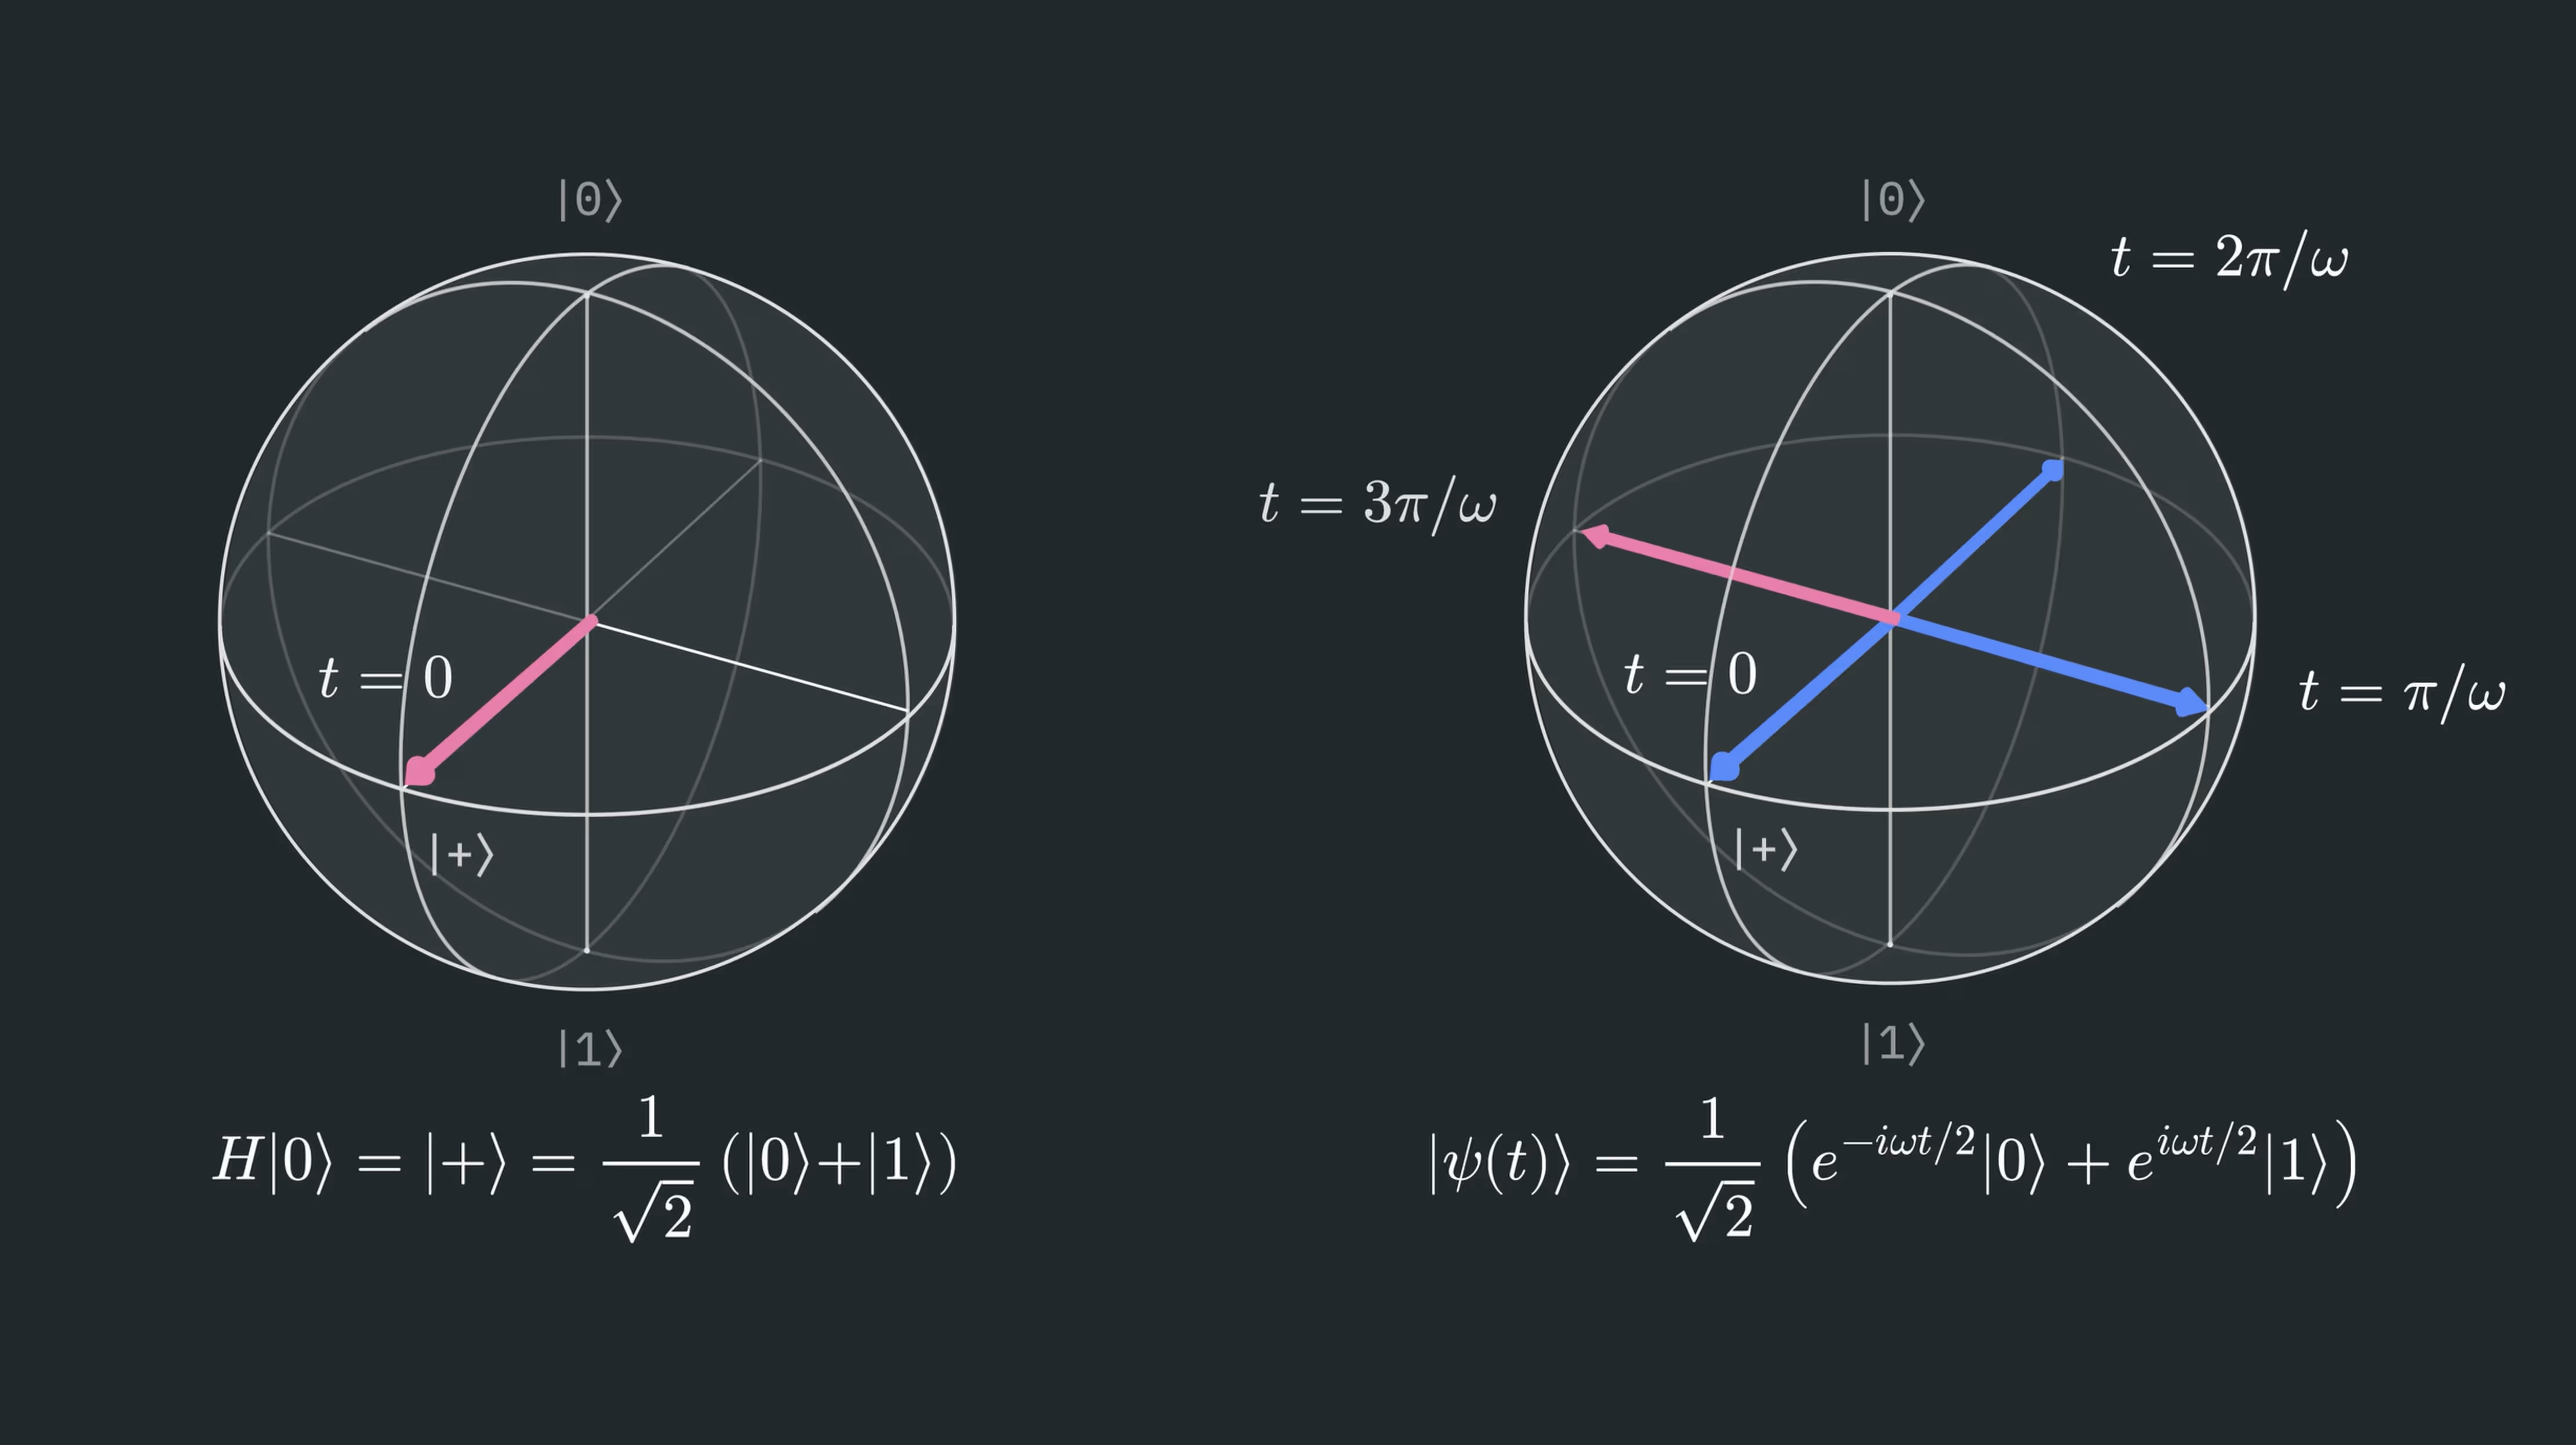
Šum nebo vazba na okolí mohou způsobit změnu relativní fáze mezi bázovými stavy. To znamená, že pravděpodobnosti a se nemění, protože se nemění absolutní hodnoty jejich koeficientů. Mění se však fáze amplitud, což mění jejich reálné a imaginární složky. Abychom tuto diskusi zkonkretizovali, uvažujme jeden typ interakce, který to může způsobit: vazbu na magnetické pole orientované ve směru Z: .
Uvažujme, co se stane se stavem s plynoucím časem:
Zde jsme využili skutečnost, že magnetické pole ve směru Z způsobuje precesi kolem osy Z s frekvencí , která závisí na efektivním magnetickém momentu a intenzitě magnetického pole. Podrobnosti jsou méně důležité než skutečnost, že tato interakce způsobuje vývoj kolem osy Z, což vede k opačnému hromadění fáze pro oba výpočetní bázové stavy. Aplikováním tohoto operátoru na každý člen v zjistíme následující:
Tato časově závislá fáze odpovídá precesi kolem osy Z v obraze Blochovy sféry. To je znázorněno v pravé polovině obrázku výše.
Kdybychom věděli, že tato interakce probíhá řízeným způsobem, mohli bychom ji předpovědět. Pro modelování tohoto typu šumu místo toho uvažujeme rozdělení možných intenzit magnetického pole, z nichž každá nastává s určitou klasickou pravděpodobností (jiné zdroje šumu by bylo třeba modelovat jinak). Musíme uvažovat, co se stane, když existuje nenulová klasická pravděpodobnost, že se stav vůbec neotočil, a také určitá pravděpodobnost, že se otočil o malé množství, nebo dokonce o velké množství. Toto rozdělení možných rotací je důvodem rozostření stavu na obrázku Blochovy sféry níže. Pokud je tohoto defázujícího šumu více, fáze bude méně dobře definovaná. V limitě silného defázování se qubit stává zcela defázovaným, což odpovídá ztrátě kvantové koherence uložené ve stavu.
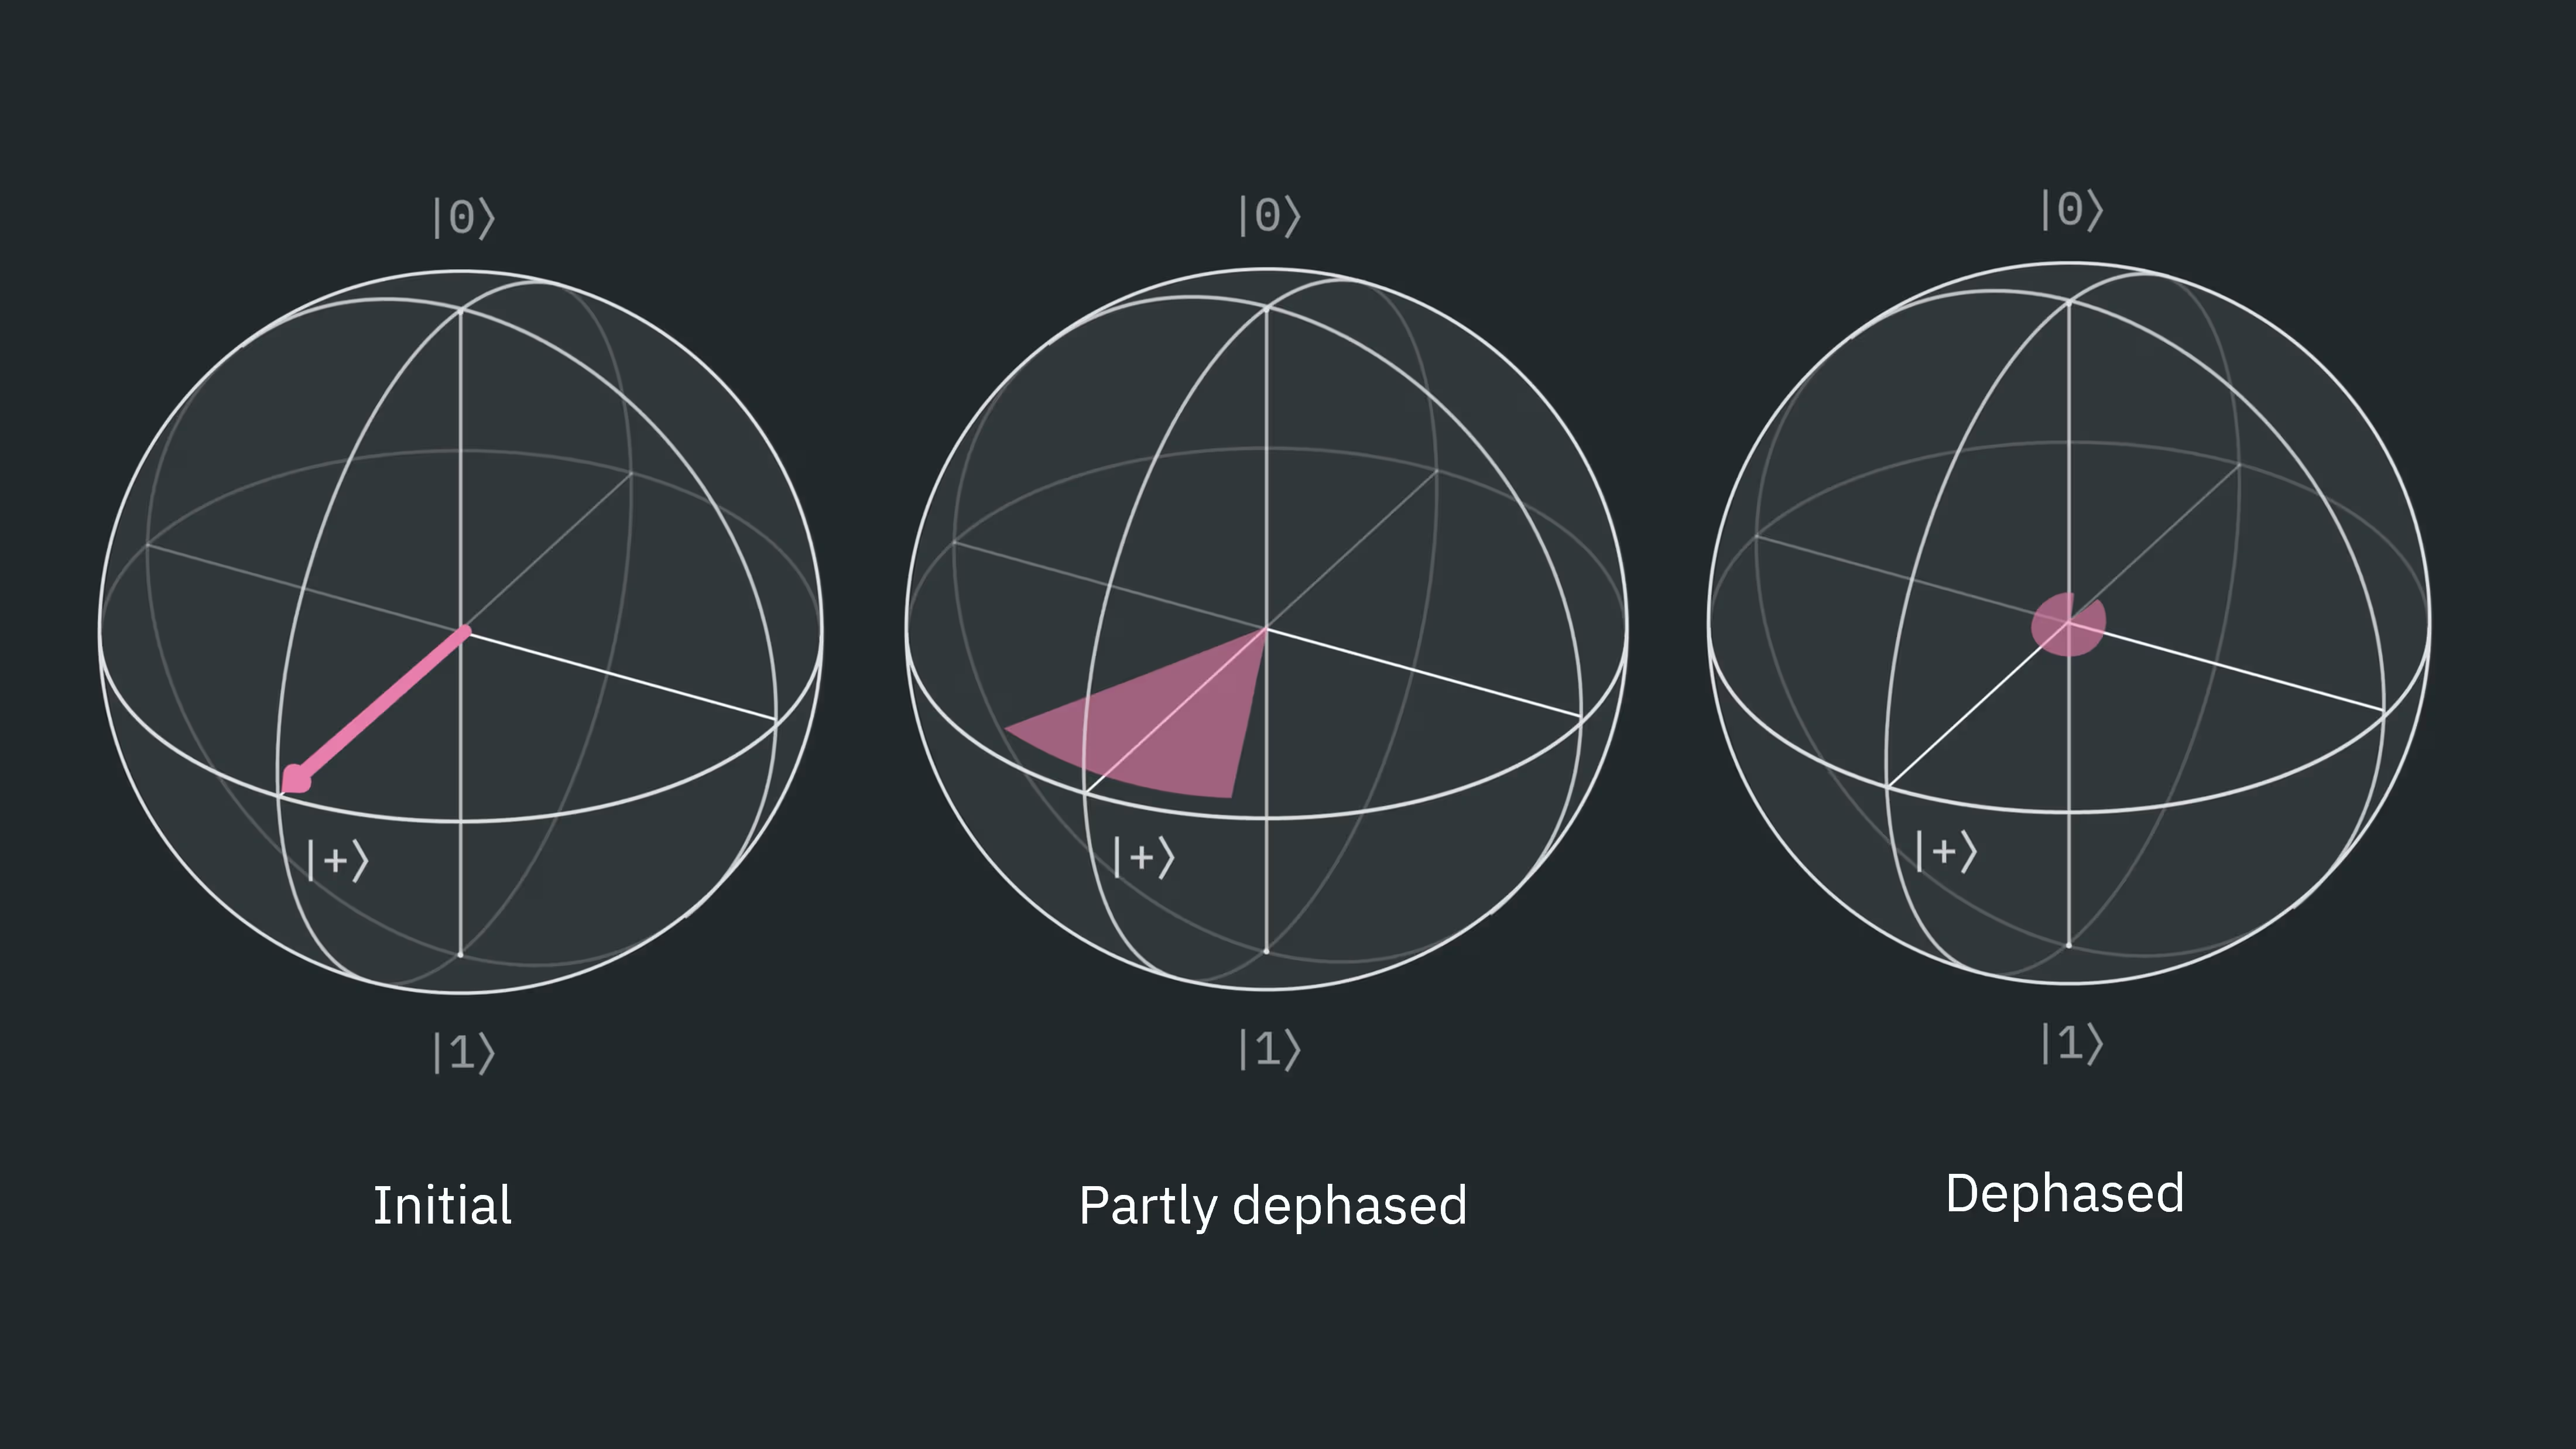
V experimentu samozřejmě nemáme tušení, jaká náhodná vazba nastane. Co s tím můžeme dělat?
Předpokládejme, že vazba na okolí zůstává přibližně konstantní v časovém intervalu . Uvažujme, co by se stalo, kdybychom postupovali podle tohoto předpisu:
-
Nechte fázi měnit se po dobu
-
Aplikujte hradlo X na qubit
-
Nechte stejnou vazbu na okolí působit po další dobu
-
Aplikujte druhé hradlo X
Po počátečním časovém vývoji bychom měli přesně stav uvedený výše. Aplikováním prvního hradla X dostaneme:
Nyní, když uplyne druhý interval , dochází ke stejné interakci. Ale nyní jsou amplitudy spojeny s opačnými vlastními stavy Z, což znamená, že se znaménko rotace kolem osy Z obrátilo. Po dalším časovém vývoji systému o máme stav:
A dosazením dostaneme:
Aplikování posledního hradla X v tomto případě nic nedělá, ale obecně je nezbytné:
Obnovili jsme původní kvantový stav včetně jeho relativní fáze. Tento proces je obzvláště jednoduchým příkladem dynamického odpojování.
Obecněji řečeno, dynamické odpojování (DD) spočívá ve vkládání některých jednoqubitových hradel za účelem snížení vlivu interakcí se systémy mimo qubit (jeho odpojení od okolí). Úplné přeostření všech možných fázových historií zpět do původního stavu, jak je znázorněno výše, je poněkud idealizované, přesto je to možný scénář. Pojďme si probrat, kdy je DD užitečné a jaká existují úskalí.
Prověřte své porozumění
V textu výše jsme prošli účinkem DD sekvence XX na počáteční stav . Ověřte, zda stejné výše uvedené kroky vrátí i stav zpět do jeho počátečního stavu za stejných předpokladů pomalu se měnícího magnetického pole ve směru z.
Odpověď
Po počátečním časovém vývoji bychom měli přesně stav uvedený výše. Aplikováním prvního hradla X dostaneme:
Nyní, když uplyne druhý interval , dochází ke stejné interakci. Ale nyní jsou amplitudy spojeny s opačnými vlastními stavy Z, což znamená, že se znaménko rotace kolem osy Z obrátilo. Po dalším časovém vývoji systému o máme stav:
A dosazením dostaneme
Aplikováním posledního hradla X dostaneme:
Kdy použít DD
Prvním a nejzřejmějším úskalím je to, že jsme v našem pojednání předpokládali čistě defázující kanál. Interakce v reálném světě obvykle vytvářejí směs defázování a dalších mechanismů chyb. Ve výše uvedeném pojednání jsme se rozhodli aplikovat konkrétně hradla X. To se v dynamickém odpojování označuje jako sekvence XX. Tato konkrétní sekvence je vhodná pro čistě defázující chyby. Existují však i jiné sekvence, které mohou být obecněji použitelné, jako XY4 (znázorněná na schématu obvodu níže) a složitější XY8.

Dalším úskalím je, že dynamické odpojování přidává jednoqubitová hradla, což může přidat jednoqubitové chyby v důsledku nedokonalosti hradel nebo dokonce přeslechů (crosstalk). Tyto míry chyb jednoqubitových hradel jsou obvykle mnohem nižší než chyby vícequbitových hradel, takže to obvykle není zásadní problém, ale je třeba na to pamatovat, pokud mnoho qubitů využívá DD mnohokrát v celém vašem obvodu.
DD je užitečné, když má vnější vazba čas ovlivnit stav qubitu. Protože qubity jsou pečlivě dobře izolovány a vnější vazby by měly být slabé, tento typ šumu je nejvíce patrný, když qubit stojí nečinně po dlouhou dobu. Pro krátké doby nečinnosti může mít DD za následek přidání chyb jednoqubitových hradel při potlačení jen velmi malého šumu; věrnost vašeho obvodu se tak ve skutečnosti může snížit.
Klíčové poznatky: Používejte dynamické odpojování, když qubity zůstávají nečinné po dostatečně dlouhou dobu, a věnujte pozornost typu použité DD sekvence.
Dynamické odpojování pomocí Qiskit
Prozkoumejme použití DD tím, že se podíváme na případ několika qubitů připravených ve stavu , které pak dlouho zůstávají nečinné. Při absenci chyb by příprava vícequbitového stavu a následná aplikace Hadamardova hradla před měřením (čímž se měří v bázi X) měla vždy vést k výsledku 0. Se šumem bude výsledek měření 0 jen ve zlomku případů, nikoli se 100% pravděpodobností. Vypočítáme průměrnou střední hodnotu X napříč více qubity. To znamená, že nás zajímá následující:
kde s operátorem X na -té pozici zprava a je stav celého systému.
Tento obvod obsahuje záměrná zpoždění, což je pro benchmark poněkud umělé. U reálných obvodů je však velmi běžné, že obsahují qubity, které jsou během části provádění nečinné. Můžete si to představit jako zjednodušený model složitějšího obvodu, ve kterém některé qubity zůstávají po část výpočtu nečinné. Tento typ benchmarkingu založený na vývoji stavů se často označuje jako Ramseyho benchmarking.
Začneme načtením potřebných balíčků a konfigurací služby.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Nyní definujeme několik pomocných funkcí. Nejprve se chceme věnovat otázce dlouhých dob nečinnosti. Co přesně znamená „dlouhý“ v tomto kontextu? Mohli bychom prostě uvádět dobu nečinnosti v mikrosekundách. Je však užitečné vědět, kolik dvouqubitových hradel by mohlo být provedeno během stejného intervalu. Díky tomu doby nečinnosti přímočařeji vypovídají o hloubce obvodu, kterou by bylo možné provést za stejnou dobu. První pomocná funkce získá dvouqubitové hradlo nativní pro backend a určí dobu trvání tohoto hradla.
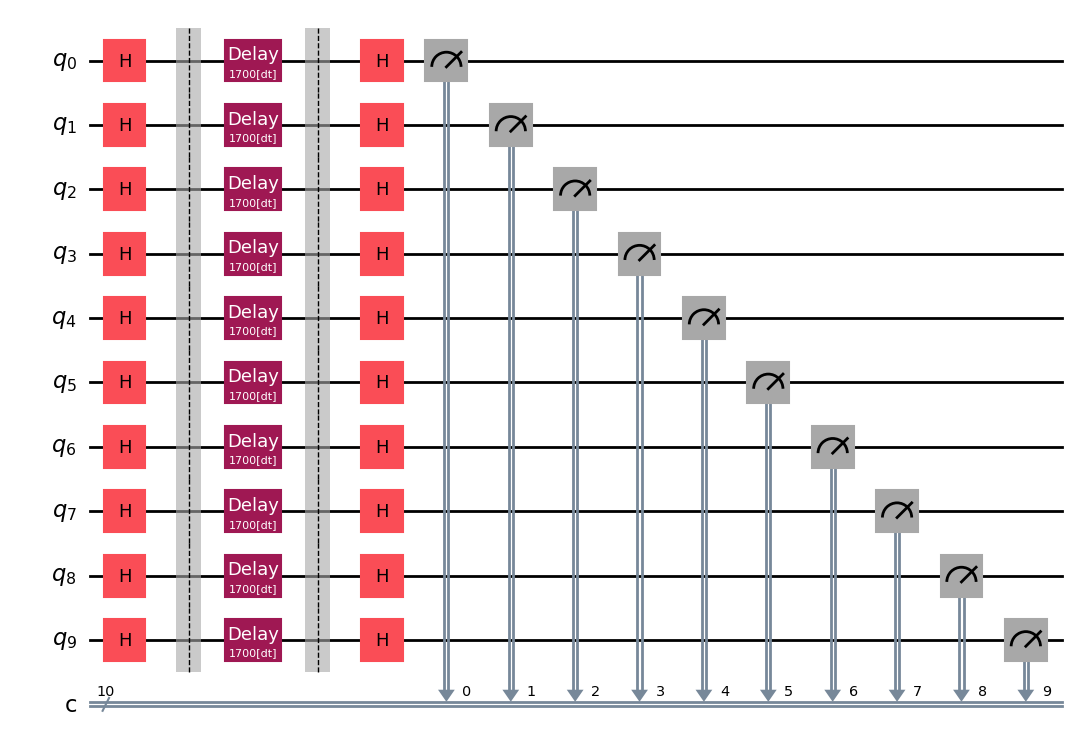
Druhá funkce jednoduše vytvoří Ramseyho obvod (obvod s qubity ve stavu ), implementuje zpoždění, otočí pomocí hradla H a poté provede měření. Připomeňme, že Hadamardovo hradlo (H) zobrazuje na , takže naměření v bázi Z po Hadamardově hradle odpovídá tomu, že qubit byl bezprostředně před Hadamardovým hradlem ve stavu .
Naše poslední funkce převádí surové počty výsledků měření 0 a 1 na střední hodnotu X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Nyní specifikujeme podrobnosti našeho testu, včetně počtu qubitů a sekvence hradel, která se má použít v DD (v tomto případě XX). Zvlášť si všimněte, že nastavujeme úroveň optimalizace na nulu. V praxi byste často zvolili vyšší úroveň optimalizace; zde používáme úroveň 0, abychom zajistili, že účinky chyb, na které DD cílí, zůstanou viditelné. Nakonec určíme charakteristický čas pro dvouqubitová hradla na tomto backendu a vypíšeme některé relevantní časy.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Nyní sestavíme naše obvody a přeložíme (transpile) je pro náš zvolený backend.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Měli bychom vizualizovat alespoň jeden obvod, abychom se ujistili, že jsme obvod naprogramovali s požadovanými stavy a zpožděními. Může být jednodušší vizualizovat obvod před transpilací qc, nebo si můžete zkontrolovat přeložený obvod qc_isa.
qc.draw("mpl")
Provedení
Konečně jsme připraveni provést spuštění na hardwaru. Používáme Sampler k získání mnoha měření každého qubitu a použijeme jej dvakrát: jednou s explicitně vypnutým DD a jednou se zapnutým DD s použitím sekvence hradel XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Můžeme extrahovat počty z jednotlivých obvodů.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Následné zpracování
Nyní máme počty z měření, ale chceme je převést na střední hodnotu X a poté tyto střední hodnoty zprůměrovat přes všechny použité qubity, abychom se dozvěděli o zachování fázové informace. K tomu použijeme naši dříve definovanou funkci counts_to_x_expectations.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Nakonec si vykresleme naše výsledky.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
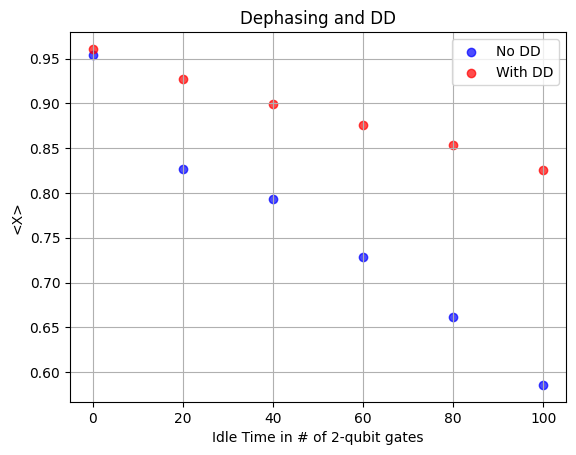
Jak vidíte, bez explicitního zpoždění jsou střední hodnoty skutečně blízko 1, což bychom očekávali, pokud by byla zachována veškerá fázová informace. Kdyby byla veškerá fázová informace ztracena, neexistovala by žádná preference, aby konečná rotace vedla spíše k než k , a průměrná střední hodnota by se blížila nule. V datech vidíme, že s rostoucí dobou zpoždění průměrná střední hodnota X klesá a začíná se blížit nule. Všimněte si, že DD zde bylo velmi účinné; střední hodnoty s DD jsou obvykle o více než 20 % lepší (blíže k 1) než hodnoty bez DD. Všimněte si však také, že první zpožděný datový bod odpovídá zpoždění zhruba ekvivalentnímu 100 operacím dvouqubitových hradel. To podtrhuje skutečnost, že DD je nejužitečnější, když qubity zůstávají nečinné po relativně dlouhou dobu.
Prověřte své porozumění
Pokud na stejný obvod jako předtím aplikujeme DD s použitím XY4, očekáváte, že to povede k výsledkům mnohem lepším, mnohem horším, nebo přibližně stejným jako DD s použitím XX? Vysvětlete.
Odpověď
Přibližně stejné, možná mírně horší. Obvod, který jsme použili, měl stavy otočené do roviny XY. Tento stav ukládá informaci především ve své fázi, díky čemuž je obzvláště citlivý na defázující chyby spíše než na relaxaci T1. XY4 by mohlo pomoci proti širší škále chyb, ale XX je již optimalizováno tak, aby pomohlo obvodu, který používáme. XY4 by mohlo být stejně dobré, ale nepřidalo by nic podstatného, nebo by skutečnost, že XY4 obsahuje více hradel, mohla umožnit dalším chybám hradel mírně zhoršit výsledky.
Poslední výsledek použil nejjednodušší sekvenci hradel DD XX. Podívejme se, jak implementovat složitější sekvenci XY4. Sampler definujeme v další sekci.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
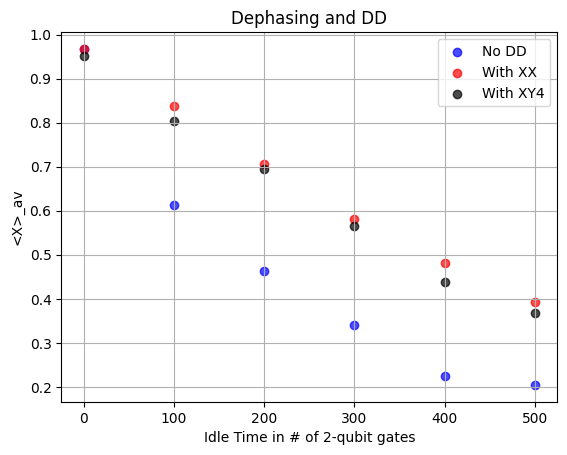
Zde vidíme, že XY4 se znatelně neliší od XX. Kvůli dalším hradlům v sekvenci XY4 může být velmi mírně horší, ale důležitější je, že jsme již vysvětlili, proč by XX mělo požadovaný účinek při zachování fáze konkrétně pro stav jako . Není důvod se domnívat, že by pro takový počáteční stav jiná sekvence zlepšila výsledky.
Prověřte své porozumění
Ověřte, že sekvence XY4 ponechává stav beze změny až na globální fázi.
Odpověď
Pauliho twirling
Měli bychom začít poznámkou, že Pauliho twirling se často nepoužívá jako technika potlačení chyb, ale jako technika tvarování chyb: způsobuje, že se šum/chyby chovají jinak, někdy předvídatelněji, aby umožnily jiné metody. Ačkoli Pauliho twirling chybám nezabraňuje, může zabránit jejich koherentnímu hromadění.
V kvantovém obvodu se sčítá více různých zdrojů chyb. Chyby se mohou sčítat různými způsoby, zejména koherentně a nekoherentně. Koherentní hromadění chyb znamená, že šum nebo nedokonalé implementace mají tendenci hnát chyby stejným směrem napříč více vrstvami a hradly. Příkladem by byla koherentní přerotace při aplikaci rotačního hradla.
Uvažujme ideální rotační hradlo, jako je , které otáčí kolem osy X přesně o . Implementace hradla samozřejmě není dokonalá a skutečná rotace může být pro jednu implementaci , a dokonce se může stát, že má vždy stejné znaménko a případně podobnou velikost napříč mnoha aplikacemi . Opakovaná aplikace rotačních hradel tak může vést ke koherentnímu hromadění těchto mnoha přerotací (nebo podrotací) .
Nekoherentní hromadění chyb je pravým opakem: chyby v náhodných směrech s náhodnými znaménky, takže chyby v různých vrstvách vždy neinterferují aditivně, ale někdy se ruší nebo se sčítají v kvadratuře. Nekoherentní chyby se zjevně hromadí pomaleji, pokud jde o celkový vliv na stav qubitu. Ilustrační diagram toho je znázorněn na obrázku níže. Jde o zjednodušení. Skutečné kvantové chyby nejsou omezeny na dvourozměrný kartézský prostor; ne všechny příspěvky chyb budou mít stejnou velikost a existují další komplikace. Intuice takového obrázku je však užitečná: koherentní chyby se obvykle hromadí rychleji než nekoherentní.
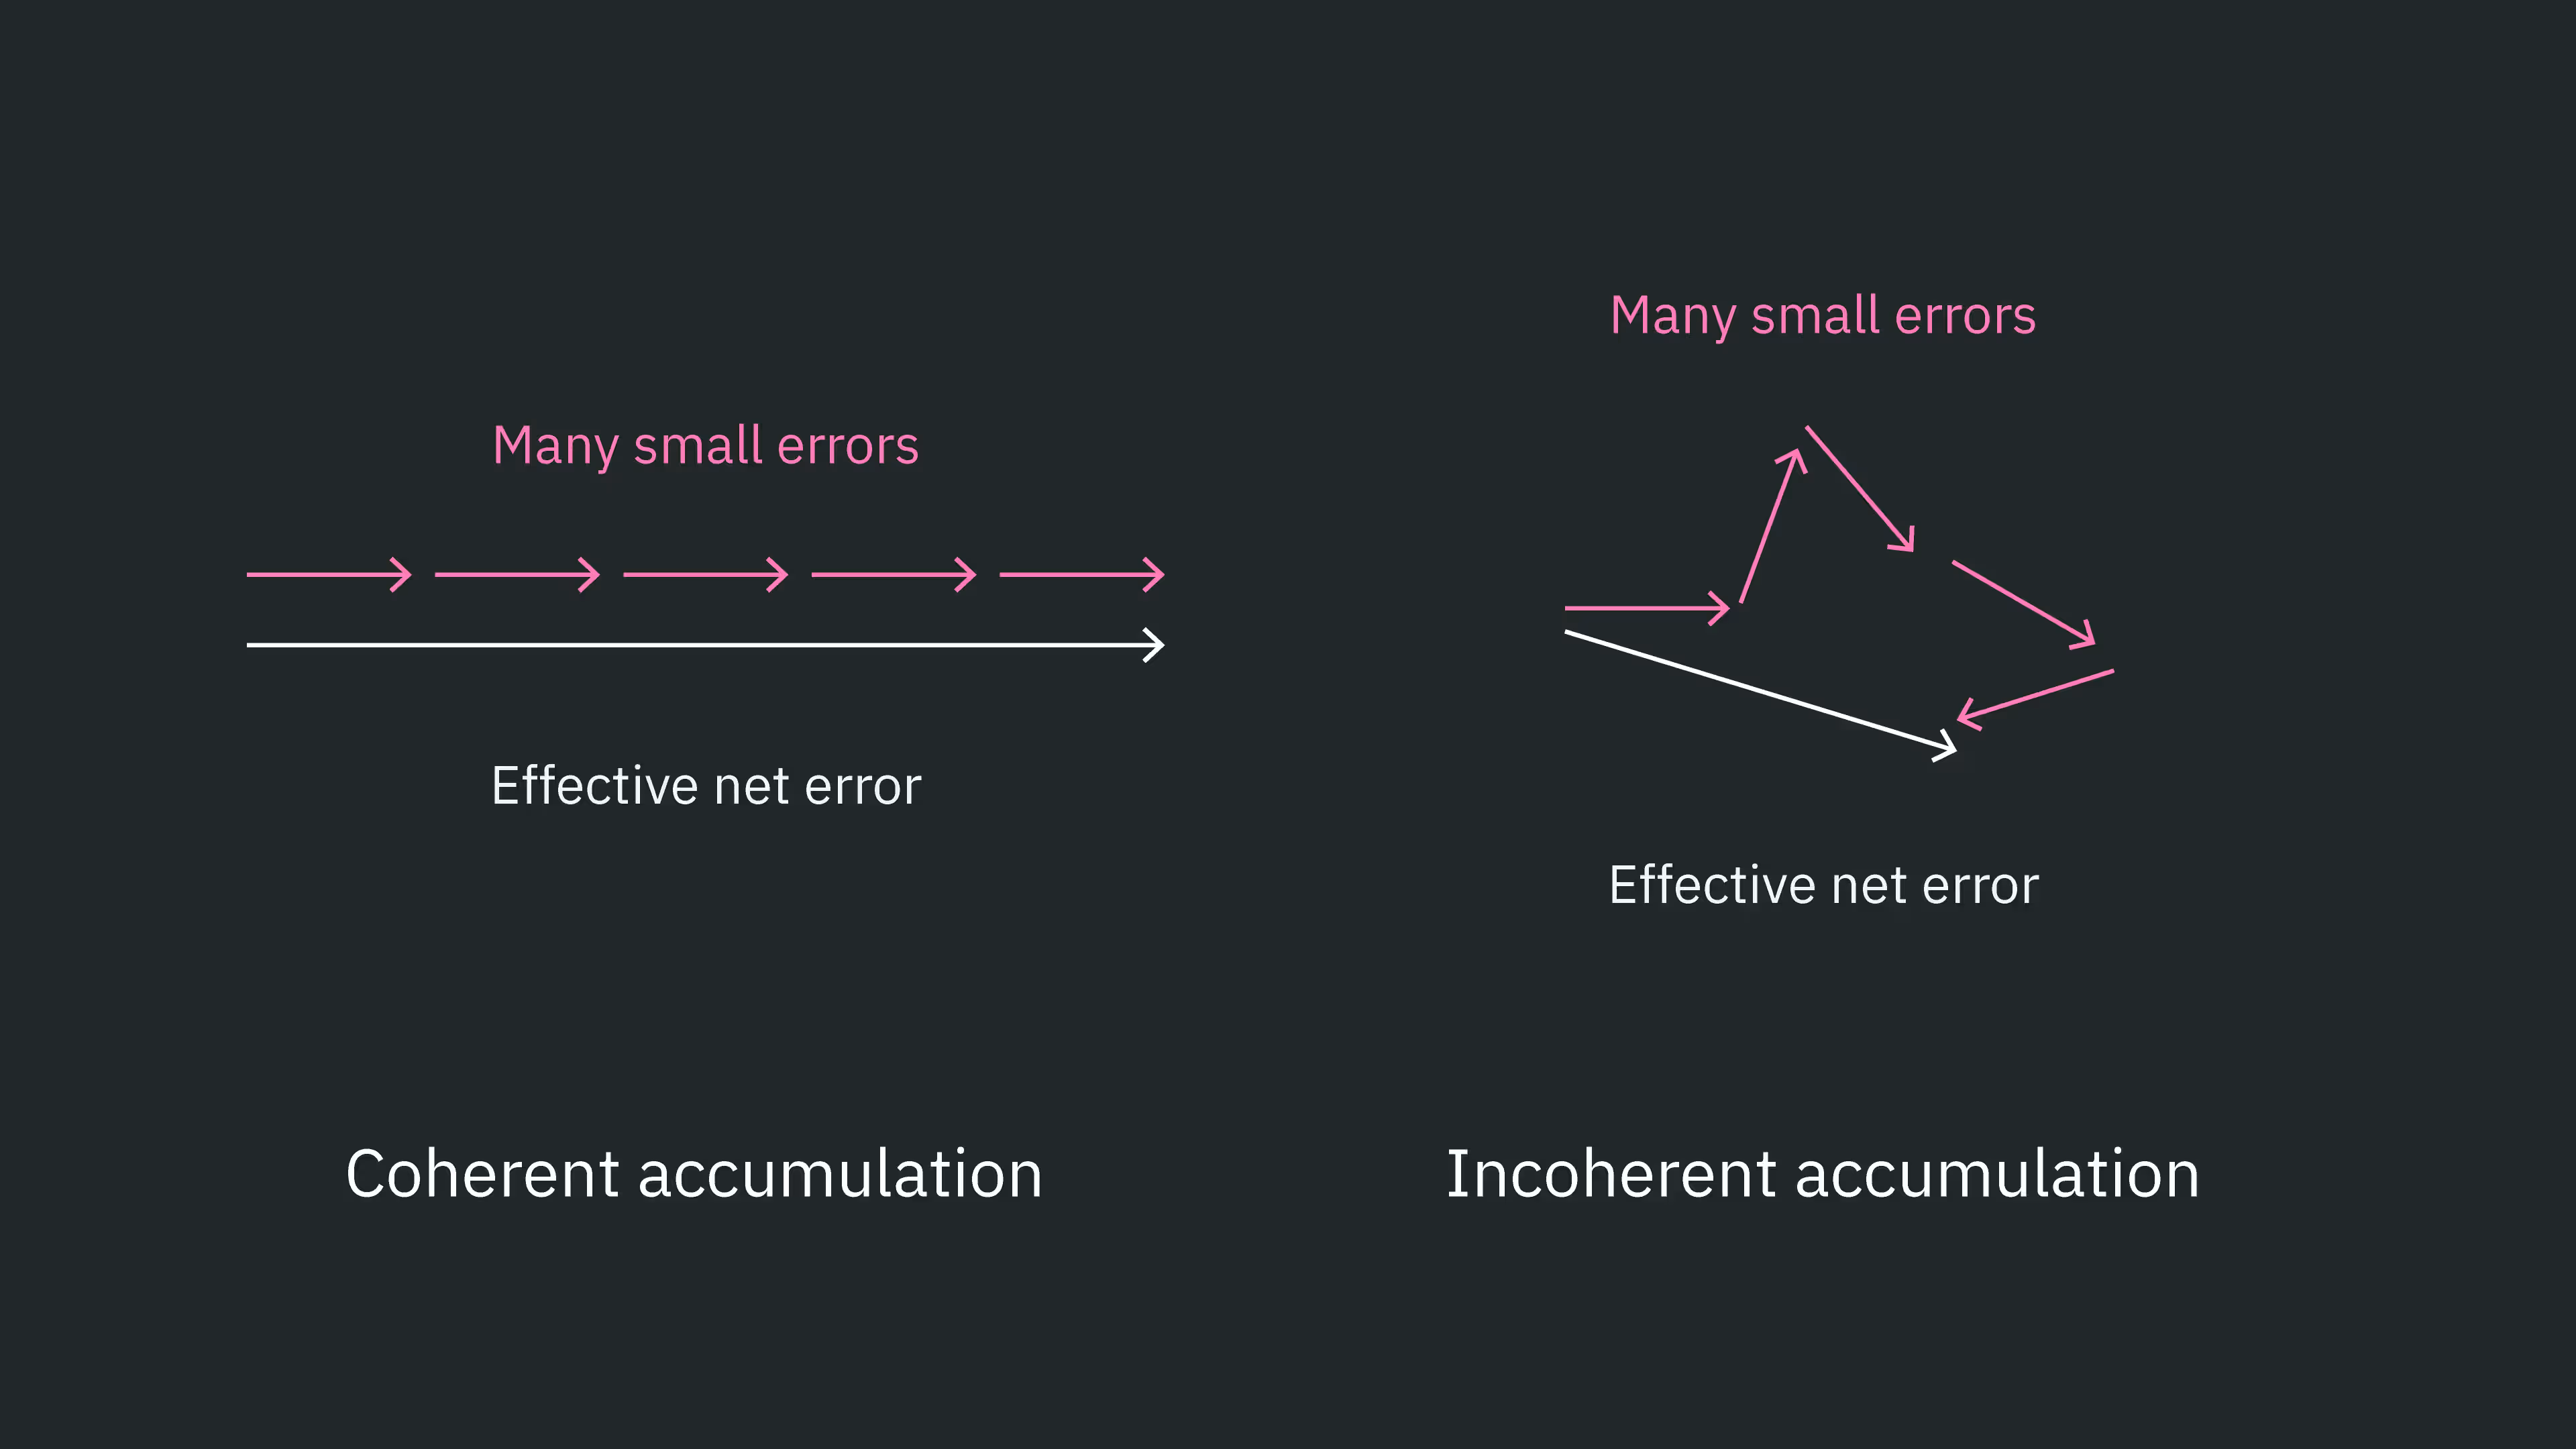
Přeměnou koherentního hromadění chyb na nekoherentní hromadění chyb lze často získat výsledky s vyšší věrností. Hlavní způsob, jak toho dosáhnout, se nazývá Pauliho twirling.
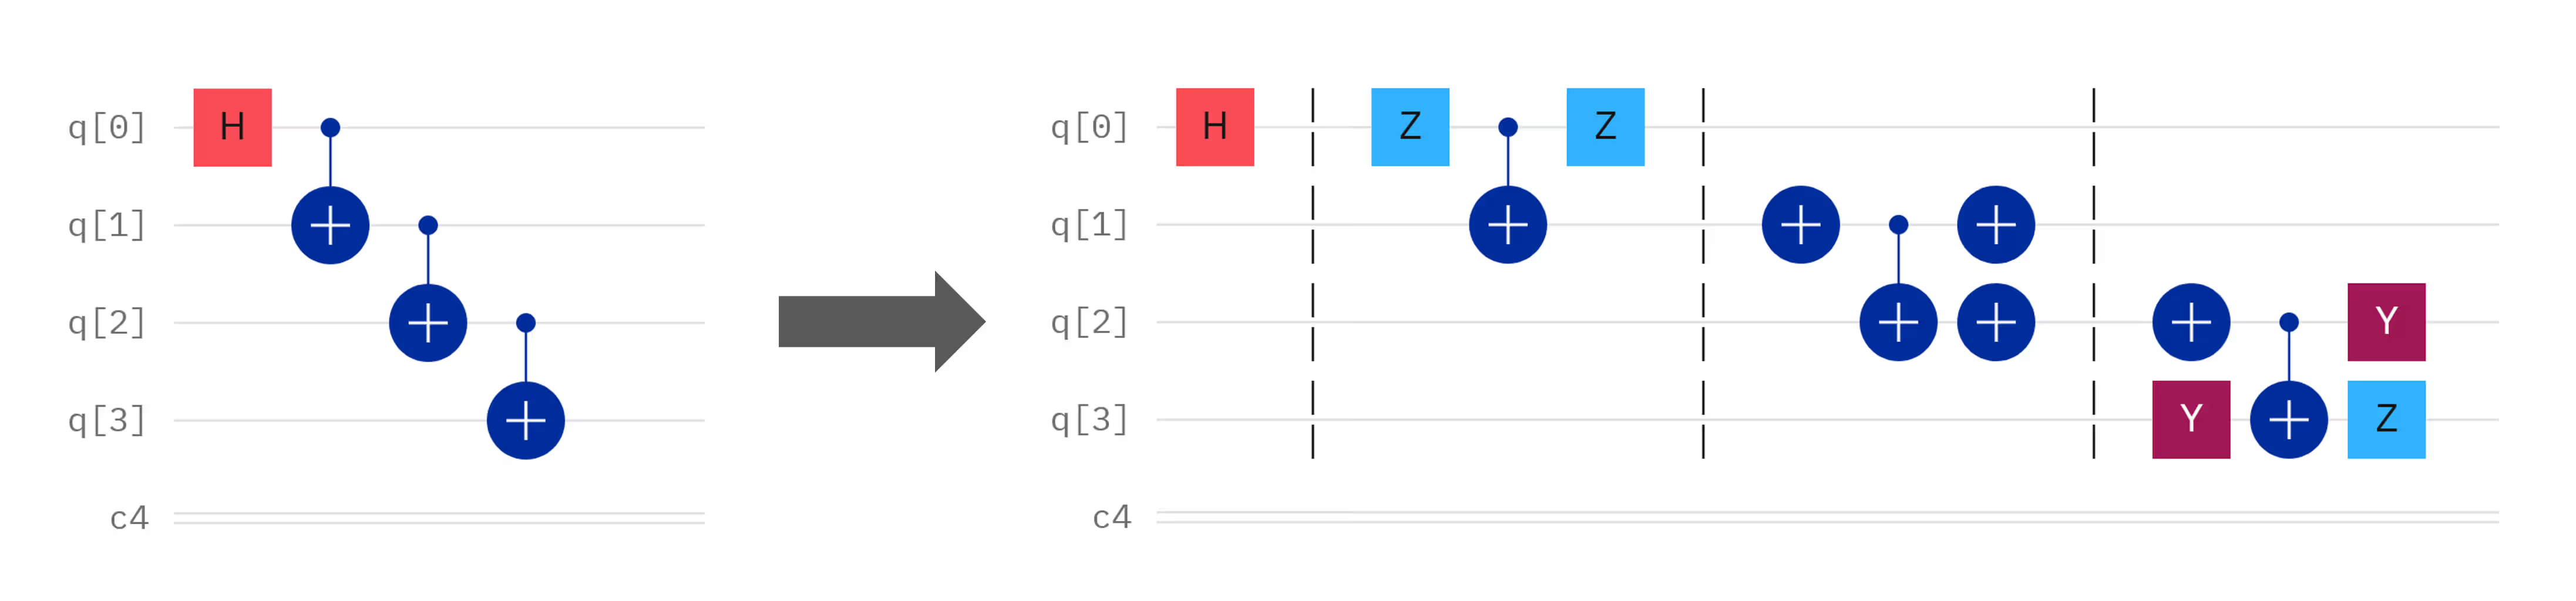
Pauliho twirling označuje přidávání kombinací Pauliho hradel před a po požadované operaci hradla takovým způsobem, že . Zde a nejsou jednotlivá Pauliho hradla, ale sady Pauliho operátorů, které často působí na více qubitů. Někdy se můžete setkat s tvrzením, že působení dodatečných Pauliho hradel je „ekvivalentní identitě“. To je však nepřesné a potenciálně matoucí. Pauliho hradla jsou oddělena hradlem a cílem je ponechat logické působení všech hradel rovné . Někdy se nazývá „náklad“ (payload), aby se tato zamýšlená operace odlišila od hradel přidaných za účelem potlačení. Níže jsou uvedeny některé příklady Pauliho twirlingu kolem hradla CNOT.

Projděme si jen jeden příklad, abychom ověřili, že twirling ponechává logický účinek nákladu beze změny. Bez ztráty obecnosti nechť jsou dvouqubitové stavy zahrnující a tyto:
Jako vždy používáme konvenci řazení qubitů . Aplikací hradla CX s jako cílem dostaneme
Nyní uvažujme třetí znázorněný obvod, který používá hradla X pro Pauliho twirling. Mohli bychom prostě vynásobit matice a ověřit, že dávají matici CNOT. Alternativně můžeme sledovat operaci na libovolném kvantovém stavu napříč obvodem, jak to děláme níže. Stavy v různých bodech obvodu byly označeny a-d.

Toto je přesně , které jsme získali dříve bez twirlingu. Tato twirlovaná sekvence hradel skutečně ponechává logické působení nákladu beze změny. Pokud se však z vrstvy na vrstvu náhodně volí různé platné twirlingové sekvence, koherentní hromadění chyb lze převést na efektivně stochastické (nekoherentní) hromadění chyb. Aby bylo jasno, nevybírá se jeden jediný vzor twirlingu, který by se použil v celém obvodu. Místo toho se pro různé vrstvy volí různé platné twirlingové sekvence. Příklad s mnoha propletovacími vrstvami by mohl vypadat takto.
Prověřte své porozumění
Ověřte, že Pauliho twirling ve čtvrtém panelu na obrázku výše rovněž ponechává logický účinek CNOT beze změny.
Odpověď
Postupujeme podle výše uvedeného příkladu a ukážeme, že působení na libovolný dvouqubitový stav je ekvivalentní operaci CNOT. Budeme odkazovat na označené body v tomto diagramu.

To je ekvivalentní působení CNOT s qubitem 0 jako řídicím a qubitem 1 jako cílovým.
Dokážete vymyslet sekvenci Pauliho twirlingu pro hradlo CNOT, která není znázorněna výše?
Odpověď
Ano, existuje jich mnoho dalších. Jedním příkladem je před CNOT a a po CNOT.
Kdy použít Pauliho twirling
Jak je zde uvedeno, Pauliho twirling se aplikuje pouze na vícequbitová hradla. Aplikace podobného protokolu na jednoqubitová hradla by vyžadovala jinou logiku a v praxi obecně není užitečná. Pauliho twirling sám o sobě používá několik jednoqubitových hradel (Pauliho hradel). Dodatečná Pauliho hradla by pravděpodobně vnesla více chyb, než by se získalo randomizací jakéhokoli koherentního hromadění chyb. Míry chyb spojené s dvouqubitovými hradly jsou mnohem vyšší než ty spojené s jednoqubitovými hradly. Kromě toho jsou některá jednoqubitová hradla neCliffordovská, která nelze plně twirlovat. To je důvod, proč Qiskit obsahuje možnosti Pauliho twirlingu, které automaticky twirlují kolem dvouqubitových hradel, a nikoli kolem jednoqubitových hradel.
To bylo implicitní na obrázku výše: Pauliho twirling byl implementován kolem hradel CX, ale ne kolem Hadamardova hradla.
Podívejme se na dva příklady Pauliho twirlingu v akci.
Pauliho twirling k potlačení koherentního hromadění
Abychom pozorovali, jak Pauliho twirling dokáže přeměnit koherentní hromadění chyb na pomalejší nekoherentní hromadění, potřebujeme obvod a pozorovatelnou veličinu, které fungují jako zátěžový test koherentních chyb. Jediným účelem je učinit koherentně se hromadící dvouqubitové chyby viditelnými, a poté ukázat, jak Pauliho twirling přeměňuje toto koherentní hromadění na stochastický rozpad.
Hradla CNOT (nebo CZ) jsou běžným zdrojem koherentních chyb. Nejjednodušší experiment, který v tomto případě můžeme provést, je inicializovat stav (řekněme ), aplikovat vrstvy spárovaných hradel CNOT (s využitím skutečnosti, že dvě CNOT dávají identitu) a zkontrolovat, jak se chyby hromadí s rostoucím počtem vrstev, jak s Pauliho twirlingem, tak bez něj.
Sledovanou pozorovatelnou veličinou je na jediném qubitu, kterou vykreslíme jako funkci počtu opakování dvojic CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Protože jsme před měřením otočili naši bázi, měření odpovídá tomu, že stav byl bezprostředně před posledním Hadamardovým hradlem ve stavu , a podobně pro a . Naši střední hodnotu lze proto jednoduše vypočítat z počtu výskytů mínus počet výskytů .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Zvolíme rozumný počet vrstev CNOT, během kterých necháme chybu hromadit, sestavíme naše obvody a poté je přeložíme (transpile).
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Mějte na paměti, že každá vrstva se skládá z více než jednoho dvouqubitového hradla. Sledujte hloubku dvouqubitových hradel po transpilaci pomocí níže uvedené funkce.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Nyní spustíme úlohy.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Nakonec tyto výsledky vizualizujeme.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
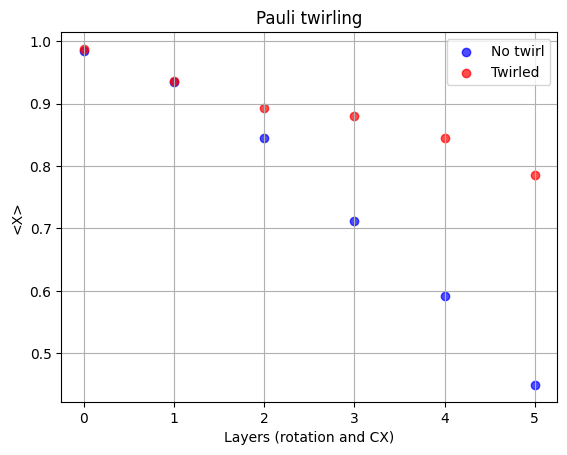
Jasně vidíme, že twirlovaný obvod dává střední hodnotu blíže k ideální hodnotě . Tento příklad splnil svůj účel, přesuňme se však k něčemu užitečnějšímu: twirlingu při produkci vysoce provázaných stavů.
Pauliho twirling při přípravě GHZ stavu
Předchozí příklad ukázal přesvědčivý případ pro Pauliho twirling při narušování koherentního hromadění chyb spojených s hradly CNOT. Produkce GHZ stavu používá mnoho hradel CNOT k vytvoření vysoce provázaných stavů užitečných pro mnoho aplikací kvantových výpočtů. Prozkoumejme, jak Pauliho twirling pomáhá v tomto kontextu, s GHZ stavy rostoucí velikosti.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
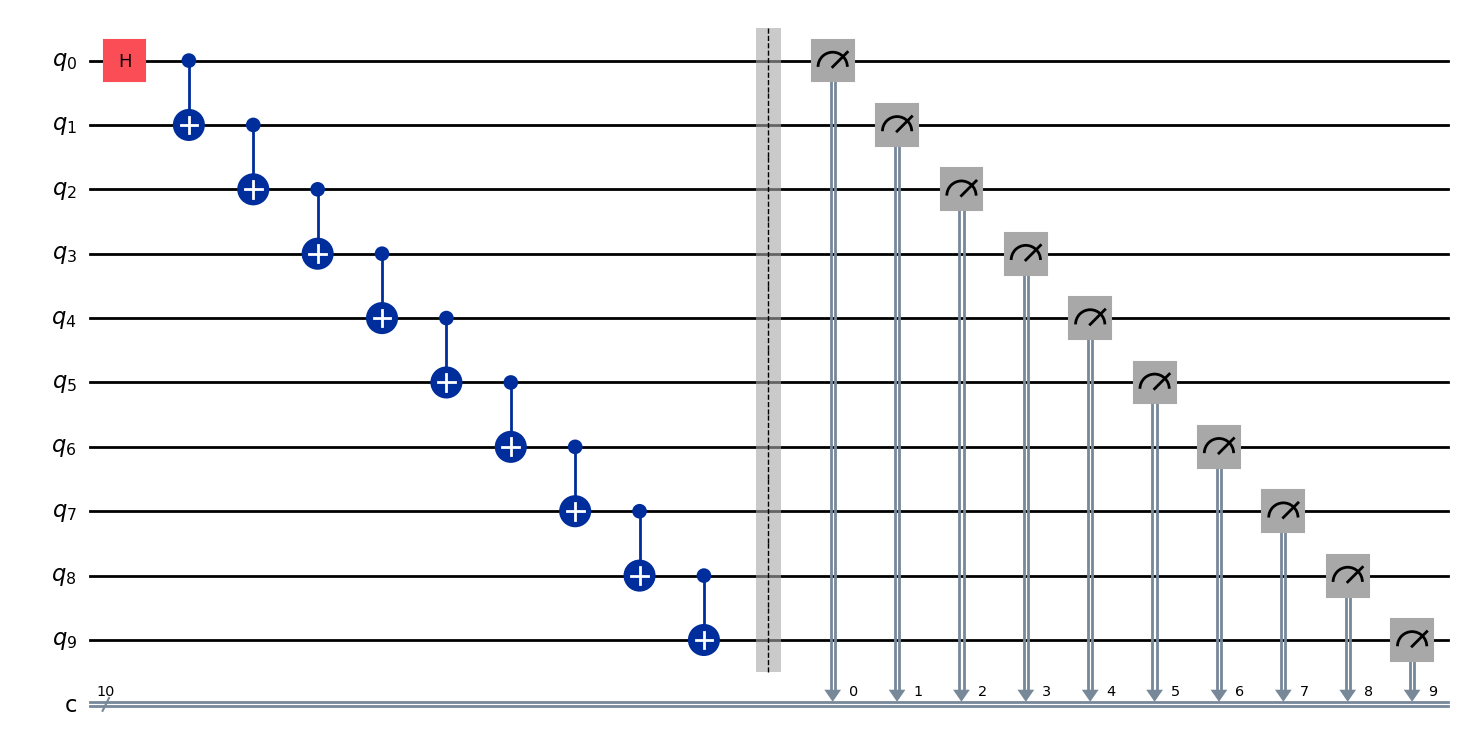
Nyní sestavíme naše obvody a přeložíme je. V tomto případě nemáme žádná uměle opakovaná hradla, která se redukují na identitu. Můžeme proto nechat pass manager, aby za nás provedl trochu více optimalizace. Nastavíme jej na úroveň tři.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Vidíme, že optimalizátor namapoval náš abstraktní obvod na qubity 123, 124, 136, 142 a 143.
circuits[0].draw("mpl")
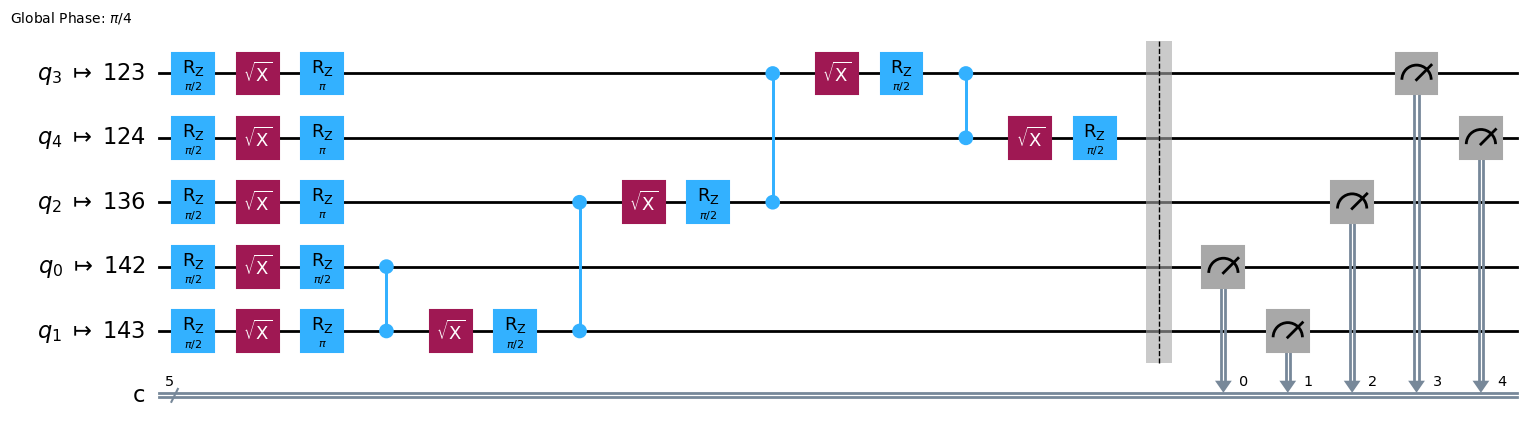
Abychom pochopili proč, podívejme se na mapu rozvržení našeho backendu (na tomto obrázku ibm_fez, ale ekvivalentní analýzy můžete provést na libovolném backendu).
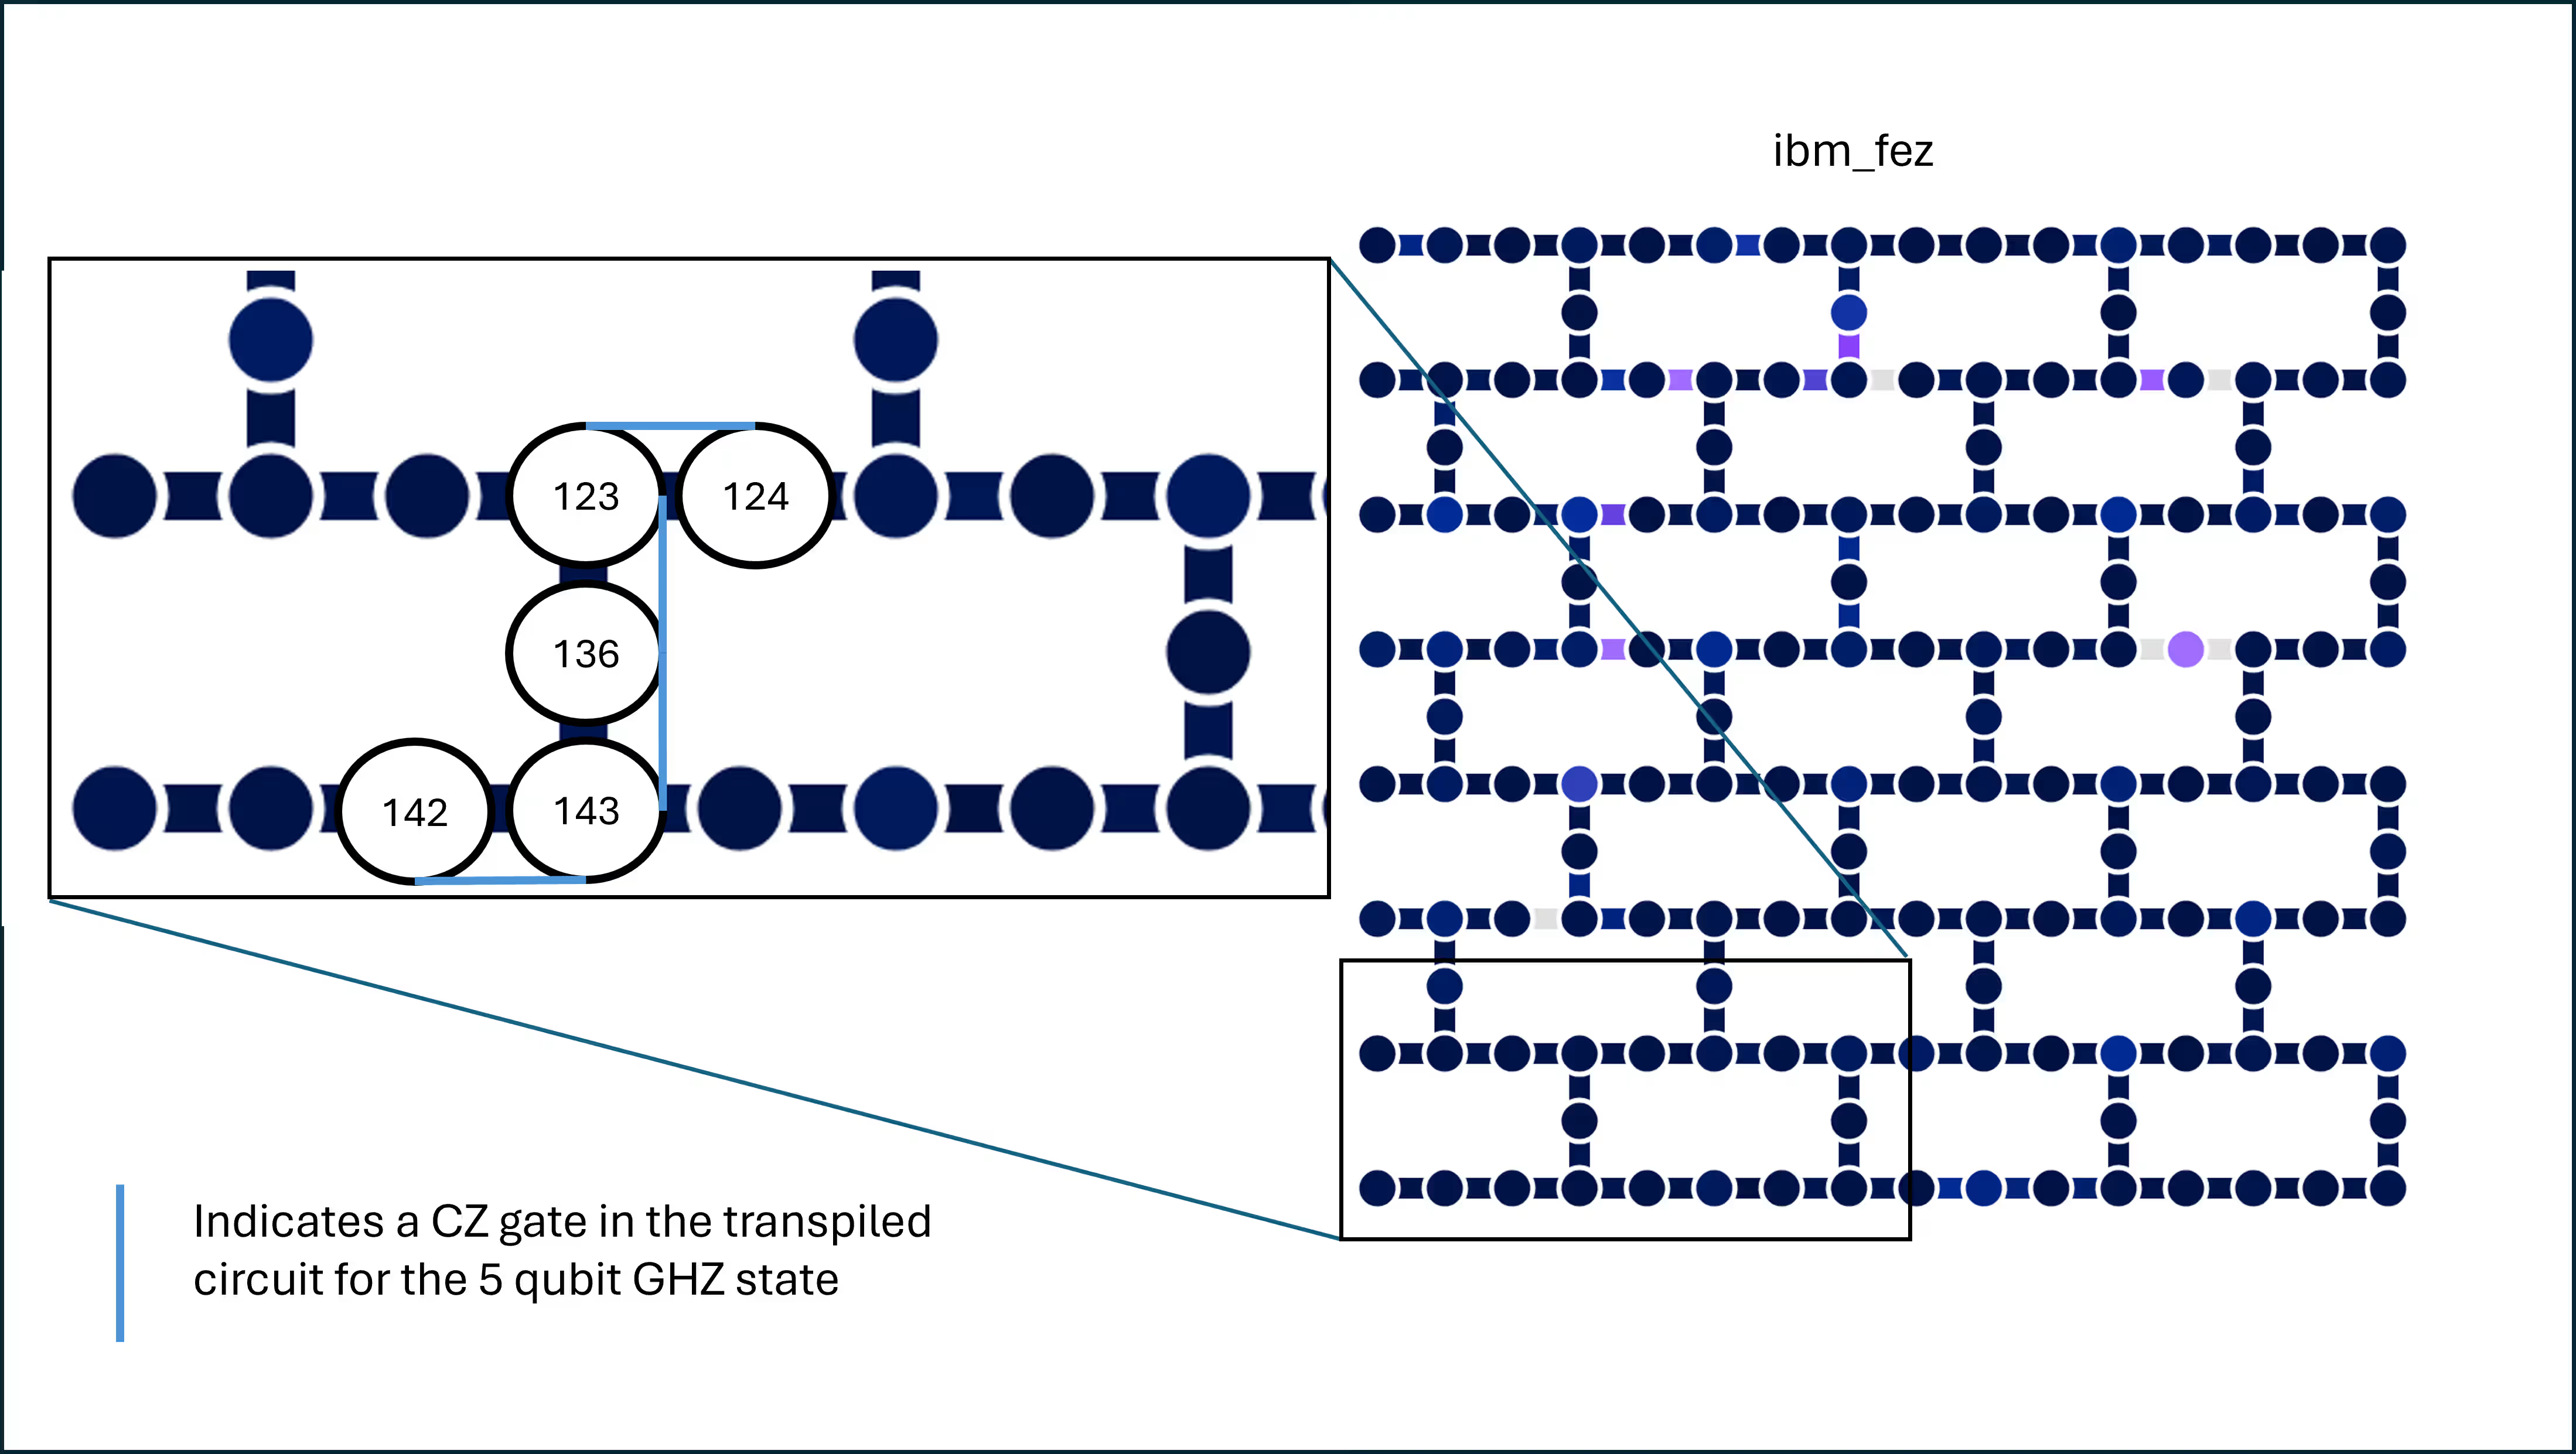
Vidíme, že qubity byly vybrány v řetězci, aby se minimalizovala swap hradla a tím i hloubka obvodu. Kromě toho je každé hradlo CZ implementované v obvodu mezi sousedními qubity. Nakonec všech pět qubitů má relativně nízké míry chyb, včetně měr chyb přiřazení při čtení (readout-assignment). Tyto míry chyb můžete zkontrolovat u libovolného backendu na stránce Výpočetní zdroje. Nalezení takového rozvržení není u jednoduchého lineárního řetězce obtížné, ale s tím, jak se problémy stávají složitějšími, se optimalizace rozvržení obvodu stává obtížnější a cennější.
Nyní nakonfigurujeme naši primitivu Sampler. Vypneme ostatní nástroje pro potlačení/mitigaci, abychom se zaměřili na Pauliho twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Nakonec spustíme naše úlohy. Volitelně můžete vypsat čísla ID úloh pro pozdější získání.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Extrahujeme počty naměřené pro každý výpočetní bázový stav pro všechny obvody, jak s twirlingem, tak bez něj.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Víme, že ideální rozdělení GHZ stavu je takové, ve kterém polovina shotů vrátí a druhá polovina vrátí . Sestavme toto rozdělení pro srovnání.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Nyní použijeme Hellingerovu věrnost jako míru kvality našeho konečného stavu.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Nakonec vykreslíme naše výsledky.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
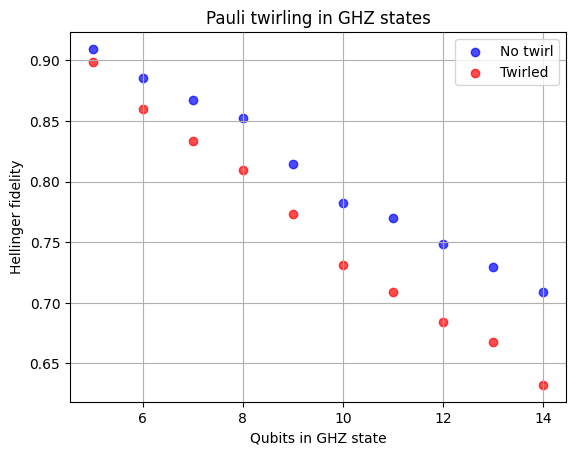
Výsledky s použitím Pauliho twirlingu nejsou lepší (a dokonce jsou o něco horší) než bez twirlingu. Co se stalo?
Staly se dvě věci. Zaprvé, Pauliho twirling nesnižuje celkové množství šumu — spíše přetváří koherentní, systematické chyby na stochastické chyby Pauliho typu, takže růst chyb se stává předvídatelným a modelovatelným. Nikdy nebylo přislíbeno snížení chyb, kromě zvláštních případů.
Zadruhé, v GHZ obvodech se některé koherentní chyby mohou díky symetrii konstrukce GHZ částečně rušit nebo se chovat jako neškodné fázové posuny; twirling tuto náhodnou ochranu odstraňuje a nahrazuje ji nekorelovaným stochastickým Pauliho šumem, takže věrnost GHZ se při twirlingu mírně zhoršuje.
Toto druhé tvrzení vyžaduje určité vysvětlení. Tvrzení není, že GHZ obvody jsou chráněny před všemi druhy koherentního hromadění chyb, pouze před některými druhy — a že v těchto případech je ochrana twirlingem zničena. Konkrétně uvažujme koherentní přerotaci spojenou s hradly CX. Nazvěme skutečné hradlo CX s přerotací :
kde je libovolný součin Pauliho operátorů, jako , , , atd. U obecných stavů může kterákoli z těchto nadměrných rotací ovlivnit statistiku měření (a tedy míry věrnosti stavu). Podmnožina z nich však ponechává mnoho standardních GHZ pozorovatelných veličin beze změny, včetně operátorů jako a . V kontextu přípravy GHZ stavu by relevantní chyby nadměrné rotace tohoto typu byly:
Příprava celého -qubitového GHZ stavu by vypadala takto:
Po přípravě GHZ stavu je stav ideálně:
Tento stav je simultánním vlastním stavem velké množiny Pauliho operátorů, včetně následujících:
s vlastní hodnotou . V důsledku toho operátor tvaru působí na GHZ stav jako násobení fázovým faktorem , což neovlivňuje standardní GHZ pozorovatelné veličiny, jako je parita, kolektivní nebo populace ve výpočetní bázi. Ačkoli jsou tedy chyby nadměrné rotace koherentní a systematické, jsou efektivně neviditelné pro měření používaná k posouzení věrnosti GHZ. V tomto smyslu má GHZ obvod náhodnou koherenční ochranu: určité koherentní chyby CX komutují se strukturou připravovaného stavu, a proto nezhoršují naměřený výkon.
Pauliho twirling zásadně mění tuto situaci. Twirling nezachovává koherentní chybu nadměrné rotace jako deterministický proces . Místo toho převádí koherentní chybový kanál na efektivní stochastický Pauliho kanál. V důsledku toho nyní chybový kanál zahrnuje členy jako , , a , které nekomutují se stabilizátory GHZ.
Když k těmto stochastickým Pauliho chybám dojde, vytvářejí skutečné bit-flip a phase-flip poruchy na jednotlivých qubitech nebo párech qubitů. Tyto chyby vyvádějí stav mimo podprostor stabilizátorů GHZ, snižují interferenci mezi a a přímo snižují věrnost GHZ a signály paritních měření více qubitů. Jinými slovy, Pauliho twirling odstraňuje koherentní strukturu chyby, ale zároveň odstraňuje i symetrií podmíněné rušení, které tyto chyby dříve činilo neškodnými. Výsledkem je mírně horší GHZ stav — ne proto, že by twirling přidával šum, ale proto, že převádí převážně neškodnou koherentní chybu na skutečně poškozující stochastické chyby.
Tento příklad zdůrazňuje důležité ponaučení: Pauliho twirling není univerzální strategie zlepšení. Je nejpřínosnější tehdy, když se koherentní chyby v obvodu hromadí způsobem destruktivním pro požadovanou věrnost. Ve vysoce symetrických obvodech, jako je příprava GHZ stavu, jsou některé koherentní chyby přirozeně sladěny se stabilizátory stavu, a jejich záměrná randomizace může tuto náhodnou ochranu odstranit.
Kombinace metod
V zásadě lze kombinovat Pauliho twirling s dynamickým odsíťováním (dynamical decoupling). V tomto případě jsme DD nepoužili ze dvou důvodů: za prvé by v tomto obvodu neměly být žádné extrémně dlouhé prostoje. Za druhé, GHZ stavy neukládají většinu své informace v jednoqubitové fázové koherenci, zejména pokud věrnost pozorujeme pouze z hlediska počtů bitových řetězců, a ne z hlediska fáze mezi požadovanými bitovými řetězci a .
Pokud bychom přípravu GHZ rozšířili na 100+ qubitů, mohla by být zpoždění při měření prvních/dřívějších qubitů skutečně dostatečně dlouhá na to, aby bylo DD užitečné. To platí zejména tehdy, vezmeme-li v úvahu přeloženou (transpilovanou) hloubku obvodu.
Pauli twirling ve struktuře RTZ echo
Náš poslední příklad Pauliho twirlingu v kontextu snižování hromadění koherentních chyb používá obvod s vrstvami kombinací X-CZ-X-CZ. Jde o dobře známou sekvenci hradel, která se často používá k eliminaci koherentních chybových členů ZZ ve dvouqubitových hradlech, a to i bez twirlingu. S twirlingem však můžeme snížit nebo randomizovat i další formy hromadění koherentních chyb.
Začneme definováním funkce pro sestavení obvodů podobných RTZ s proměnným počtem vrstev.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Nyní sestavíme obvody se zvyšujícím se počtem vrstev, až po nějakou rozumnou celkovou přeloženou dvouqubitovou hloubku.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
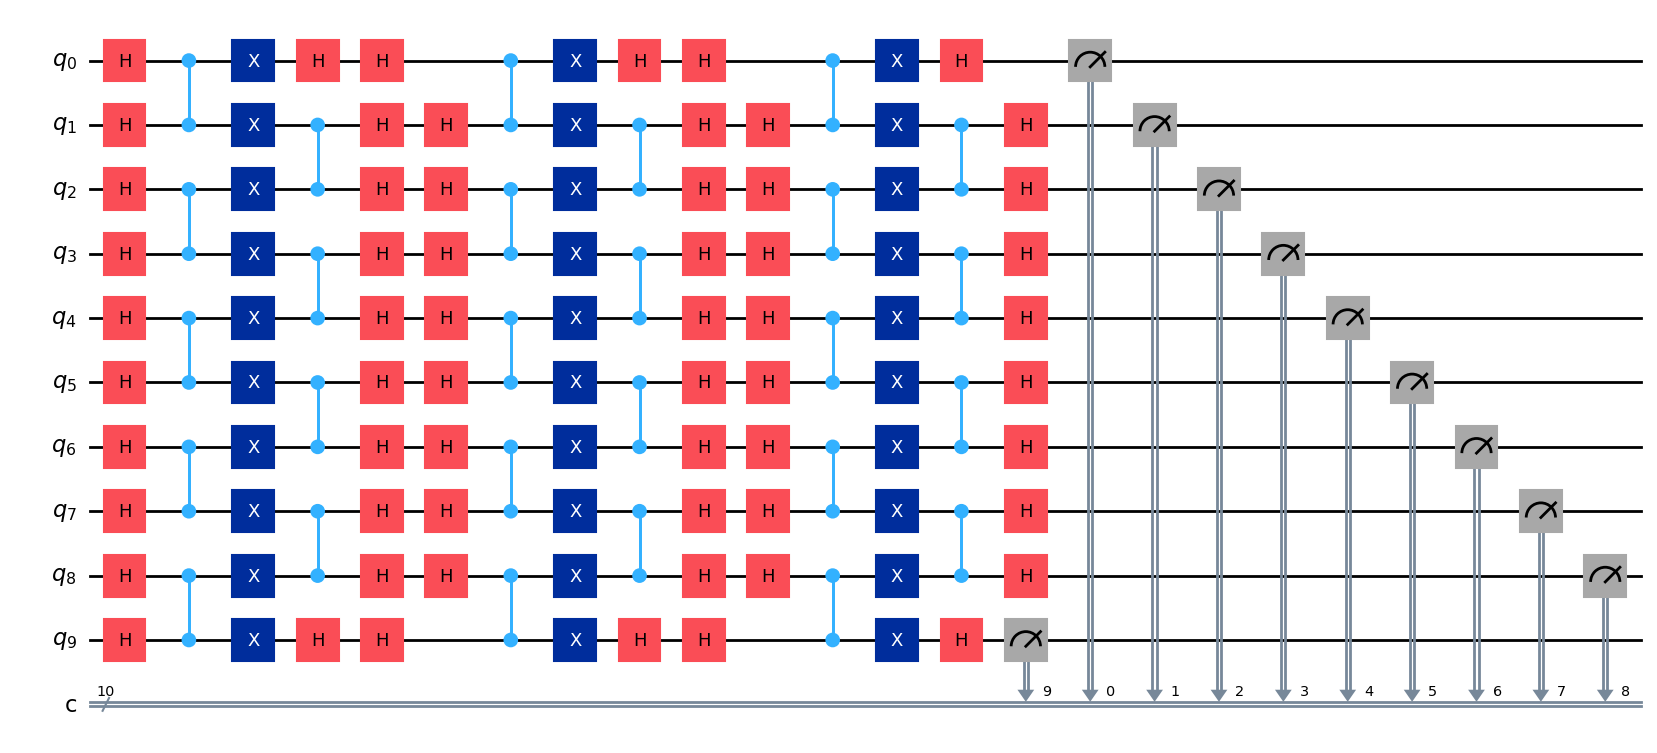
Na horním konci jsou některé z nich poměrně hluboké. Použijme AerSimulator bez šumového modelu k získání ideálních stavů na konci každého z těchto obvodů. Poté můžeme porovnat naše výsledky ze skutečných kvantových počítačů pomocí Hellingerovy věrnosti.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Nyní definujeme SamplerV2 s twirlingem a jeden bez twirlingu.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Nyní spustíme naše úlohy.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Získáme počty z každého běhu na skutečném kvantovém počítači.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Nyní najdeme Hellingerovu věrnost porovnáním každého z těchto běhů s výsledky bezšumového AerSimulatoru.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Nyní vizualizujeme naše výsledky.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
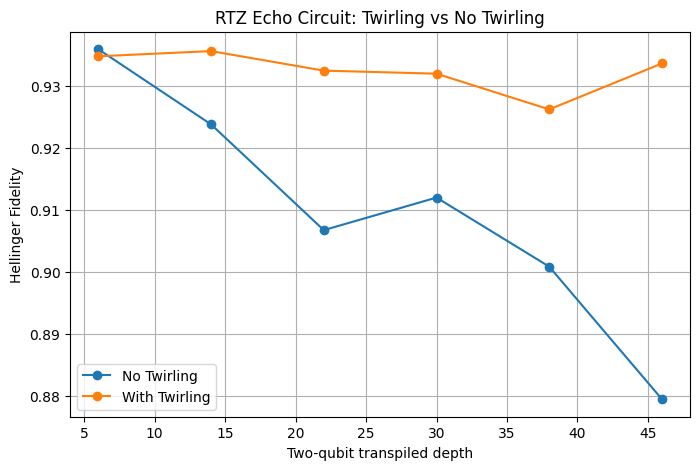
V průběhu této lekce jsme zkoumali případy, kdy je Pauliho twirling používán k omezení hromadění koherentních chyb, v kontextu, kde by mohl být popsán jako potlačení chyb. Pauliho twirling je však často užitečnější jako nástroj pro přetváření chování chyb, který převádí koherentní chyby do formy, která je předvídatelnější a snáze se modeluje. Užitečnost toho se stane zřejmější v kontextu technik zmírňování chyb, jako je extrapolace na nulový šum (ZNE), které se spoléhají na rozumně předvídatelné škálování šumu. O tom pojednává následující lekce.