Šum a chyby
Tato lekce představí kvantový šum a chyby, včetně mnoha jejich zdrojů, a nabídne analogie s klasickými chybami. Pochopení typů chyb, které mohou nastat, a schopnost modelovat šum pomocí kvantových kanálů budou klíčové pro pochopení dalších lekcí. Většina metod zpracování chyb totiž vyžaduje, abychom věděli něco o typu šumu nebo chyb, které se snažíme snížit nebo opravit.
Toto video podává přehled o šumu a chybách a poukazuje na několik výpočetních výsledků. Text níže přidává další podrobnosti a zkoumá některé typy chyb pomocí Qiskit.
Příčiny
Klasický šum a chyby
Abychom porozuměli kvantovým chybám a šumu, začněme klasickou analogií. V klasických počítačích dochází k chybám z řady důvodů, včetně různých mechanismů falešné akumulace náboje, jednorázových poruch (single-event upsets) a pomalé degradace materiálu. Některé z těchto mechanismů (nikoli všechny) mají analogie v kvantovém počítání a budou klíčové pro pochopení kvantových chyb a šumu. Krátce si je připomeneme a poté přejdeme ke kvantovým analogiím.
Tepelný šum:
Jak se součásti počítače zahřívají, tepelný pohyb atomů a nosičů náboje mění rezistivitu materiálu (obvykle ji zvyšuje). To znamená, že odpor v obvodu se může měnit. I když je to vzácné, může to vést k falešnému logickému přechodu v tranzistoru. Ačkoli drobným výkyvům se nelze vyhnout, správné chlazení součástek je klíčové pro předcházení těmto efektům.
Tepelné poškození a degradace:
Opakované zahřívání a chlazení materiálů může způsobit velmi pomalou migraci vodivých prvků (kovů). V lepším případě to mění odpor nebo kapacitu (nebo obojí) prvků obvodu a vede k nepřesnému časování provozu obvodu. V nejhorším případě to vede ke zkratu nebo trvalé poruše. I zde je klíčem k prevenci tohoto typu degradace správná regulace teploty.
Efekty vyvolané zářením (jednorázové poruchy, SEU):
Vysokoenergetické částice mohou někdy ionizovat atomy uvnitř procesoru a vyvolat falešný náboj. Pokud k tomu dojde na nesprávném místě a v nesprávný čas, může to vést k logickým chybám. Zdrojem těchto vysokoenergetických částic (včetně elektromagnetického záření a neutronů) jsou typicky vysokoenergetické interakce ve vyšších vrstvách atmosféry. Tyto poruchy jsou proto častější v prostředích ve vysoké nadmořské výšce, včetně vesmíru. Řeší se pomocí korekčních kódů a konstrukce odolné vůči záření.
Elektromagnetické rušení:
Chyby mohou být způsobeny také vnějšími elektromagnetickými (EM) poli ze spínaných napájecích vedení, rádiových vysílačů nebo jiných součástí systému. To se liší od vysokoenergetického záření z předchozího jevu. Zde bludná časově proměnná EM pole indukují proud a napětí napříč výpočetními součástkami (na rozdíl od ionizace konkrétního atomu při jedné události). Protože časová závislost polí je určujícím faktorem indukovaných napětí, je tento typ rušení obzvláště důležitý ve vysokofrekvenčních systémech. Tyto chyby lze mimo jiné potlačit stíněním a uzemněním.
Přeslechy mezi propojeními:
Kapacitní nebo indukční vazba mezi sousedními vodiči, zejména v integrovaných obvodech s nanoměřítkem, může vést k falešným signálům. To souvisí s elektromagnetickým rušením, ale liší se tím, že zdrojem rušivého pole je jiná součástka uvnitř obvodu počítače. Představ si dva vodiče velmi blízko u sebe. Pokud vodič A zažije náhlý přechod (změnu napětí), může to indukovat proudy v sousedním vodiči B. Přesný směr a velikost závisí na uspořádání obvodu; může jít o koherentní čistý tok náboje nebo o něco bližšího vířivým proudům náboje. V některých případech to však může vést k nežádoucím logickým přechodům. Tyto efekty přeslechů lze zmírnit optimálním rozestupem uspořádání, stíněním a řízenými dobami náběhu signálu.
Toto není úplný výčet, ale postačuje k tomu, abychom začali vidět paralely s kvantovým počítáním. Všimni si, že u všech výše uvedených typů nežádoucích interakcí může projev šumu jako logické chyby nabývat pouze podoby přechodu 0 na 1 nebo 1 na 0. To je vše, co je ve stavovém prostoru klasických bitů dovoleno.
Kvantový šum a chyby
V kvantovém počítání se o šumu a chybách často mluví společně, ale je důležité rozpoznat rozdíl. Kvantový šum označuje základní fyzikální rušení ovlivňující qubity a kvantové systémy. Zahrnuje všechny formy nežádoucích interakcí nebo fluktuací z okolí, nedokonalých řízení nebo hardwarových vad, které způsobují, že se kvantový stav odchyluje od ideálu. Kvantové chyby jsou konkrétní odchylky nebo vady v kvantové informaci, které jsou důsledkem kvantového šumu. Kvantové chyby jsou měřitelné nebo provozní projevy šumu a mezi chyby patří překlopení bitu (bit-flip), překlopení fáze (phase-flip), tlumení amplitudy a další. Jak šum, tak chyby se mohou vyskytovat spojitě. Pole použité v kvantovém hradle se může například lišit o 0,1 %, 0,15 % nebo o jakýkoli jiný zlomek. To může vést k nesprávné fázi qubitu, rovněž o libovolnou spojitou hodnotu. Uvidíš však, že v praxi, a zejména při korekci chyb, je běžné zacházet s chybami, jako by byly diskrétní: seskupovat nahromaděné efekty do diskrétního překlopení bitu nebo jediné fázové rotace. To je užitečné pro opravu chyb a jejich charakterizaci, ale neznamená to, že efekt šumu na qubit je pouze diskrétní množina chyb.
Existuje mnoho typů šumu, které ovlivňují kvantové počítače. Některé mohou vést k několika typům chyb, zatímco jiné jsou spjaty s konkrétními projevy chyb. Úplný výčet přesahuje účel této lekce; zde je částečný seznam relevantní pro zbytek tohoto kurzu, přičemž některé mají paralely se šumem v klasickém počítání.
Thermal:
Dva výpočetní bázové stavy a qubitu jsou odděleny velmi malým množstvím energie. Přesná hodnota samozřejmě závisí na kvantovém hardwaru. U qubitů v pevné fázi (transmonů s pevnou frekvencí), jaké používá IBM Quantum®, je energetický rozdíl mezi těmito stavy řádově J, tedy několik mikroelektronvoltů. Tuto energetickou škálu lze vztáhnout k frekvenci pomocí nebo k charakteristické teplotě. Protože teplota souvisí s průměrnou kinetickou energií částic ve vzorku, můžeme pomocí Boltzmannovy konstanty získat odhad teploty, při které by měly průměrné částice dostatek energie k vyvolání přechodu:
Aby se snížila pravděpodobnost, že tepelné interakce způsobí přechod z jednoho výpočetního bázového stavu qubitu do druhého, musí být teplota qubitů udržována podstatně pod 100 mK, ideálně blíže k 15–25 mK. Jakékoli výraznější zvýšení teploty nad tyto hranice by vedlo k naprosto náhodnému obsazení stavů a úplné ztrátě kvantové informace.
To je obdobné tepelným chybám, ke kterým může docházet v klasických počítačích, protože obojí má tepelný původ — teplotní škála je však samozřejmě jiná, stejně jako mechanismus ztráty informace.
Přeslechy a rušení:
Přeslechy v kvantovém počítání označují jakoukoli nežádoucí vazbu nebo rušení mezi qubity nebo řídicími linkami, kdy operace nebo signál určený pro jeden qubit neúmyslně ovlivní i ostatní. Projevuje se jako chyby nebo korelace mezi qubity, které by ideálně měly být nezávislé.
V architekturách supravodivých qubitů, jako jsou ty používané společností IBM®, mohou přeslechy vznikat únikem mikrovlnných řídicích signálů do sousedních qubitů, nezamýšlenou vazbou mezi vyčítacími rezonátory nebo tokovými přeslechy mezi smyčkami qubitů.
Mnoho přístupů k minimalizaci přeslechů je zabudováno přímo do návrhu kvantového počítače, například rozestup qubitů a zajištění toho, aby sousední qubity měly odlišné provozní frekvence. Existují také softwarové přístupy ke zmírňování chyb způsobených přeslechy, kterým se budeme věnovat v pozdějších lekcích.
Nedokonalé operace gatů:
Operace na qubitech se provádějí pomocí hardwaru, který má konečnou přesnost a může podléhat šumu nebo jiným zdrojům nepřesnosti. Konkrétně se k realizaci rotačních gatů používají mikrovlnné pulzy specifické délky trvání a s konkrétní orientací. Řekněme například, že mikrovlnný pulz má provést rotaci o 0,30 radiánu kolem osy . Orientace má konečnou přesnost, což vede k jisté nepřesnosti v ose rotace. Kromě toho vždy existuje zásadní kompromis mezi frekvencí pulzu a jeho délkou trvání. Velmi dlouhý pulz se může chovat v podstatě sinusově s prakticky jedinou frekvencí. K vytvoření krátkého balíku je zapotřebí superpozice mnoha frekvencí. Jde o stejný kompromis, který je základem relace neurčitosti energie a času, ačkoli přesnost gatů se zatím k těmto zásadním limitům neblíží; prostor pro zlepšení stále existuje.
Šum vlastní kvantové povaze:
Tento poslední typ šumu se od ostatních značně liší; není způsoben chybami, ale samotnou povahou kvantové mechaniky. Předpokládejme, že qubit v kvantovém stavu je změřen a zkolabuje do vlastního stavu ( nebo ). V systému transmonu s pevnou frekvencí je qubit disperzně vázán na mikrovlnný rezonátor, jehož rezonanční frekvence mírně závisí na stavu qubitu. Rezonátorem je vyslán mikrovlnný sondovací pulz a výstupní signál získá fázový posun a změnu amplitudy závislé na stavu. Tento signál je poté zesílen a změřen pomocí klasické elektroniky.
Na kvantové úrovni je měřicí signál nesen koherentním mikrovlnným polem s konečným průměrným počtem fotonů. Kvůli kvantové povaze elektromagnetických polí vykazují kvadratury pole vnitřní fluktuace. Tyto fluktuace jsou nezávislé na technických nedokonalostech a vznikají i u ideálního koherentního stavu. Zvýšení průměrného počtu fotonů zvyšuje měřicí signál, ale základní úroveň šumu zůstává konečná, takže rozlišitelnost mezi výsledky se zlepšuje pouze jako .
I když je tedy qubit dokonale připraven a měřicí řetězec je ideální, výstupní (readout) signál odpovídající danému stavu qubitu není jedinou pevnou hodnotou, ale rozdělením, které omezuje, jak dobře lze výsledky rozlišit. Toto překrytí představuje základní zdroj neurčitosti v samotném procesu měření. V praxi sice často dominuje technický šum ze zesilovačů a dalších součástek, ale tento vnitřní kvantový šum stanovuje dolní mez věrnosti výstupu (readout fidelity).
Neurčitost není chyba:
Všechny tyto zdroje šumu se liší od základní neurčitosti spojené s měřením kvantových stavů. Pro srovnání předpokládejme, že máme qubit v kvantovém stavu:
Tento stav má 64% šanci, že bude změřen ve stavu , a 36% šanci, že bude změřen ve stavu . Jediné měření však vydá pouze nebo — takže jediné měření nám o stavu před měřením zřídka řekne mnoho. K získání podrobných informací o stavu je potřeba mnoho měření. Z deseti měření bychom mohli očekávat, že šest nebo sedm vydá . Nebylo by však nijak šokující, kdyby prvních deset měření náhodou vydalo samé (podobně jako házení férovou mincí a získání „panny“ desetkrát za sebou: neobvyklé, ale zcela možné). Pokud bychom měření zopakovali 1000krát a vždy dostali , to by skutečně bylo šokující.
Existuje tedy neurčitost v naší znalosti kvantového stavu založená na jakémkoli konečném počtu měření. Jak měření opakujeme, naše znalost kvantového stavu před měřením se zlepšuje, ale nikdy není dokonalá. Hovorově by se dalo říct, že v každém výsledku kvantového měření je vždy nějaká podkladová „chyba“. Jde ale o jiné použití termínu „chyba“ a lépe se to popisuje jako statistická neurčitost. Proces zvyšování znalosti kvantového stavu prostřednictvím mnoha měření se nazývá tomografie kvantového stavu. Tomografie kvantového stavu se však neomezuje pouze na měření podél Z; obecně se týká měření podél ortogonálních os (jako X, Y a Z) pro určení amplitud a relativní fáze. Více o tomto procesu najdeš v této části kurzu Johna Watrouse o obecné formulaci kvantové informace, nebo pro praktickou implementaci viz tato lekce o teleportaci v kurzu Kvantové počítání v užitečném měřítku.
Pozorování chyb a jejich akumulace
V této části použijeme skutečné kvantové počítače k pozorování kvantových chyb a jejich akumulace za různých podmínek. V praxi je obvykle přítomno současně mnoho zdrojů kvantových chyb. Abychom mohli pozorovat různé typy chyb do jisté míry izolovaně, budeme potřebovat circuity navržené právě pro tuto izolaci. Circuity používané v aplikacích kvantového počítání budou vypadat mnohem složitěji.
Začněme chybami energetické relaxace.
Chyby energetické relaxace ()
Vzpomeň si z naší diskuze o tepelném šumu, že při jakékoli nenulové teplotě existuje určitá pravděpodobnost, že kvantový systém projde přechodem mezi vlastními energetickými stavy. Relaxace () dominuje, protože je poháněna spontánní emisí (nezávislou na teplotě), zatímco nízká teplota potlačuje konkurenční proces excitace. Čím déle qubit zahálí, tím více času má na to, aby takovým přechodem prošel. Pravděpodobnost, že qubit připravený ve stavu zůstane ve stavu po čase , je dána vztahem
Čas je experimentálně určený charakteristický čas, který je pro každý qubit jiný a může se v čase i mírně měnit. Kvantové počítače IBM® jsou pravidelně benchmarkovány, takže časy , které najdeš uvedené pro qubity na kvantových počítačích IBM, by měly být přesné a aktuální. Vysoká hodnota znamená, že qubit zůstává (v průměru) déle ve stavu, který jsi připravil. Typické hodnoty se liší mezi jednotlivými architekturami; qubity v kvantových počítačích IBM mají časy často řádově 200–300 a nejnovější hodnoty si můžeš zkontrolovat na stránce Výpočetní zdroje.
Charakteristický čas měří něco jiného: ztrátu fázové informace. K tomu se vrátíme později.
Abychom pozorovali chyby energetické relaxace, připravíme qubity ve stavu a poté je záměrně necháme na dlouhou dobu nečinné. To je ta umělá část. Ve skutečných kvantových pracovních postupech můžeš mít několik qubitů, které zůstávají nečinné po dlouhou dobu, zatímco na jiných qubitech probíhají procesy; několik takových případů nečinnosti tedy není umělých.
Začněme importem několika balíčků a výběrem nejméně vytíženého backendu.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"cycler": "cycler", "matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_runtime import QiskitRuntimeService
import numpy as np
import matplotlib.pyplot as plt

# If your credentials are already saved locally
service = QiskitRuntimeService()

# To load an unsaved instance, uncomment the line below
# service = QiskitRuntimeService(channel = "ibm_quantum_platform", instance = "your crn here")

# To select the least-busy backend:
# backend = service.least_busy(simulator=False, operational=True)

# To specify the backend by name:
backend = service.backend("ibm_boston")

props = backend.properties()
print(backend)
<IBMBackend('ibm_boston')>
Nyní vybereme qubit, se kterým budeme pracovat, v tomto případě qubit nula. Vlastnosti tohoto qubitu, včetně a , si můžeme přímo importovat.
qubit_idx = 0
qubit_props = props.qubit_property(qubit_idx)

t1 = qubit_props["T1"][0]  # * 1e6  # Convert seconds to µs
t2 = qubit_props["T2"][0]  # * 1e6  # Convert seconds to µs

# print(f"Qubit {qubit_idx}: T1={t1} µs, T2={t2} µs")
print(f"Qubit {qubit_idx}: T1={t1} s, T2={t2} s")
Qubit 0: T1=0.0002737016180018049 s, T2=0.00042784777605680494 s
Znalost v jednotkách mikrosekund je důležitá, ale nemusíš mít intuitivní pocit, co to znamená. Operace gatů na kvantových počítačích jsou totiž velmi rychlé. Skutečnou otázkou je: kolik toho na kvantovém počítači stihneme udělat za tuto dobu. Proto je užitečné vztáhnout k jiným časovým škálám používaným v kvantovém počítání — konkrétně k následujícím:
-
vzorkovací čas – nejmenší časový takt, po kterém lze na kvantovém počítači implementovat řídicí procesy.
-
časy jednoqubitových gatů – doba potřebná k provedení operace gatu na jednom qubitu. Nepůjde o jedinou hodnotu, ale o rozsah možných čísel v závislosti na typu gatu.
-
časy dvouqubitových gatů – doba potřebná k provedení operace gatu na dvou sousedních qubitech. I ta může nabývat rozsahu hodnot, ale obvykle je zhruba o jeden řád delší než u jednoqubitového gatu.
Zkontrolujme pro náš backend a zobrazme si některé pravděpodobné rozsahy pro časy gatů.
print(f"Using backend: {backend.name}")

# Access the backend target
target = backend.target

def get_gate_times(target, gate_name):
    results = []

    if gate_name not in target:
        return results  # gate not supported

    # target[gate_name] is a dict: {(qubits): InstructionProperties}
    for qubits, props in target[gate_name].items():
        if props.duration is not None:
            results.append({"qubits": qubits, "duration_ns": props.duration * 1e9})

    return results

# Query some gates
for gate in ["cz", "x"]:
    times = get_gate_times(target, gate)

    print(f"\nGate: {gate}")
    if times:
        for entry in times[:5]:
            print(f"  Qubits {entry['qubits']}: {entry['duration_ns']:.2f} ns")
    else:
        print("  Not available on this backend")
Using backend: ibm_boston

Gate: cz
  Qubits (0, 1): 68.00 ns
  Qubits (1, 0): 68.00 ns
  Qubits (1, 2): 68.00 ns
  Qubits (2, 1): 68.00 ns
  Qubits (2, 3): 88.00 ns

Gate: x
  Qubits (0,): 32.00 ns
  Qubits (1,): 32.00 ns
  Qubits (2,): 32.00 ns
  Qubits (3,): 32.00 ns
  Qubits (4,): 32.00 ns
Tyto časy gatů se budou lišit backend od backendu. Napevno nastavíme čas dvouqubitového gatu převzatý z ibm_boston na 68 ns.
dt = backend.configuration().dt
two_q_gate_time = 68e-9
print("The sampling time is : ", dt)
print("dts per T_1 : ", t1 / dt)
print("2-qubit characteristic time : ", two_q_gate_time)
print("The sampling time intervals per two-qubit gate : ", two_q_gate_time / dt)
print("2-qubit gates per T_1 : ", t1 / two_q_gate_time)
The sampling time is :  4e-09
dts per T_1 :  68425.40450045122
2-qubit characteristic time :  6.8e-08
The sampling time intervals per two-qubit gate :  17.0
2-qubit gates per T_1 :  4025.0237941441897
Měj na paměti, že zde nebyly zohledněny žádné jiné zdroje chyb ani jejich potlačování či zmírňování. Chyby nejsou jediné chyby, které v kvantovém systému působí, takže si těmito čísly nedělej příliš velké starosti. To jednoduše znamená, že bez jakéhokoli potlačování bychom pravděpodobně mohli implementovat řádově tisíce dvouqubitových gatů, než začnou dominovat chyby . Jiné chyby budou typicky dominovat při mnohem menších hloubkách, a naopak potlačování chyb se může vyplatit i při mnohem kratších časech, než jaké jsou potřeba k úplnému vymazání signálu.
Začneme použitím simulátoru s modelem šumu a poté porovnáme výsledky se skutečným hardwarem.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, thermal_relaxation_error
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_aer.primitives import EstimatorV2

pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)
Definujme si časový krok pro naše měření odpovídající hornímu odhadu času dvouqubitového gatu. Poté sestavíme 50 circuitů v přírůstcích tohoto časového kroku. Tímto způsobem uvidíme, co se děje v časovém měřítku podobném implementaci 80 dvouqubitových gatů. Přesnost zde není kritická, takže použijeme jen hrstku shotů.
n_points = 50  # We will show 50 steps
delay_unit = 80  # The delay in units of two-qubit-time from above
shots = 100
Sestavíme model šumu pro náš simulátor, který explicitně zahrnuje chyby tepelné relaxace.
# Create noise model with thermal relaxation for delays
noise_model = NoiseModel()
error = thermal_relaxation_error(
    t1, t2, two_q_gate_time * delay_unit
)  # error model characterized by times in ns
noise_model.add_all_qubit_quantum_error(error, ["delay"])

sim = AerSimulator(noise_model=noise_model)
Nyní sestavíme naše obvody a pozorovatelné veličiny (observables). Ty jsou výjimečně jednoduché. Obvody budou jednoduše spočívat v přípravě qubitu v a implementaci zpoždění o rostoucí dobu, s využitím výše definovaných charakteristických časů hradel a . Pozorovatelnou veličinou bude jednoduše , protože chceme vědět, zda qubit zůstal ve stavu , nebo se rozpadl do stavu . Ačkoli transpilace není u simulátorů vždy nutná, naše obvody zde přesto transpilujeme pro pozdější použití na skutečném backendu.
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times_sim = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        for j in range(i):
            qc.delay(delay_unit * two_q_gate_time, 0, "s")
            j = j + 1
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times_sim.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)
Spustíme naši úlohu pomocí simulátoru.
pubs = list(zip(circuits, obs))

# Create AerSimulator with noise model as backend
simulator = AerSimulator(noise_model=noise_model)

# Create SamplerV2 from the AerSimulator backend
estimator = EstimatorV2.from_backend(simulator)

# Run the sampler on the circuit, specify shots
job = estimator.run(pubs)
result = job.result()
Nakonec vykreslíme výstupy.
# Optional: color palette similar to 'mpl', style = 'clifford'

from cycler import cycler

plt.rcParams["axes.prop_cycle"] = cycler(
    color=[
        "#4C78A8",  # muted blue
        "#72B7B2",  # teal
        "#54A24B",  # green
        "#9C89CC",  # purple
        "#B279A2",  # mauve
    ]
)

# Everything else stays at Matplotlib defaults

# Example data: assume result is a list of objects with structure result[i].data.evs.item()
# and delay_times is already defined as a list of floats.

# Extract y-values
y_sim_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_sim_values = delay_times_sim

# Create the plot
plt.figure(figsize=(8, 5))
plt.plot(x_sim_values, y_sim_values, marker="o", linestyle="-", label="EV Data")

plt.xlabel("Idle Time (s)")
plt.ylabel("Probability of measuring |1>")
plt.title("T1 Decay")
plt.grid(True)
plt.show()
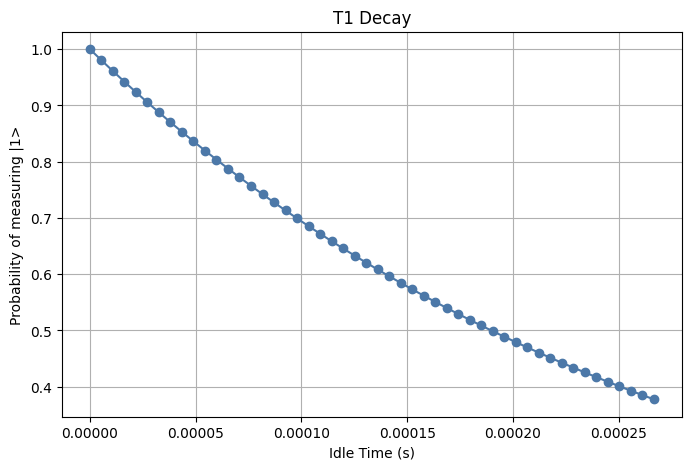
Exponenciální rozpad je zřetelně vidět a za tuto dobu klesne na těsně pod 40% šanci, že bude ve stavu . Všimni si, že to přesně odpovídá modelu: , kde jsme zvolili maximální ve stejném řádu jako ; připomeňme, že jsme řekli, že může odpovídat 60 gatům (nebo tomuto řádu velikosti), a zde odpovídá 60 gatům. Tedy
Nyní spusťme stejné circuity na skutečném kvantovém počítači. Abychom pokryli stejnou dobu zpoždění s menším počtem úloh, zvýšíme jednotku zpoždění a snížíme počet bodů.
# This took 27 s on ibm_boston

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same time parameters and shots
n_points = 10
delay_unit = 400
shots = 100

# Measure Pauli Z's as your observables
observables = [Pauli("Z")] * n_points
circuits = []
obs = []
delay_times = []
for i in range(n_points):
    qc = QuantumCircuit(1, 1)
    qc.x(0)
    if i > 0:
        qc.delay(delay_unit * two_q_gate_time * i, 0, "s")
    qc_opt = pass_manager.run(qc)
    circuits.append(qc_opt)
    delay_times.append(delay_unit * two_q_gate_time * i)
    observables_isa = observables[i].apply_layout(layout=qc_opt.layout)
    obs.append(observables_isa)

pubs = list(zip(circuits, obs))
estimator = EstimatorV2(mode=backend)
job = estimator.run(pubs=pubs)
result = job.result()

# To print the job id for later retrieval of data
# job_id = job.job_id()
# print(f"Job ID: {job_id}")
Nyní vykreslíme výsledky.
fig, ax = plt.subplots()

# Convert from the expectation value of Z to the probability of a transition
y_real_values = [(1 - r.data.evs.item()) / 2 for r in result]

# Use delay_times as x-values
x_real_values = delay_times

# Exponential decay to match theoretical model
t_smooth = np.linspace(0, x_sim_values[19], 100)  # Smooth x-range covering your data
y_decay = np.exp(-t_smooth / (t1))  # y = exp(-t/t1)
ax.plot(t_smooth, y_decay, "k--", linewidth=1, label=f"Perfect Decay (t1={t1:3f} s)")

# Add simulator values
ax.scatter(x_sim_values, y_sim_values, label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(x_real_values, y_real_values, label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Idle Time (s)")
ax.set_ylabel("Probability of measuring |1>")
ax.legend()
ax.set_title("T1 Decay")
ax.grid(True)

plt.show()
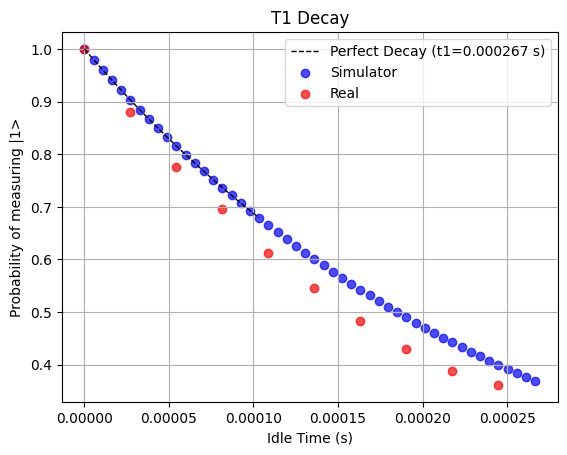
Jak vidíme, rozpad stavu v čase odpovídá teorii (a definici ). Simulátor navíc v tomto případě chování skutečného kvantového počítače napodobuje docela dobře. Zde je několik věcí, které je třeba mít na paměti ohledně rozpadu tohoto stavu:
- Měření jsme uměle zpozdili na nerealisticky dlouhou dobu. Tato zpoždění odpovídají časovému měřítku extrémně hlubokých circuitů, které by mohly sestávat z tisíců dvouqubitových gatů. Bylo to provedeno pouze proto, aby se ukázalo, že efekty tepelného šumu existují. Ve skutečných circuitech aplikovaných na reálné problémy by se operace prováděly na jiných qubitech, zatímco hrstka qubitů by mohla zůstat nečinná dostatečně dlouho na to, aby začaly hrát roli chyby energetické relaxace — ale ještě předtím, než by se dosáhlo plného , by dominovaly jiné chyby.
- Nebyly použity žádné techniky zmírňování ani potlačování chyb. Tuto rozpadovou křivku můžeme upravit pomocí technik, které se naučíme v tomto kurzu.
- Zde jsme použili pouze 100 shotů, což je neobvykle málo, protože jsme se snažili pouze ukázat, že efekt existuje. V aplikacích pravděpodobně použiješ více než 1 000 shotů.
Tato první vizualizace chyby vyžadovala téměř žádné gaty kromě zpoždění (a jediného gatu X použitého k přípravě ). Podívejme se nyní na další příklad, který se zaměřuje na chybu gatů.
Chyby gatů a jejich akumulace
Když aplikujeme kvantové hradlo, řekněme hradlo , toto hradlo teoreticky otočí kvantový stav o úhel radiánů kolem osy na Blochově sféře a zobrazí na pomocí
Skutečné hradlo je však nedokonalé. Může být nedokonale orientované (což způsobuje rotace, které nejsou přesně kolem osy X), nebo může způsobit o něco větší či menší rotaci, než bylo zamýšleno. Modelujme chybu hradla jako čisté nad/pod-otočení o malý úhel .
Pokud je nedokonalé hradlo aplikováno mnohokrát, malé chyby se mohou kumulovat. Někdy tyto opakované chyby dokonce způsobí, že se stav pokaždé posune stejným směrem (jev nazývaný „koherentní akumulace“, ke kterému se níže vrátíme). Podívejme se, co se stane, když aplikujeme skutečné hradlo X na qubit mnohokrát.
# This took 78 s on penguino1

from qiskit_ibm_runtime import EstimatorV2

# Explicitly use a pass manager with optimization level 0 so that we don't remove the delays
pass_manager = generate_preset_pass_manager(backend=backend, optimization_level=0)

# Use the same bit flips
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2(mode=backend)
results = estimator.run(pubs=pubs).result()
real_expectations = [pub_res.data.evs for pub_res in results]
# from qiskit_ibm_runtime import QiskitRuntimeService

# service = QiskitRuntimeService()           # uses stored IBM Quantum account
# job_id = "d5immof67pic7386l8eg"

# job = service.job(job_id)                 # retrieve the job
# results = job.result()                        # this is your .result() object
# Convert from the expectation value of Z to the probability of a transition
# y_real_values = [(1-r.data.evs.item())/2 for r in results]

# Create the plot
plt.figure(figsize=(8, 5))
# plt.plot(range(max_depth + 1), y_real_values, 'o-')
# plt.plot(x_real_values, y_real_values, marker='o', linestyle='-', color='blue', label='EV Data')
plt.plot(
    range(max_depth + 1),
    real_expectations,
    marker="o",
    linestyle="-",
    color="blue",
    label="EV Data",
)

plt.xlabel("Number of Flip-Back Cycles")
plt.ylabel("Expectation ⟨Z⟩")
plt.title("Accumulated Gate Noise Effects on Flips")
plt.grid(True)
plt.show()
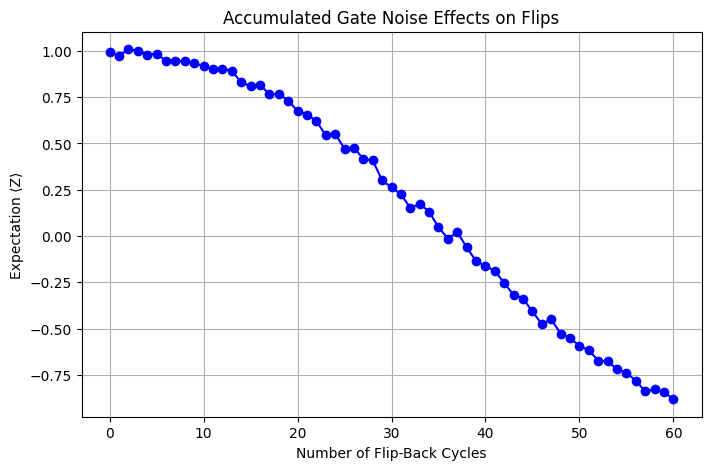
Očekávaná hodnota začíná okolo 1,0, jak se očekávalo, a klesá, ale neklesá jen k nule! Stává se zápornou. Pokud by šlo o tepelný šum nebo náhodné interakce, nezpůsobilo by to, že by bylo pravděpodobnější naměřit než . Tato chyba je zjevně jiná. A dává to smysl v kontextu naší diskuze o nad/pod-otočení. Pokud každý pár rotací, který by se měl vyrušit, ve skutečnosti skončí otočením o malý úhel, pak by mnoho takových opakování postupně umožnilo, aby se stav otáčel z směrem k .
Akumulace chyb zde ukázaná pravděpodobně neprobíhá tak čistě v reálném pracovním postupu. Jednak jsme záměrně vypnuli zmírňování chyb a provedli stejnou opakující se sekvenci hradel, aby se chyby mohly koherentně kumulovat. To je provedeno výhradně proto, abychom demonstrovali, že tyto chyby existují. Když používáme techniky pro zpracování šumu (například Pauliho twirling), můžeme ovlivnit, jak se chyba kumuluje, což často vede k nižší celkové chybě.
Můžeme přesně zjistit, jak dobře náš model této chyby odpovídá experimentálním datům, tím, že explicitně sestavíme model šumu a použijeme simulátor. V níže uvedeném modelu explicitně zabudujeme chybu odpovídající 0,025 radiánu. Nejedná se o žádné magické číslo; chybu lze prostě ladit, dokud přiměřeně nepopisuje experiment.
from qiskit_aer.noise import NoiseModel, coherent_unitary_error
from qiskit_aer import AerSimulator
import numpy as np

# For your SINGLE-QUBIT test on qubit 0, just override X error specifically
noise_model = NoiseModel.from_backend(backend, gate_error=True, thermal_relaxation=True)

theta_error = 0.025  # model over-rotation error around 0.01-0.03 radians
U_over = np.array(
    [
        [np.cos(theta_error / 2), -1j * np.sin(theta_error / 2)],
        [-1j * np.sin(theta_error / 2), np.cos(theta_error / 2)],
    ]
)

unitary_error = coherent_unitary_error(U_over)
# Target ONLY qubit 0 (your circuit) - no warning!
noise_model.add_quantum_error(unitary_error, ["x"], [0])

simulator = AerSimulator(noise_model=noise_model)
WARNING: quantum error already exists for instruction "x" on qubits (0,) , appending additional error.
max_depth = 60
circuits = []
observables = []

for depth in range(max_depth + 1):
    qc = QuantumCircuit(1)
    # Repeat flipping back and forth depth times
    for _ in range(depth):
        #    qc.x(0)
        qc.x(0)
        qc.barrier()
        qc.x(0)
        qc.barrier()
    circuits.append(qc)
    observables.append(Pauli("Z"))

pubs = list(zip(circuits, observables))

estimator = EstimatorV2.from_backend(simulator)
results = estimator.run(pubs).result()
expectations = [pub_res.data.evs for pub_res in results]  # no [0], use value directly
Nyní můžeme vykreslit skutečné a simulované křivky společně.
fig, ax = plt.subplots()

# Add simulator values
ax.scatter(range(max_depth + 1), expectations, c="blue", label="Simulator", alpha=0.7)

# Add real QC values
ax.scatter(range(max_depth + 1), real_expectations, c="red", label="Real", alpha=0.7)

# Add labels and plot
ax.set_xlabel("Number of Flip-Back Cycles")
ax.set_ylabel("Expectation ⟨Z⟩")
ax.set_title("Accumulated Gate Noise Effects on Flips")
ax.legend()
ax.grid(True)

plt.show()
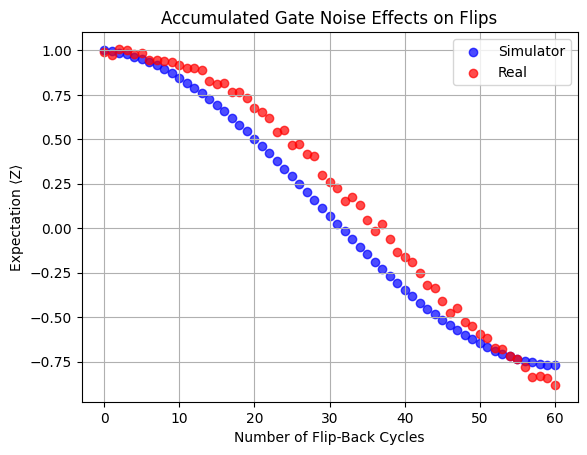
Chyba ve skutečném obvodu byla poměrně dobře popsána modelem chyby nad/pod-otočení. Je zřejmé, že různé druhy šumu a chyb se budou kumulovat odlišně a povedou k drasticky odlišným dopadům na věrnost našich kvantových obvodů. Proto je velmi důležité klasifikovat a charakterizovat chyby, které mohou nastat, formálněji, než jsme to dosud dělali.
Charakterizace kvantových chyb
Již jsme popsali některé zdroje kvantového šumu a mohli bychom chyby kategorizovat podle kategorií šumu, které je způsobují. Mohou však existovat i jiné kategorie kvantových chyb, které jsou užitečné při korekci a zmírňování chyb. Pokud je chceme opravit nebo zmírnit, potřebujeme například vědět, v jakém okamžiku chyby vznikají a jak se kumulují. Při určování, kde (v jakých procesech) chyby vznikají, je běžnou důležitou kategorií chyby přípravy stavu a měření (zkráceně SPAM chyby). Termín „příprava stavu“ zde neznamená vše, co se se stavem dělá při jeho přípravě na měření. Spíše se vztahuje na inicializaci qubitů, „přípravu“ qubitů pro provedení algoritmu, a tato kategorie SPAM tedy vylučuje například chyby hradel během provádění algoritmu.
Dalším důležitým rozlišením je, zda jsou chyby koherentní, nebo nekoherentní. Stručně shrnuto (podrobněji je probereme níže), koherentní chyby jsou typicky modelovány unitárními operacemi a zachovávají čistotu stavu. Nekoherentní chyby jsou modelovány neunitárními kvantovými kanály a obecně čistotu stavu snižují. Nekoherentní chyby si lze snadno představit jako tepelné interakce, které způsobují ztrátu kvantové informace, ale ve skutečnosti mohou být způsobeny jakoukoli náhodnou vazbou na okolí. Jako příklad koherentní chyby uvažme, že při implementaci hradla RY dojde k nedokonalosti v orientaci pulzu takové, že hradlo ve skutečnosti způsobí . Taková nedokonalost by vždy způsobila chybnou rotaci kolem X ve stejném směru. To by byla koherentní chyba.
Všimni si, že SPAM chyby zahrnují směs koherentních chyb, jako jsou systematické chyby řízení, a nekoherentních chyb, jako je ztráta fotonů a tepelné jevy. Jelikož jde o více kroků a zdrojů chyb, SPAM chyby jsou nejlépe popsány jako kombinace koherentních i nekoherentních chyb.
SPAM chyby
Jak název napovídá, SPAM chyby vznikají ve dvou odlišných fázích kvantového experimentu: při počáteční přípravě a při vyčítání/měření. Chyby přípravy stavu nastávají, když hardware nedokáže spolehlivě inicializovat qubity do požadovaného výchozího stavu ( u kvantových počítačů IBM). Mezi příčiny patří:
- tepelná excitace (skutečné qubity nejsou dokonale chlazené a mohou občas začínat ve stavu místo )
- zbytkové fotony nebo šum v rezonátorech u supravodivých qubitů
- drifty v kalibraci, které ovlivňují, jak přesně jsou qubity resetovány
Chyby měření nastávají během procesu vyčítání, kdy měřicí aparatura nesprávně identifikuje stav qubitu. Mezi zdroje patří:
-
šum vyčítacího zesilovače způsobující záměnu mezi a
-
relaxace qubitu během vyčítání (například qubit ve stavu se rozpadne do těsně před měřením nebo během něj)
-
přeslechy mezi vyčítacími linkami: čtení jednoho qubitu mírně ovlivňuje čtení sousedních qubitů
-
nedokonalé diskriminační prahy v měřicích systémech IBM založených na rezonátorech
SPAM chyby jsou primárně nekoherentní. Chyby přípravy se chovají jako náhodné směsi excitovaných a základních stavů. Chyby měření se chovají jako klasická záměna: s pravděpodobností je nahlášen jako nebo naopak. Ty se liší od koherentních unitárních chyb (jako jsou nesprávně kalibrovaná hradla způsobující systematické fázové posuny). SPAM chyby se místo toho podobají náhodnému klasickému šumu, ačkoli ve vyčítání mohou existovat i vzácné koherentní odchylky.
SPAM chyby mohou být problematické pro randomizovaný benchmarking nebo pro mělké obvody, kde příprava stavu a měření představují velkou část celkové chyby. U velmi hlubokých obvodů, zejména s mnoha dvouqubitovými hradly, jsou menším problémem.
Matematicky lze SPAM chyby popsat jako produkci zašuměného rozdělení , které souvisí s ideálním rozdělením prostřednictvím matice :
Zde je pravděpodobnost naměření bitového řetězce a je pravděpodobnost získání stavu , když měl být stav připraven ve stavu . Představ si to v kontextu vzorkovaných bitových řetězců ze Sampleru. Tvé naměřené rozdělení stavů bude sestávat z mnoha přesných měření, ale i z některých měření, u nichž instrukce pro přípravu stavu neodpovídají pozorovanému stavu. To znamená, že pravděpodobnosti budou mírně posunuté.
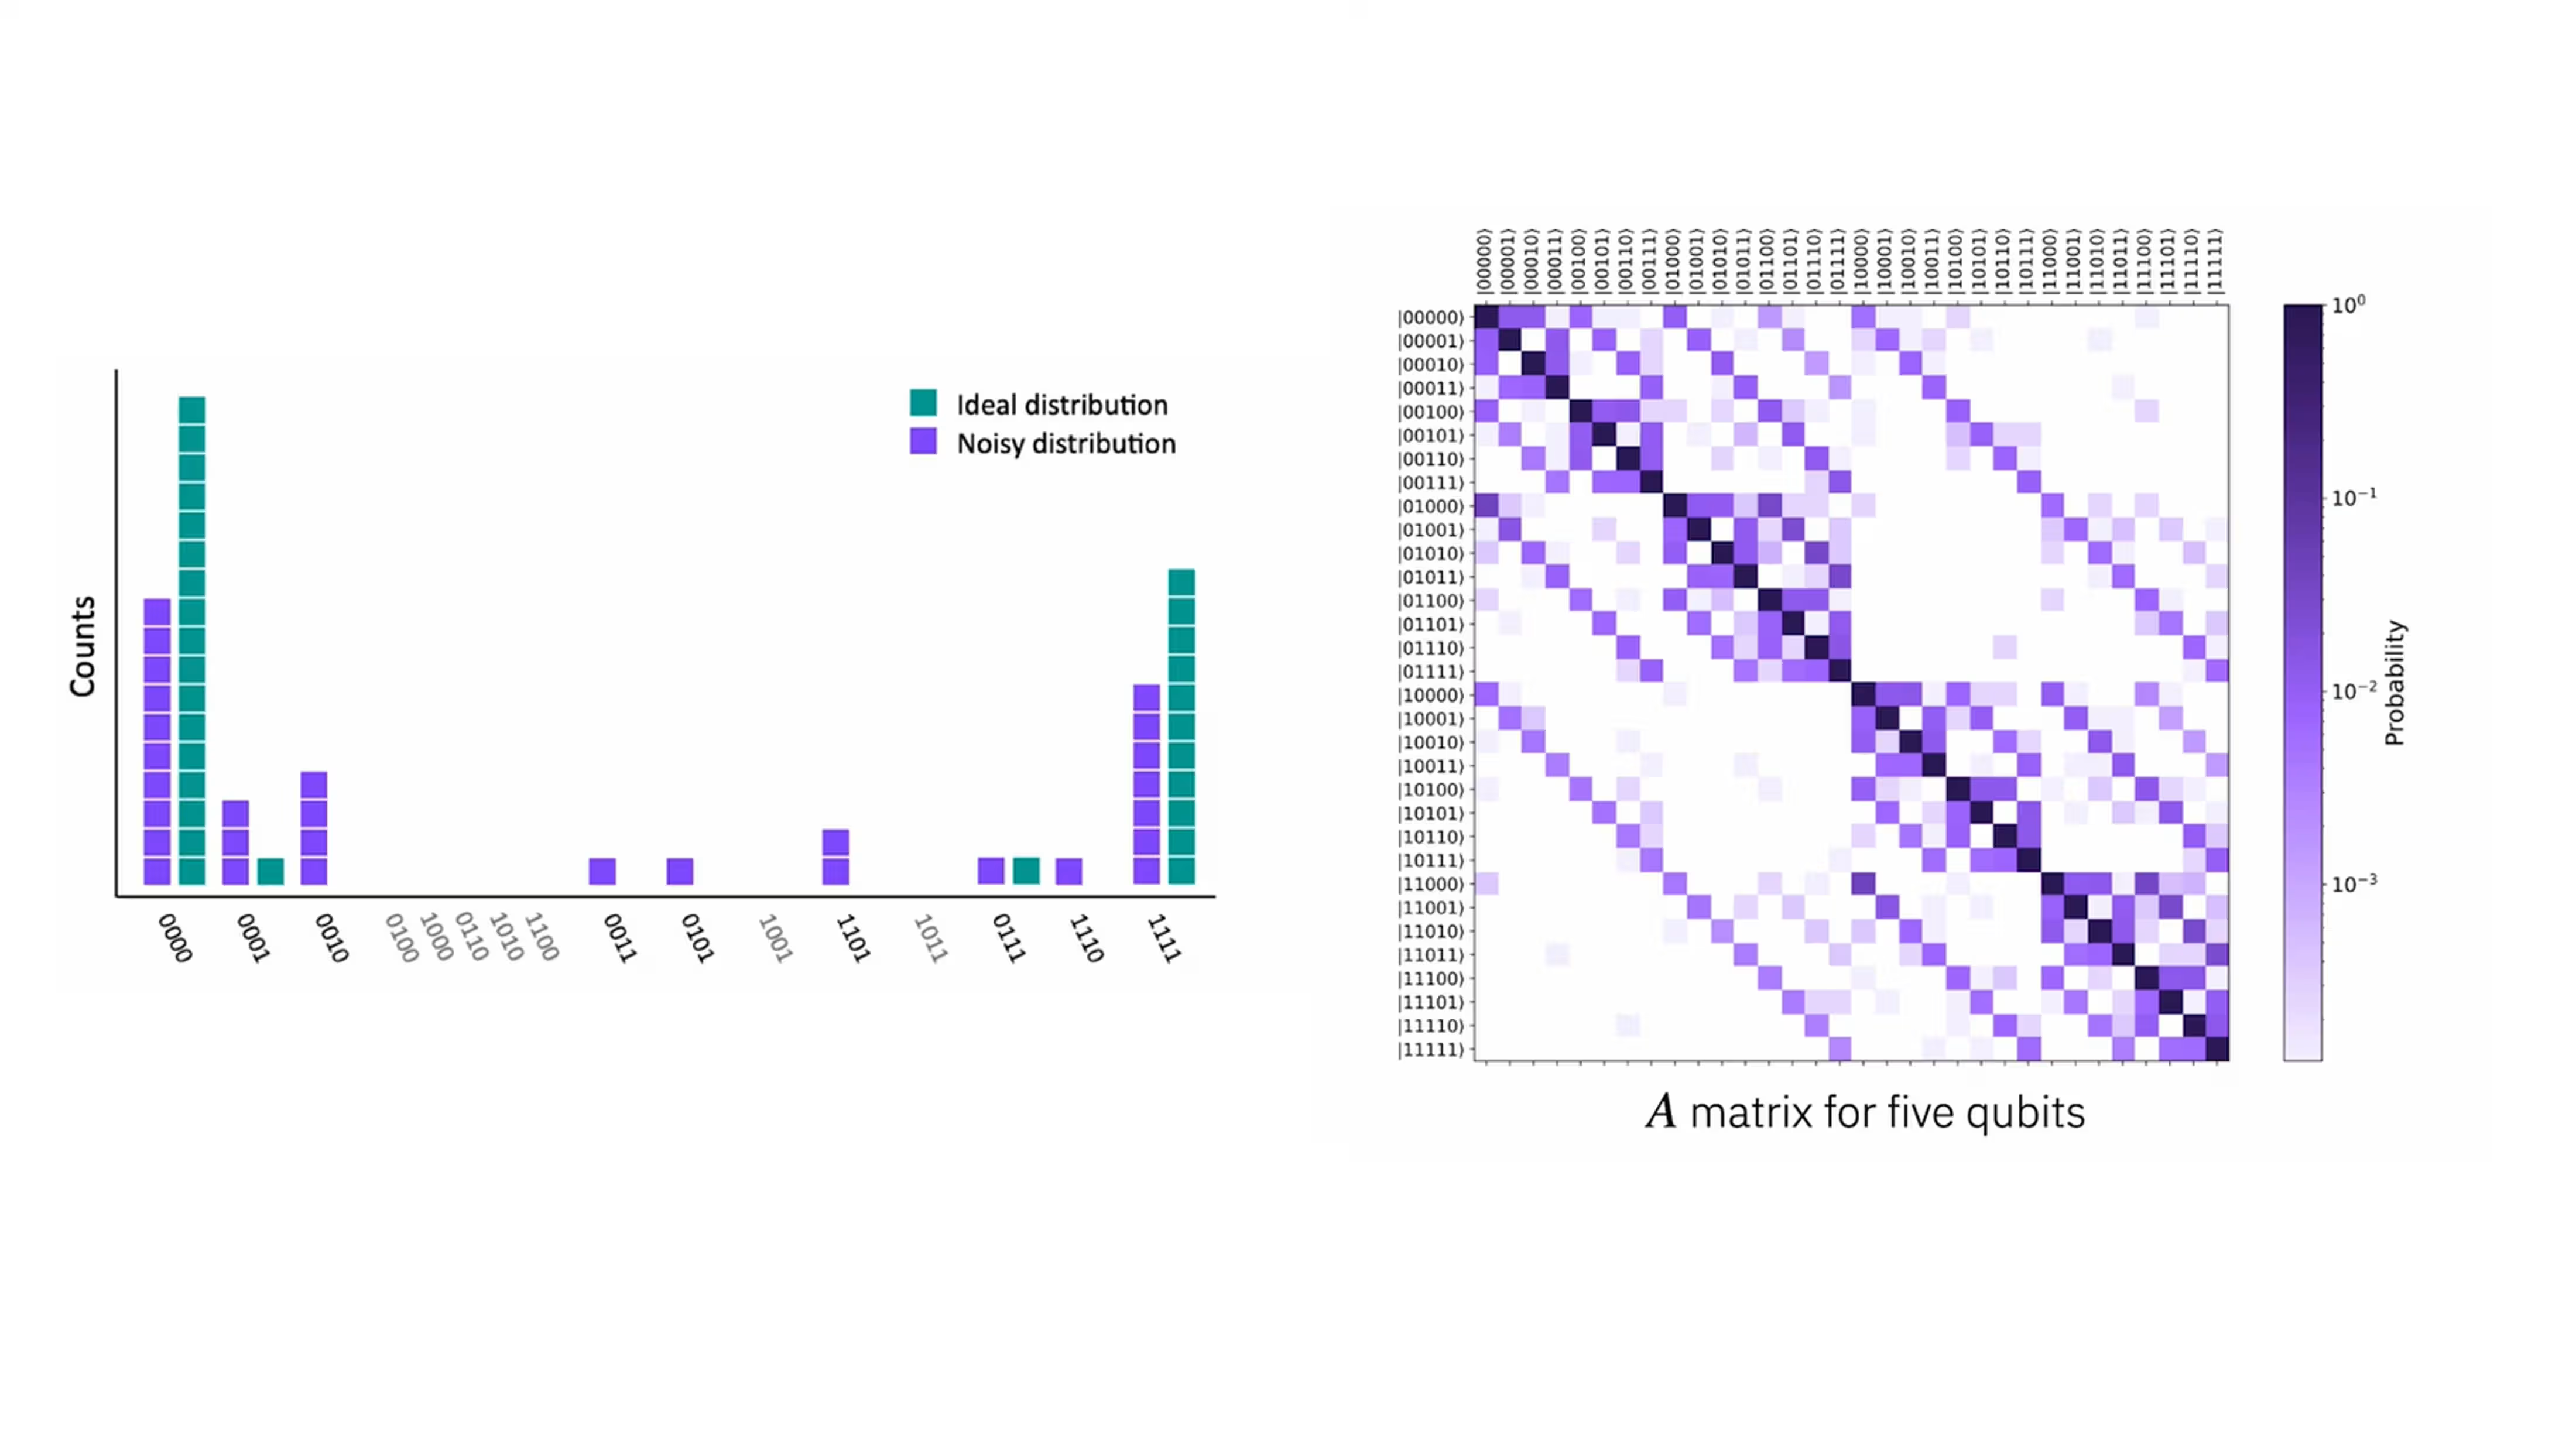
Na obrázku výše část (a) ukazuje ideální rozdělení stavu GHZ modrozelenou barvou a skutečná měření fialovou barvou. V části (b) vidíme příklad matice . Všimni si, že matice není dokonale symetrická podle diagonály, protože každý qubit nemusí mít stejnou pravděpodobnost chybného vrácení 0 i chybného vrácení 1. V praxi je často obtížné oddělit chyby přípravy a chyby vyčítání, takže jsou často kombinovány do jednoho společného zpracování (odtud běžné používání pojmu SPAM).
Jedním ze způsobů korekce těchto SPAM chyb je použití jednoduchých obvodů se známými ideálními výsledky měření a jejich porovnání s naměřenými výsledky za přítomnosti SPAM chyb. To lze použít ke zpětnému odvození ideálních výsledků složitějších obvodů. U obecných stavů s vysokou entropií by to mohlo vyžadovat sestavení matice s pravděpodobnostmi, ale v méně extrémních případech lze tyto chyby zmírnit.
Koherentní chyby versus nekoherentní chyby
Koherentní chyby jsou systematická, deterministická a unitární chybná otočení kvantového stavu. Vznikají z nedokonalých kvantových operací, které se odchylují předvídatelným způsobem. Mezi příklady patří drobné chyby v rotaci prováděné jednoqubitovými rotačními hradly, včetně těch způsobených driftem kalibrace, které by důsledně nad- nebo pod-otáčely. Matematicky bychom mohli napsat, že skutečné rotační hradlo, řekněme , je dáno ideálním rotačním hradlem plus nějakou další chybou:
pro nějaké malé pod- či nad-otočení . Mezi další příklady patří dvouqubitové hradlo přidávající malý nežádoucí fázový posun a řídicí pulzy, které se systematicky odchylují od ideálního tvaru.
Klíčovou charakteristikou koherentních chyb je, že jsou deterministické a lze je samy modelovat unitárními hradly. Odpovídajícím způsobem zachovávají čistotu kvantového stavu: kvantová informace se neztrácí, byla pouze zpracována nedokonale. Dalším důležitým bodem, který je třeba poznamenat, je, že opakované koherentní chyby interferují konstruktivně a někdy rostou kvadraticky s počtem hradel.
Tyto chyby jsou někdy předvídatelné, a lze je tedy do určité míry kalibrací odstranit. Zbývající koherentní chyby se však mohou rychle kumulovat a způsobovat problematické odchylky od ideálních stavů. To znamená, že je někdy výhodné koherentní chyby záměrně „randomizovat“. Tento postup a jeho užitečnost budou probrány v lekci o zmírňování chyb.
Proč jsou problematické
Koherentní chyby se mohou nebezpečným způsobem „hromadit“ a způsobovat velké odchylky od správného stavu, pokud nejsou randomizovány nebo opraveny.
Nekoherentní chyby jsou stochastické, náhodné a často neunitární. Vznikají z interakcí s okolím nebo z nekontrolovaných zdrojů šumu. Některé příklady jsme již viděli: energetická relaxace / rozpad je nekoherentní. Stejně tak stochastický šum hradel, tepelný šum a chyba měření.
Klíčovým rysem nekoherentních chyb je, že nejsou při každém provedení operace stejné. Jsou neunitární, takže je nelze modelovat jednoduchým unitárním kvantovým hradlem, jako to bylo možné u koherentních chyb. Jelikož jsou nekoherentní, typicky se kumulují lineárně jako náhodný šum, nikoli jako systematické nad-otočení.
Nekoherentní chyby způsobují, že qubity nevratně ztrácejí informaci (ztráta čistoty a fázové informace).
Která z nich je tedy horší? Jako u většiny věcí v kvantovém počítání to záleží. Ponaučení je, že koherentní chyby se kumulují rychleji a nelineárně (což je špatné). Lze je ale částečně kalibrací odstranit a fázová informace je ve tvém systému stále přítomna, pokud přijdeš na to, jak ji správně extrahovat. Nekoherentní chyby se kumulují lineárně, což je výhodné ze dvou důvodů: je to pomalejší než koherentní kumulace a je poměrně snadné vidět, jak se efekty nekoherentních chyb škálují u procesů, jako je extrapolace k nulovému šumu (ZNE), která bude probrána v lekci o zmírňování chyb. Když ale nekoherentní chyby nastanou, kvantová informace je skutečně ztracena, nikoli jen zastřena.
Matice hustoty a kvantové kanály
V následujících částech se ponoříme hlouběji do několika typů koherentních a nekoherentních chyb a uvidíme, jak je lze matematicky modelovat pomocí kvantových kanálů. Nejprve je na místě stručné opakování matic hustoty a kvantových kanálů. Pro úplné a rigorózní zpracování tohoto tématu se podívej na kurz Johna Watrouse General formulation of quantum information na IBM Quantum Learning. Zdejší výklad bude veden na příkladech a méně formální.
Kvantové kanály jsou nejobecnějším způsobem popisu toho, jak se kvantový systém vyvíjí, jak interaguje a jak je vystaven šumu. Pokud jsi zvyklý/á na čisté stavy a unitární vývoj, kvantové kanály jsou přirozeným dalším krokem.
Ve standardní kvantové mechanice se „čistý“ stav zapisuje jako . Zde „čistý“ odkazuje na čistotu informace neboli znalost přípravy stavu; neznamená to vlastní stav nějakého systému. Jako příklad qubitu, je čistý stav, protože máme dokonalou znalost relativních amplitud a fáze. Časový vývoj takového čistého stavu se řídí unitárním operátorem :
podle Schr"odingerovy rovnice, kde , přičemž je hamiltonián systému a je redukovaná Planckova konstanta, často „položená rovna jedné“, nebo přesněji řečeno, zahrnutá do hamiltoniánu tak, že všechny energie jsou udávány v jednotkách .
Unitární vývoj je vratný, deterministický a izolovaný. To je ale nedostatečné pro popis reálných kvantových systémů. V reálných kvantových systémech:
- Provádíme měření, která zkolabují kvantový stav do vlastního stavu systému. To je explicitně neunitární.
- Systém interaguje s okolím. To znamená, že systém není skutečně izolovaný, a protože okolí nelze sledovat do nekonečna, odpovídá to ztrátě informace.
- Prakticky řečeno: šum narušuje stav. A další jevy.
Samotný unitární vývoj nedokáže tyto procesy popsat; potřebujeme tedy obecnější reprezentaci kvantových stavů a procesů. Smíšený stav popisuje klasické rozdělení kvantových stavů. To znamená, že už víme, že kvantový stav má 50% šanci, že bude naměřen (zkolabuje na klasickou informaci) ve stavu , a 50% šanci, že bude naměřen ve stavu . Tvrzení ale je, že počáteční kvantový stav je přesně se 100% pravděpodobností. Nyní chceme na kvantově-mechanickou pravděpodobnost navrstvit klasickou pravděpodobnost, například:
Počáteční kvantový stav je připraven ve stavu s 25% klasickou pravděpodobností a je připraven ve stavu se 75% klasickou pravděpodobností (všimni si odlišných relativních fází).
Někdy to může být kvůli explicitním klasickým pravděpodobnostem v přípravě; jindy to může být kvůli provázání s částmi okolí, které ignorujeme. Tak či onak je jasná potřeba nástroje pro popis tohoto klasického rozdělení kvantově-mechanických stavů. Samotné čisté stavy nedokážou tyto možnosti reprezentovat. Proto zavádíme matici hustoty.
Smíšený stav je popsán operátorem hustoty:
Zde je kvantový stav (ne nutně vlastní stav nějakého konkrétního operátoru) a je klasická pravděpodobnost, že je systém připraven ve stavu . Toto je dobrý předpis pro sestavení matice hustoty ze známého klasického rozdělení kvantových stavů. Na druhou stranu bychom mohli chtít znát, s ohledem na klasické rozdělení kvantových stavů i kvantově-mechanickou pravděpodobnost různých výsledků měření, jaká je pravděpodobnost, že měření vydá konkrétní stav (například , nebo jiné stavy, pokud je zapojeno více qubitů). Právě zde je matice hustoty obzvlášť užitečná. Můžeme ji také zapsat v bázi jako:
Zde diagonální prvky jsou pravděpodobnosti:
-
= pravděpodobnost, že qubit je ve stavu
-
= pravděpodobnost, že qubit je ve stavu
Jsou reálné, nezáporné a součet dává 1.
Mimodiagonální prvky jsou koherence: fázové vztahy nebo schopnost interference, a obecně odpovídají tomu, kolik kvantově-mechanické informace je ve stavu obsaženo. Toto je neformální tvrzení, ale podívejme se, co znamená v praxi.
Příklad
Uvažuj čistý stav . (a) Co víš o pravděpodobnostech měření a fázové informaci, aniž bys prováděl/a jakýkoli výpočet? (b) Sestav matici hustoty a ověř svou intuici.
Solution:
(a) Protože se jedná o čistý stav, existuje jen jedna možná fáze mezi a : +1. Jde o dokonalou fázovou informaci, takže očekáváme, že mimodiagonální prvky naší matice hustoty budou velké. O mimodiagonálních prvcích možná máš i hlubší intuici, ale pro teď to stačí. Dále jsou amplitudy obou bázových stavů stejné, takže očekáváme 50% pravděpodobnost naměření buď , nebo . Očekáváme tedy, že diagonální prvky budou 1/2. (b) Pomocí definice výše:
pouze pro stav . Můžeme tedy psát
Diagonální prvky jsou, jak se očekávalo, každý a mimodiagonální prvky jsou velké (jejich součet dává jedna).
Nyní se podívejme, co se stane, když nemáme dobrou fázovou informaci.
Příklad
Uvažuj podobný případ, ale nyní s 50% klasickou pravděpodobností nacházet se ve stavu a 50% klasickou pravděpodobností nacházet se ve stavu . Stejné dvě otázky: (a) Co víš o pravděpodobnostech měření a fázové informaci, aniž bys prováděl/a jakýkoli výpočet? (b) Sestav matici hustoty a ověř svou intuici.
Solution:
(a) Jako předtím jsou amplitudy obou bázových stavů stejné, takže očekáváme 50% pravděpodobnost naměření buď , nebo . Očekáváme tedy, že diagonální prvky budou 1/2. Tentokrát ale existují dvě opačné možnosti pro fázi mezi a : +1 a -1, přičemž každá je stejně pravděpodobná. Dalo by se očekávat, že se dvěma stejně pravděpodobnými opačnými fázemi máme jen malou nebo žádnou fázovou informaci. Dalo by se očekávat, že mimodiagonální prvky budou malé. (b) Opět pomocí definice výše
pouze pro dva stavy a . Můžeme tedy psát
Mimodiagonální prvky jsou malé, ve skutečnosti nulové, jak se očekávalo. Diagonální prvky jsou stále 50 % každý, což dává smysl, protože každý ze stavů ve směsi měl a zastoupeny stejnou vahou.
Tento konstrukt se stává zajímavějším s rostoucím počtem qubitů. Prozkoumej to v otázkách níže.
Ověř si své porozumění
Napiš matici hustoty pro čistý Bellův stav .
Odpověď
pouze pro stav . Můžeme tedy psát
Napiš matici hustoty pro 25% klasickou pravděpodobnost a 75% klasickou pravděpodobnost .
Odpověď
pouze pro dva stavy a . Můžeme tedy psát
Uprav svůj postup z předchozí otázky a napiš matici hustoty pro 50% klasickou pravděpodobnost a 50% klasickou pravděpodobnost . Předpověz, jaká fázová informace by měla zůstat zachována.
Odpověď
pouze pro dva stavy a . Můžeme tedy psát
Diagonální členy dávají součet 1, jak musí. Mimodiagonální členy se zde nevyruší, jak tomu bylo v předchozím příkladu s jedním qubitem. Důvod lze vidět v matematice, ale zkrácené vysvětlení je, že nyní máme v našem Hilbertově prostoru více stavů. Ačkoli první Bellův stav měl kladnou relativní fázi a druhý zápornou, tyto fáze byly mezi různými bázovými stavy. První Bellův stav měl fázi mezi a , zatímco druhý měl relativní fázi mezi a .
Kvantové kanály
Kvantový kanál je nejobecnější fyzikálně přípustnou transformací kvantového stavu. Převádí počáteční matici hustoty na jinou matici hustoty:
Zde znamená kvantový kanál působící na matici hustoty , což nelze zaměňovat s Bellovými stavy nebo .
Kvantové kanály jsou extrémně obecné. Mohou zahrnovat:
-
unitární vývoj
-
pravděpodobnostní směsi unitárních operací
-
Measurements
-
Decoherence
-
tlumení amplitudy (ztráta energie)
-
defázování (ztráta fázové informace)
-
interakce s okolím A mnoho dalších věcí.
Jedním ze způsobů, jak přemýšlet o kvantových kanálech, je, že jsou pro matice hustoty tím, čím jsou unitární operace pro čisté stavy. Obecnost matic hustoty ale umožňuje, aby odpovídající kvantové kanály byly mnohem obecnější, a tedy silnější.
Jedinými omezeními na kvantový kanál jsou, že musí být:
- Lineární Směsi stavů by se měly vyvíjet konzistentně:
- Zcela pozitivní Neměl by produkovat záporné pravděpodobnosti, ani pokud je tvůj systém provázán s něčím jiným.
- Zachovávající stopu Pravděpodobnosti se musí sčítat na 1. Tyto vlastnosti se někdy shromažďují pod zkratkou CPTP: Completely Positive Trace-Preserving maps (zcela pozitivní zobrazení zachovávající stopu).
Existují různé reprezentace kvantových kanálů, včetně Stinespringovy, Krausovy a Choiho reprezentace. Ty jsou podrobně probrány v této lekci o kvantových kanálech v kurzu General formulation of quantum information a je tam také ukázáno, že jsou ekvivalentní. My se do těchto různých reprezentací zde pouštět nebudeme. Stačí říct, že jsou obdobou popisu vektorů pomocí tří různých souřadnicových soustav. Každá může zdůrazňovat jiné aspekty a budovat intuici jiným způsobem; ale všechny ti dají správnou odpověď. Krausovy reprezentace jsou pro naše účely vhodné. Nabízejí pohodlný formulovatelný způsob, jak vyjádřit působení kanálu pomocí maticového násobení a sčítání. Konkrétně Krausova reprezentace je specifikace kanálu v následujícím tvaru.
Zde jsou matice, které mají všechny stejné rozměry: jejich sloupce odpovídají klasickým stavům vstupního systému a jejich řádky odpovídají klasickým stavům výstupního systému, ať už je to , nebo nějaký jiný systém . Aby byl platným kanálem, musí tyto matice splňovat následující podmínku.
Tyto matice se nazývají Krausovy matice. Tato formulace je použitelná nejen pro kanály šumu, ale pro obecné kvantové procesy a kanály, včetně měření. Podívejme se na příklad toho, jak je lze použít k sestavení kanálů v kontextu šumu a chyb.
Zcela defázující kanál
Uvažuj kanál, který ničí veškerou fázovou informaci, a nazvi jej zcela defázující kanál. To znamená, že by tento kanál měl vzít libovolnou matici hustoty ve tvaru
a zobrazit ji na
Pokud předpokládáme, že matice hustoty už byla zapsána ve výpočetní bázi, můžeme vyjádřit jako . To naznačuje množinu Krausových matic, které dokážou tuto akci kanálu provést: . Aplikujme tuto strategii na příkladový případ jednoho qubitu a podívejme se, jestli funguje tak, jak požadujeme:
Zvol a .
Protože je číslo, můžeme jednoduše přesunout vektor za něj. To platí i pro druhý člen. Máme:
Všimni si, že tyto matice splňují požadovanou podmínku:
Stojí za zmínku, že tato volba Krausových matic není jednoznačná.
Charakterizace šumu jako kanálů
V této části použijeme model Blochovy sféry a matematiku kvantových kanálů, abychom lépe pochopili různé typy šumu a chyb.
Nekoherentní chyby
Vraťme se k nekoherentním chybám a podívejme se konkrétně na chyby energetické relaxace. Připomeňme, že stav je základní stav qubitu a stav má o něco vyšší energii. Kvantové stavy někdy jednoduše spontánně přejdou z vyšší energetické hladiny na nižší. Proces spontánní emise je bohaté téma a nelze mu skutečně porozumět bez použití kvantové teorie pole. Intuice je nám ale všem velmi dobře známá: náhodné poruchy mohou způsobit, že kámen sklouzne z kopce dolů; nezpůsobí, že kámen vyjede do kopce nahoru. Jak dlouho qubit zůstává ve vyšším energetickém stavu, je charakterizováno časem . Konkrétněji, pravděpodobnost, že qubit připravený ve stavu zůstane v tomto stavu po čase , je . Ekvivalentně, pravděpodobnost chyby energetické relaxace po čase je
Abychom to popsali pomocí kvantového kanálu v Krausově reprezentaci, potřebujeme Krausovy matice, které odpovídají
- ponechání stavů beze změny
- změně stavů na s určitou pravděpodobností p.
Definujme
Nejprve ověřme, že to má požadovaný účinek na matici hustoty. Uvažujme systém, který je v čistém stavu . Ve výše uvedeném příkladu jsme viděli, že matice hustoty pro tento případ je
Aplikací kanálu energetické relaxace pomocí Krausových matic získáme novou, zobrazenou matici hustoty:
Prozkoumejme to a porovnejme to s naší intuicí:
Nejprve ověřme limitu, kdy se blíží nule. Získáme zpět naši počáteční matici hustoty, jak by mělo být:
S postupem času bychom očekávali, že pravděpodobnost naměření stavu poroste a pravděpodobnost naměření stavu bude klesat. To je opět přesně to, co vidíme, protože
Také triviálně vidíme, že pravděpodobnosti naměření a se sčítají na 1, jak musí.
Přesné škálování koherenčních (mimodiagonálních) členů přesahuje rámec tohoto výkladu. Je ale jasné, že na začátku máme dokonalou fázovou informaci a po velmi dlouhé době nemůže existovat žádná fázová informace, protože systém je zcela relaxovaný do stavu . Koherenční členy proto musí po velmi dlouhé době klesnout k nule. Skutečně,
Mnohá omezení kladená na naše Krausovy matice jsou implicitně ověřena těmito intuitivními úvahami. Je třeba důkladně ověřit, že omezení na kanály (a konkrétně na Krausovy matice) jsou splněna, ale to ponecháváme jako cvičení pro čtenáře.
Graficky lze tento typ kanálu znázornit pomocí Blochovy sféry. Čistý stav leží na povrchu Blochovy sféry. Smíšené stavy se posouvají do vnitřku sféry a rozšiřují se z jediného bodu. Zahrnutí klasických pravděpodobností se projevuje zmenšením absolutní vzdálenosti od počátku k libovolnému ze stavů ve směsi a rozšíření z jediného bodu do oblasti naznačuje mísení více možných stavů. Ve speciálním případě kanálu energetické relaxace by smíšený stav (matice hustoty) po nezanedbatelném čase vypadal jako na obrázku níže: oblast uvnitř Blochovy sféry, posunutá nahoru směrem k pólu a zmenšená jak podél osy , tak podél roviny , i když v menší míře než podél .

Všimni si, že tato oblast není „čepičkou“ Blochovy sféry, jak se někdy jeví v perspektivním zobrazení. Jak je jasně vidět ve videu, jedná se o zploštělý sferoid, zmenšený a posunutý směrem ke stavu . Šumové kanály (a kanály obecně) jsou samozřejmě použitelné pro systémy libovolné velikosti. Jejich vizuální znázornění (například pomocí Blochovy sféry) se ale stává obtížným s tím, jak roste počet vzájemně ortogonálních stavů v Hilbertově prostoru.
Ověř si své porozumění
Ověř, že Krausovy matice použité ve výše uvedeném kanálu energetické relaxace splňují podmínku identity:
Odpověď
Představíme ještě dva další typy nekoherentních šumových kanálů, ale většinu interpretace a ověření ponecháme jako cvičení. Dalším je defázující kanál, který popisuje ztrátu fázové informace při zachování amplitud. Ačkoli se na celkové pravděpodobnosti měření mohou stále podílet jak klasické, tak kvantově mechanické pravděpodobnosti, ztráta fázové informace se často popisuje jako ztráta kvantové informace nebo jako to, že se systém stává klasičtějším.
Podobně jako byla energetická relaxace popsána charakteristickým časem , dephasingové chyby jsou popsány druhým časovým parametrem . Pravděpodobnost dephasingové chyby po čase je dána vztahem
Sada Krausových matic pro defázující kanál na jednom qubitu, vyjádřená pomocí této pravděpodobnosti, je následující:
Výsledek tohoto dephasingového kanálu je znázorněn pomocí Blochovy sféry na obrázku níže.

Všimni si, že amplitudy se nemění, takže jakékoli stavy padající přesně na pól ( nebo ) zůstávají nedotčeny a jsou stále zobrazeny na povrch sféry ve stínované oblasti. Fázová informace se ale ztrácí, což odpovídá zmenšení stínované oblasti napříč rovinou . Jedním ze způsobů, jak to pochopit, je: každý možný kvantový stav může stále mít dobře definovanou fázi, ale protože existuje klasická pravděpodobnost nalezení několika stavů s různými dobře definovanými fázemi, celková pravděpodobnost kterékoli jedné dobře definované fáze je snížena.
Ověř si své porozumění
Ověř, že výše definované Krausovy matice pro defázující kanál splňují podmínku identity:
Odpověď
Začni s jednoqubitovým čistým stavem podle vlastního výběru, s dobře definovanou fází mezi a . Zapiš jej jako matici hustoty. Aplikuj defázující kanál pomocí výše navržených Krausových operátorů. Interpretuj výslednou, zobrazenou matici hustoty.
Odpověď
Zvolme stav . Odpovídající matice hustoty je
Nyní aplikujeme defázující kanál na tuto matici hustoty pomocí Krausových operátorů.
Nejprve si všimněme, že součet diagonálních prvků je skutečně roven jedné, jak musí být. Za druhé si všimni, že mimodiagonální prvky byly zpočátku velké, se součtem 24/25, což naznačuje silnou koherenci. Všimni si, že s rostoucí pravděpodobností defázující chyby tyto mimodiagonální prvky klesají. To také odpovídá našemu očekávání. Jedna jemnost: všimni si, co se stane, když . Koherence se opět stává silnou! Zprvu se to zdá kontraintuitivní, protože vysoká pravděpodobnost defázující chyby by přece měla naši fázi rozhodit, ne? Háček je v tom, že pokud jsme si na 100 % jisti, že k fázové chybě dojde, máme opět silnou informaci o fázi; fáze se prostě obrátila. S tímto poznatkem bychom mohli očekávat, že nejhorší fázová informace odpovídá 50% pravděpodobnosti výskytu fázové chyby, a přesně to také zjišťujeme.
Naším posledním příkladem šumového kanálu popisujícího nekoherentní chyby je Pauliho šumový kanál. Tento kanál popisuje výskyt tří typů chyb s nezávislými pravděpodobnostmi:
- chyba překlopení bitu (X chyba) s pravděpodobností
- chyba překlopení fáze (Z chyba) s pravděpodobností
- kombinace X a Z (Y chyba) s pravděpodobností Zde platí pro všechna . Důsledkem je, že pravděpodobnost nevýskytu žádné chyby je .
Krausovy operátory pro tento kanál jsou:
V případě Pauliho šumového kanálu je poučné vypsat samotný kanál:
Z tohoto tvaru vidíme, že Pauliho šumový kanál implementuje jednu nebo více chyb odpovídajících působení Pauliho matic , každou s pravděpodobností .
Různé kombinace pravděpodobností překlopení vytvoří odlišné vizualizace. Zde vizualizujeme speciální případ, kdy , nazývaný také depolarizační kanál.

Modelování koherentních chyb
Kvantové kanály mohou reprezentovat jak koherentní, tak nekoherentní chyby, ale v praxi se používají hlavně pro nekoherentní chyby, protože koherentní chyby se lépe modelují jako unitární chyby kalibrace nebo se pro snazší analýzu převádějí na stochastické kanály. V této části představíme přístupy vhodnější pro koherentní chyby.
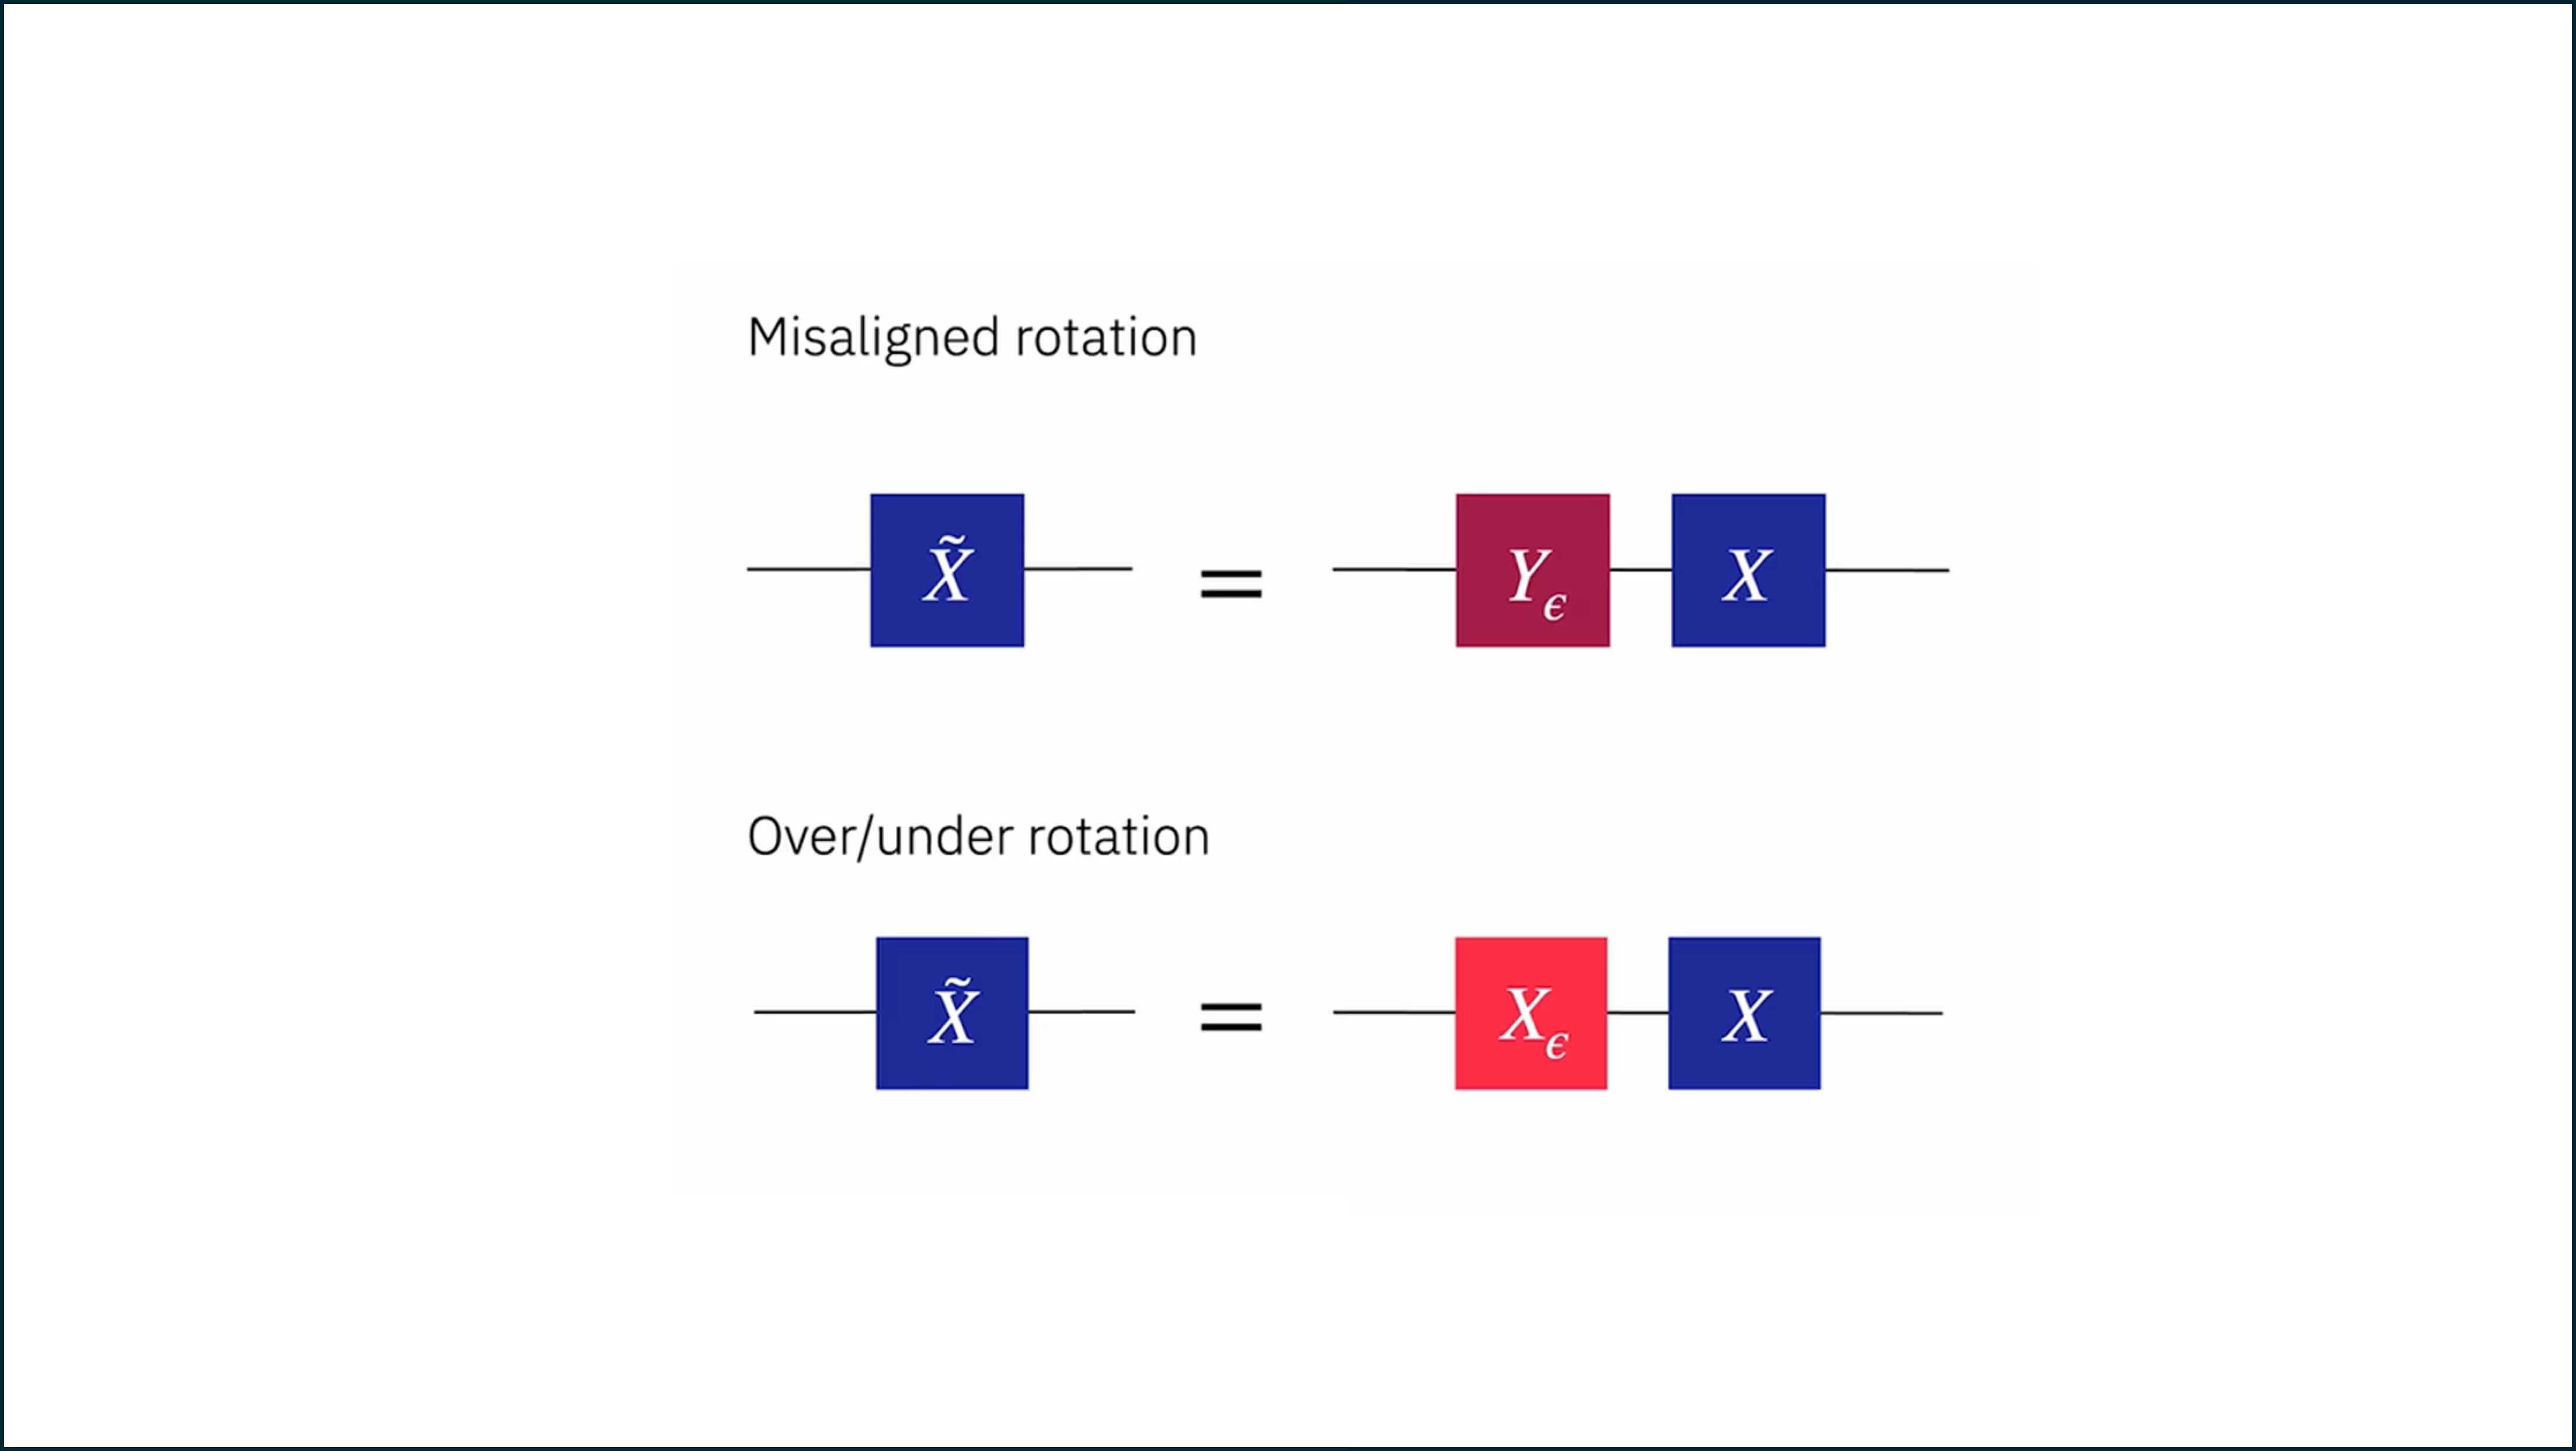
Koherentní chyby lze modelovat pomocí nežádoucích unitárních hradel. Mezi jednoduché příklady patří nesprávně orientované rotace nebo pod-/nad-otočení. Na obrázku níže ukazujeme nesprávně orientovanou rotaci jako dodatečnou rotaci o malou hodnotu navíc k požadované rotaci kolem osy . Nad-otočení je popsáno požadovanou rotací a také nějakou dodatečnou rotací kolem stejné osy .
Dvouqubitové chyby a stínované světelné kužely
Jednoqubitové hradlo rotuje izolovaný qubit. Dvouqubitové hradlo implementuje logiku závislou na dvou qubitech, ale nemůže provést přímé měření žádného z qubitů; musí proto zapnout interakci mezi qubity. Tato interakce je důvodem, proč můžeme vytvářet provázání, a je také zdrojem velké části šumu, přeslechů a obtížnosti kalibrace. Tato interakce mezi qubity také umožňuje šíření chyb. Pokud má jeden qubit nějakou chybu a slouží jako řídicí qubit pro jiný cílový qubit, chyba se může přenést na cílový qubit. V této lekci se podíváme na to, co dvouqubitová hradla znamenají pro míry chyb a jejich šíření v rámci obvodu.
Echovaná cross-rezonanční hradla
Různé hardwarové architektury a rodiny hradel realizují tuto interakci různými způsoby. Kvantové počítače IBM implementují abstraktní dvouqubitová hradla jako CZ nebo CX pomocí hardwarově nativních echovaných cross-rezonančních (ECR) hradel. ECR hradla generují efektivní interakci pomocí mikrovlnného buzení. Příbuzná hradla jako CNOT jsou z vytvořena přidáním jednoqubitových rotací.
Různé qubity mají různé rezonanční frekvence (frekvence, na které silně reagují). Standardní operace může tuto rezonanční frekvenci využít k vyvolání přechodu v qubitu. Co se ale stane, když budíš qubit C na rezonanční frekvenci sousedního qubitu T? Sousední qubity jsou propojeny pevnou kapacitní nebo rezonátorem zprostředkovanou interakcí. Díky této vazbě buzení na qubitu C „prosakuje“ do hamiltoniánu qubitu T. Síla a směr tohoto efektivního buzení závisí na stavu qubitu C ( nebo ). Zde je qubit C řídicí a qubit T cílový.
Výsledkem je efektivní rotace cílového qubitu podmíněná stavem řídicího qubitu. Matematicky:
Tato interakce ZX je přesně to, co potřebuješ k vytvoření CNOT. Ostatní členy ale mohou zahrnovat určité chyby a téměř jistě zahrnují kapacitní vazbu mezi qubity C a T, což odpovídá členu ZZ.
O těchto dodatečných členech můžeme uvažovat následujícím způsobem:
-
IX = cílový qubit je neúmyslně buzen
-
ZI = řídicí qubit získává nežádoucí rotaci Z
-
IZ = cílový qubit získává nežádoucí rotaci Z
-
ZZ = statický, na stavu závislý fázový posun
-
ostatní = malé interakce XY, XX a vyššího řádu
ECR hradlo je jednoduše řízená rotace plus pečlivě zvolený echo pulz na řídicím qubitu. Echo obrací znaménko mnoha nežádoucích členů a přitom zachovává interakci ZX. Tento proces poměrně dobře ruší chyby IX a ZI a někdy i některé členy vyššího řádu. Echování ale nemůže zrušit statickou vazbu ZZ, protože ta s echo pulzem komutuje. Existují další interakce, které se v tomto procesu nezruší: některé zbytkové nelinearity a efekty spectator qubitů, únik (leakage) a kontaminace dálkovým buzením, plus několik dalších — ale člen ZZ je obzvlášť důležitý.
Tento proces často vyžaduje doby buzení, které jsou o řád delší než u jednoqubitových hradel. Kombinace delších dob buzení, přetrvávajících členů ZZ v hamiltoniánu a nedokonalostí vazby činí z dvouqubitových hradel dominantní zdroj chyb hradel. Všimni si také, že pokud potřebuješ v obvodu interakce mezi qubity, které nejsou sousední, potřebná SWAP hradla jsou také zjevně dvouqubitová hradla. Proto je standardní metrikou týkající se hloubky: dvouqubitová, transpilovaná hloubka. Zajímáme se především o dvouqubitová hradla, protože dominují chybám hradel, a musíme se dívat na transpilované obvody, protože transpilace často zavádí mnoho dalších dvouqubitových hradel ve formě SWAP hradel.
Ověř si své porozumění
Vysvětli, proč se zajímáme především o dvouqubitovou transpilovanou hloubku. Nezapomeň zohlednit hardwarová omezení a skutečnost, že hloubka jednoqubitových hradel může být mnohem větší.
Odpověď
Dvouqubitová hradla mají mnohem vyšší míru chyb než jednoqubitová hradla. Jednoqubitová hradla nejsou dokonalá, takže mohou nastat případy, kdy je užitečné zohlednit i jednoqubitovou hloubku. Hloubka dvouqubitových hradel má ale tendenci dominovat chybovému chování obvodu. Musíme uvažovat transpilovaný obvod. Moderní kvantové počítače nemají konektivitu typu all-to-all mezi všemi qubity. Kvantové počítače IBM používají buď čtvercovou mřížku, nebo mřížku typu „heavy hex“, což znamená, že qubity mají 2, 3 nebo 4 nejbližší sousedy, se kterými mohou být přímo propojeny pomocí jediného dvouqubitového hradla. Jakékoli provázání s jinými, nesousedními qubity vyžaduje přesun informace po kvantovém počítači pomocí dvouqubitových SWAP hradel. Transpilace tedy má tendenci zvyšovat hloubku dvouqubitových hradel. U silně provazujících obvodů může být toto zvýšení velmi velké.
Stínované světelné kužely
Předpokládejme, že jeden qubit je dobře izolovaný od všech ostatních. Chyba na tomto qubitu nezpůsobí žádné chyby na jiných qubitech. Když ale qubit interaguje s jiným, chyby se mohou šířit. Způsob, jakým se chyby šíří, závisí na způsobu, jakým qubity interagují. Uvažuj obvod níže. Předpokládejme, že jakékoli qubity sousední v diagramu obvodu jsou také sousední na kvantovém čipu (to znamená, že k usnadnění popsaných interakcí nebude potřeba přesouvat informaci na jiné qubity).
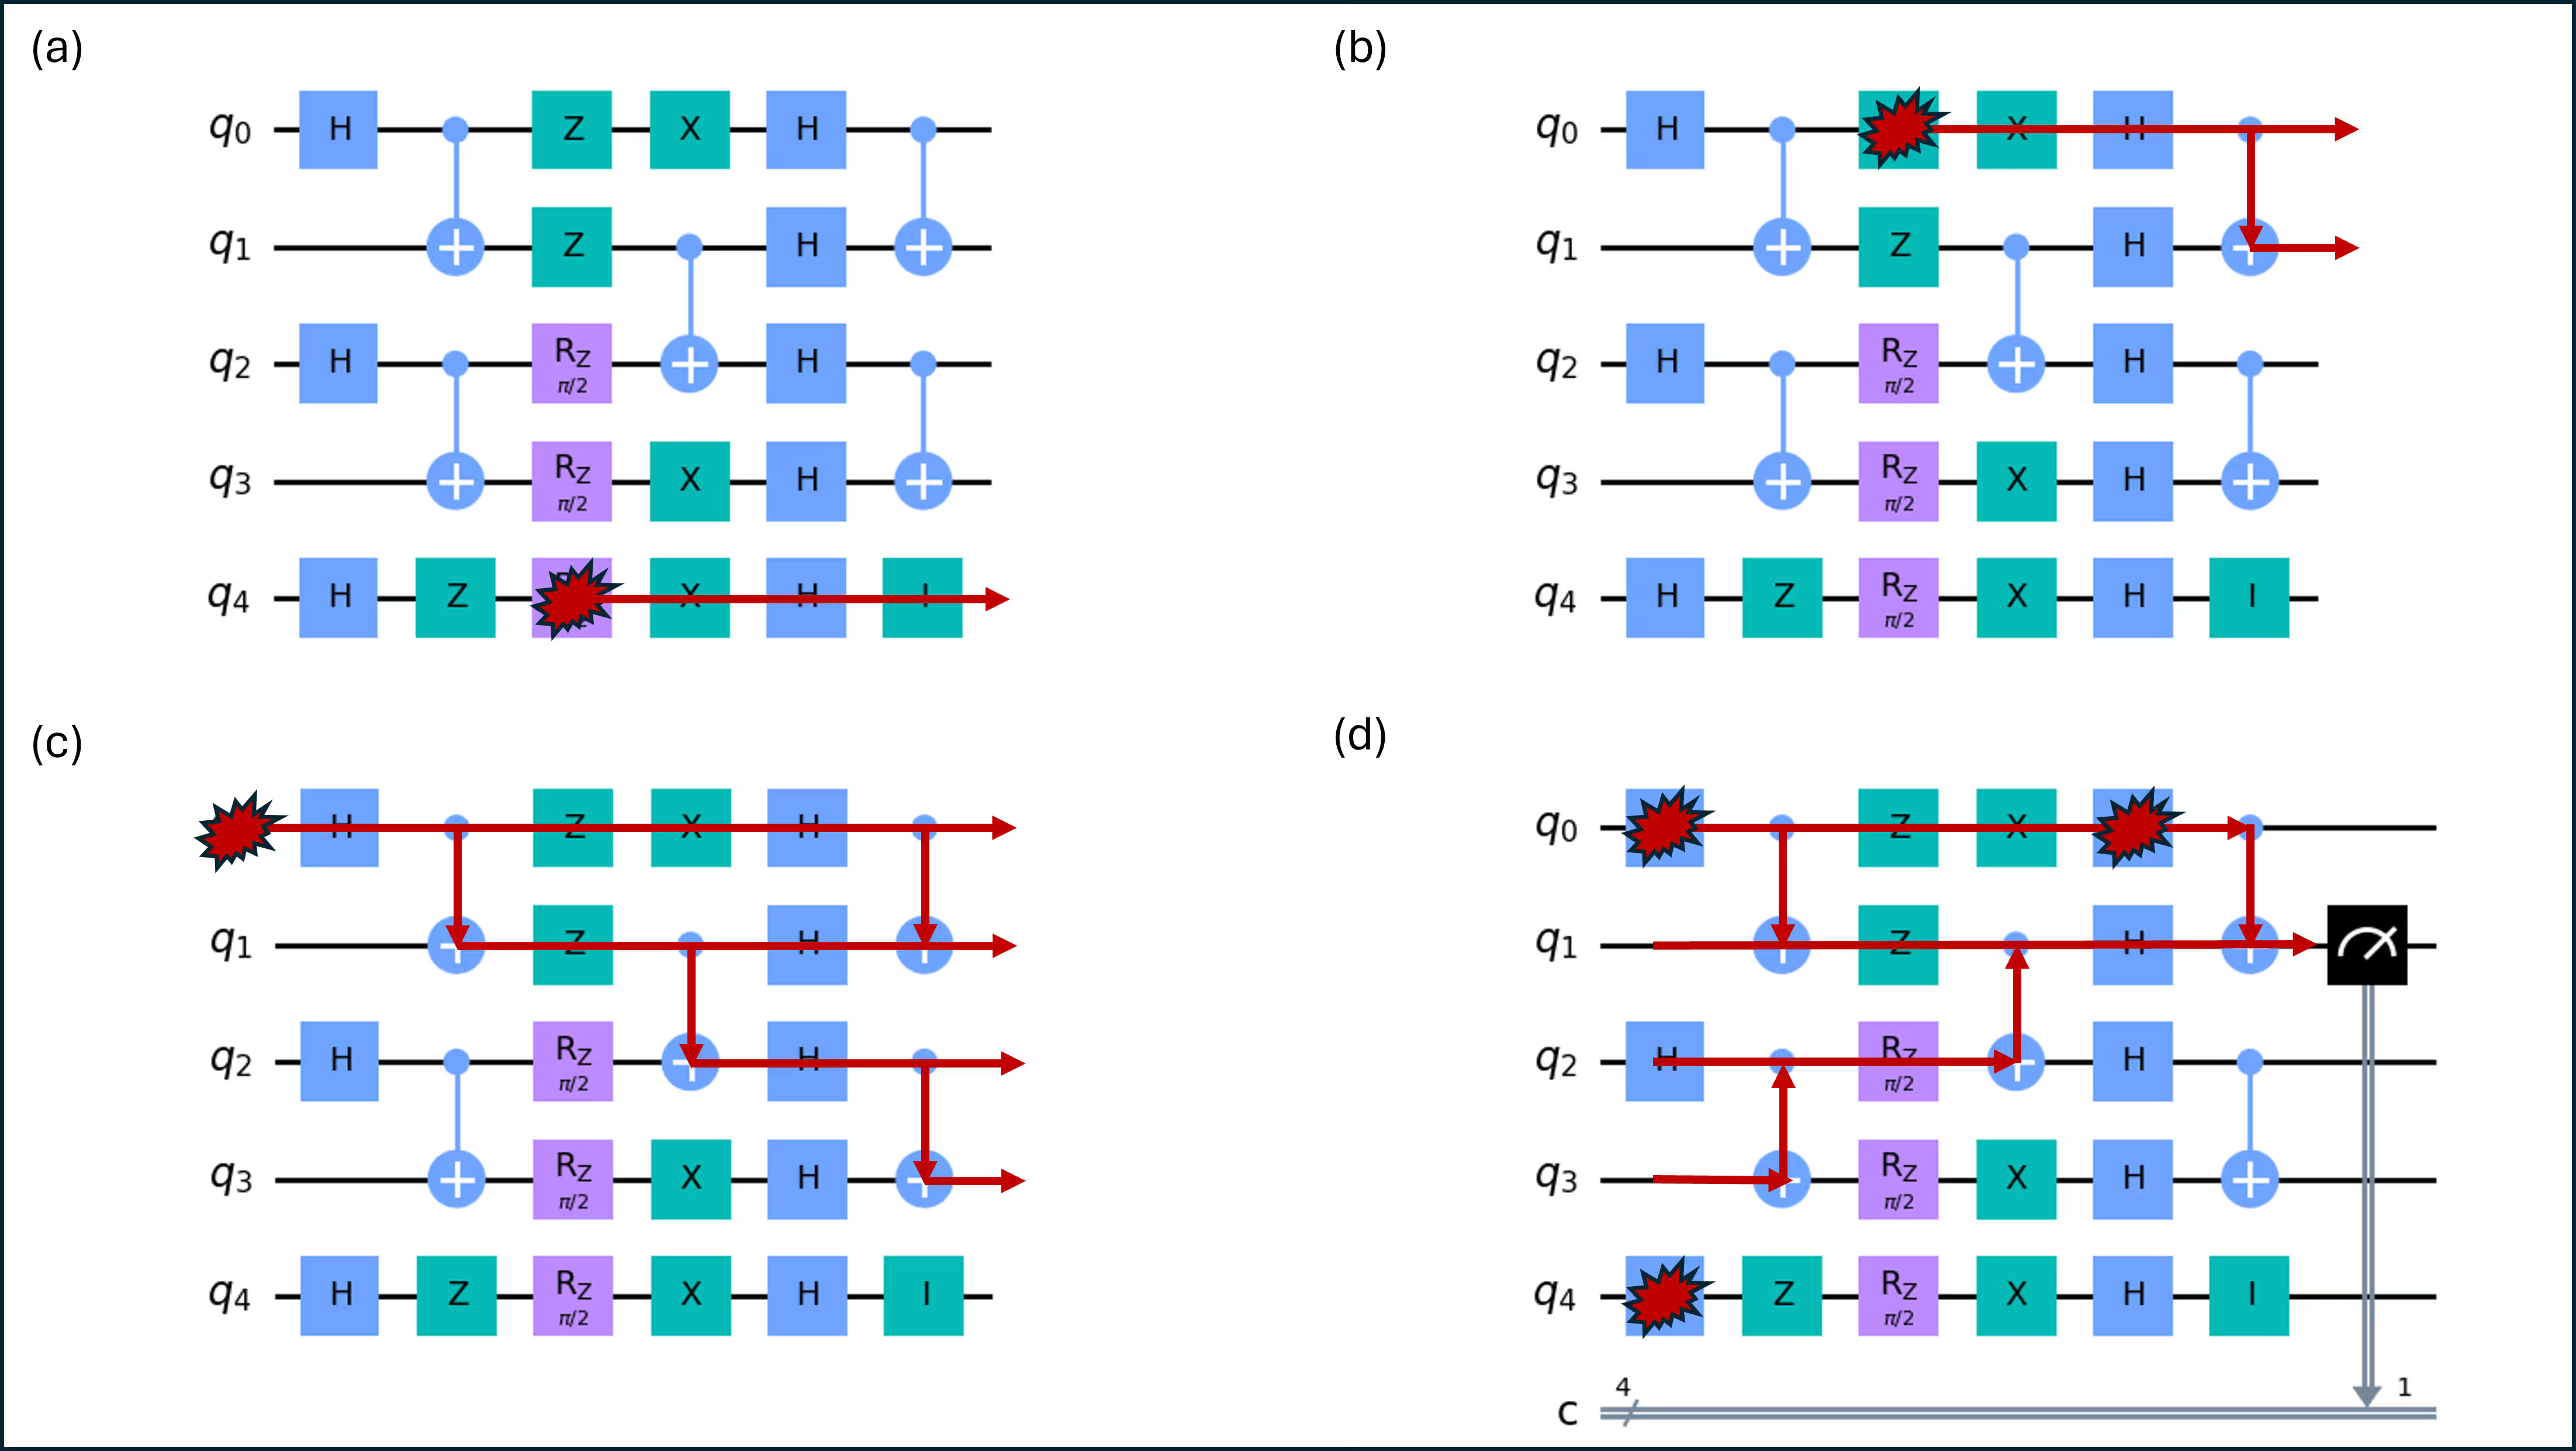
I když jsi to možná takto nevnímal, jde o svého druhu časoprostorový diagram. Svislá osa kvantového obvodu představuje různé qubity uspořádané v prostoru. Vodorovná osa představuje čas, během kterého je aplikována posloupnost hradel. Při použití terminologie z relativity světelný kužel představuje oblast časoprostoru, která je z daného bodu dosažitelná prostřednictvím kauzálních interakcí.
Na obrázku výše nebyl typ chyby specifikován. Ukazuje se, že typ chyby ovlivňuje světelný kužel, protože některé chyby ovlivňují logiku dvouqubitového hradla, zatímco jiné ne. K tomu se za chvíli vrátíme. Prozatím považuj žluté čáry za dráhy potenciálního šíření nějakého typu chyby. Všimni si například v části (a) obrázku, že jednoqubitová chyba na hradle RZ na qubitu 4 se může šířit v čase dopředu pouze na tomto jediném qubitu. Nemůže se rozšířit na jiné qubity, protože qubit 4 není provázán s žádnými jinými qubity. To je vhodná chvíle poznamenat, že qubit 4 je v tomto obvodu poměrně zbytečný, a skutečně, celý obvod je sestaven pouze pro pedagogické účely.
Chyba na hradle Z qubitu 0 (nikoli nutně Z-chyba, jen nějaká chyba na tomto místě) by se však mohla přenést na jiný qubit: qubit 1, prostřednictvím závěrečného CNOT, který používá qubit 0 jako řídicí a qubit 1 jako cílový. To je znázorněno v části (b). Jak by se dalo očekávat, chyba dříve v obvodu bude mít často šanci šířit se přes více qubitů. Část (c) ukazuje, že chyba v počáteční přípravě stavu qubitu 0 se může rozšířit na všechny qubity kromě qubitu 4, který je izolovaný.
Toto uspořádání ukazuje, jak se může chyba šířit vpřed v čase a ovlivnit měření. Můžeš ale zkoumat i opačnou otázku: u konkrétního jednoqubitového měření, které části mého obvodu k němu mohly přispět nějakou chybou? V takovém případě bys jednoduše začal u měření nebo jiného bodu zájmu a postupoval bys zpět (v čase) obvodem, přičemž bys sledoval jakékoli provazující obvody, jak je znázorněno v části (d). Znázorněno je také několik náhodně zvolených bodů, kde může dojít k chybám.
Na obrázku výše se chyby šíří mezi qubity prostřednictvím ECR hradel, ale podobná úvaha by se mohla vztahovat i na jiná dvouqubitová hradla. Tato hradla mají řídicí a cílový qubit. Je zřejmé, že chyba na řídicím qubitu může ovlivnit logiku hradla, a tudíž vést k chybě na cílovém qubitu. Co ale ten druhý směr? Může se chyba na cílovém qubitu přenést na řídicí qubit? Připomeňme, že vazba mezi řídicím a cílovým qubitem u ECR hradel není čistě ideálního typu ZX; má také nežádoucí vazbu ZZ.
Pokud chyba na cílovém qubitu komutuje s vazbou ZZ, nemůže se přenést na řídicí qubit. To lze pochopit prostřednictvím fyzikálních mechanismů, které jsou v hře. Rychlý způsob, jak to vidět, je, že pokud chyba komutuje s , lze jejich pořadí prohodit, aniž by to ovlivnilo výsledek. Pokud je však chyba vyskytující se těsně před vazbou stejná jako její působení po vazbě , nemůže ovlivnit řídicí qubit, protože v druhém případě by se chyba musela pohybovat v čase nazpět. Pokud chyba nekomutuje s vazbou ZZ, mohla by se skutečně přenést z cílového qubitu zpět na řídicí. V případě ECR hradla se tedy Z chyby nemohou přenést z cílového qubitu na řídicí, ale X nebo Y chyby ano.
Ověř si své porozumění
V části (d) obrázku výše se podívej na svislé čáry mezi qubity 0 a 1. Je správné, že by se některé chyby mohly šířit napříč těmito čarami? Opět to může záviset na typu chyby, což jsme zatím nediskutovali. Otázkou je, zda existuje nějaká chyba, která by se mohla šířit tak, jak je znázorněno těmito svislými čarami. Vysvětli.
Odpověď
Ano, je to správné. Při náčrtu světelného kužele zpětně od měření to může působit, jako bys tvrdil, že se něco pohybuje z cílového qubitu na řídicí. Význam diagramu je ale ve skutečnosti takový, že chyba se mohla přesunout z řídicího qubitu (qubit 0) na cílový qubit (qubit 1) a způsobit chybu v bodě zájmu. Pokud tvá intuice říká, že to závisí na typu chyby, máš naprostou pravdu. Tím se částečně zabývá další část.
Vyjdi z bezchybné verze obvodů v diagramu výše a sleduj potenciální šíření chyby v prvním Hadamardově hradle působícím na qubit 2. Vypiš všechny qubity, které by mohly být ovlivněny do konce obvodu, pokud je chybou (a) překlopení fáze a (b) překlopení bitu. Nápověda: přemýšlej o tom, jak je informace na každém qubitu využívána.
Odpověď
(a) Mohl by být ovlivněn qubit 3, stejně jako samozřejmě qubit 2 samotný. Žádné jiné! Pokud jsi uvedl qubity 0 a 1, všimni si, že qubit 2 je cílem ECR, které jej provazuje s qubitem 1. V tomto hradle se na qubitu 1 nic nemění. (b) Mohly by být ovlivněny qubity 0-3. Chyba typu překlopení bitu neboli X nekomutuje s vazbou ZZ v ECR hradle, a proto se může přenést z cílového qubitu na řídicí.
Šíření chyb
V předchozí části jsme diskutovali šíření chyb, aniž bychom mu dali formální definici. Nadále:
Pro chybu , která nastane před nějakou částí logického obsahu obvodu , znamená šíření chyby nalezení ekvivalentního operátoru , který reprodukuje stejný chybný výsledek, je-li aplikován po místo před ním.
Obrázek šíření chyb v předchozí části naznačoval, že chyby se mohou šířit z řídicího qubitu na cílový qubit napříč CNOT hradlem. Jedním ze způsobů, jak ověřit, kdy to platí, je uvažovat chybu na řídicím nebo cílovém qubitu před provázáním a ověřit, zda tento operátor komutuje s CNOT hradlem. Pokud oba operátory komutují, nezáleží na tom, zda je aplikuješ v opačném pořadí, což znamená, že chybu lze jednoduše „přesunout za“ CNOT, aniž by měla jakýkoli vliv na jiné qubity. Toto je nejběžnější způsob, jakým lidé přistupují k šíření chyb, a vede k následujícím pravidlům:
Nechť řídicím qubitem je qubit 0 a cílovým qubitem qubit 1. Uvažuj chyby X a Z na řídicím a cílovém qubitu (, , , respektive ). Přesunutí těchto chyb za způsobí, že se chyby stanou:
Výše uvedené tvrzení uvádíme bez důkazu. Pokud jsi ale jako autor této lekce a preferuješ Schrödingerův obraz, můžeš si také zapsat libovolné stavy řídicího a cílového qubitu, aplikovat chybu, poté CNOT a prozkoumat výsledný stav. Porovnáš-li tento výsledný stav s bezchybným případem, uvidíš, jaká kombinace chyb aplikovaná po CNOT by dala chybný stav, a zejména uvidíš, zda se chybová operace přenesla z jednoho qubitu na druhý.
| Počáteční stav řídicího | Počáteční stav cílového | Chyba | Výsledný stav | Ekvivalent chyby po CNOT |
|---|---|---|---|---|
| Žádná | Nelze použít | |||
| X na řídicím | ||||
| Z na řídicím | ||||
| X na cílovém | ||||
| Z na cílovém |
Možná překvapivě Z chyba na cílovém qubitu skutečně způsobí, že se chyba přenese zpět na řídicí qubit!
Jak si dokážeš představit, sledování takového šíření chybových operátorů vpřed obvody (nebo ekvivalentně zpětné šíření operátorů, které mají být měřeny) je komplikované. Qiskit má nástroje, které to usnadňují, se kterými se seznámíme v lekci 6 o moderních pracovních postupech.
Existuje doplněk Qiskit s názvem Shaded Lightcones. Doplněk shaded lightcones (SLC) analyzuje šíření chyb v kvantových obvodech pomocí šíření Pauliho operátorů, aby identifikoval, které části obvodu mohou skutečně ovlivnit cílovou pozorovatelnou veličinu. Je navržen především k tomu, aby zefektivnil zmírňování chyb, zejména pro pracovní postupy pravděpodobnostního rušení chyb (PEC). Zde tento nástroj prozkoumáme jen stručně a šířeji jej využijeme v kontextu technik zmírňování chyb v budoucích lekcích. Používá šíření Pauliho operátorů k zmapování šíření chyb různých typů a vytváří světelný kužel pro chyby typu X, Y a Z.
Stínované světelné kužely (SLC, Shaded Lightcones) jdou ještě dál a pomocí klasických simulací přesněji omezují citlivost na chyby v celém obvodu. Tím se část času QPU vymění za čas CPU a snižuje se vzorkovací režie potřebná k renormalizaci zkreslení. Místo tvrdého prahu je každé potenciální chybě v obvodu přiřazen odstupňovaný „stín“, který shora omezuje citlivost pozorovatelné veličiny na danou chybu. Tato zpřesněná charakterizace umožňuje efektivnější a cílenější použití PEC se sníženým rozptylem a zároveň dává uživateli možnost kontrolovaně nastavit zkreslení při odhadu pozorovatelné veličiny. Další podrobnosti najdeš v článku Lightcone shading for classically accelerated quantum error mitigation.
Zde neprezentujeme celý workflow. Jednoduše diagramaticky ukážeme, jak tento workflow zpracovává obvod:

Workflow rozděluje obvod na „boxy“ užitečné pro učení chování šumu:

Nakonec použije propagaci operátorů a učení šumu k vytvoření stínované mapy citlivosti na chyby v celém obvodu:
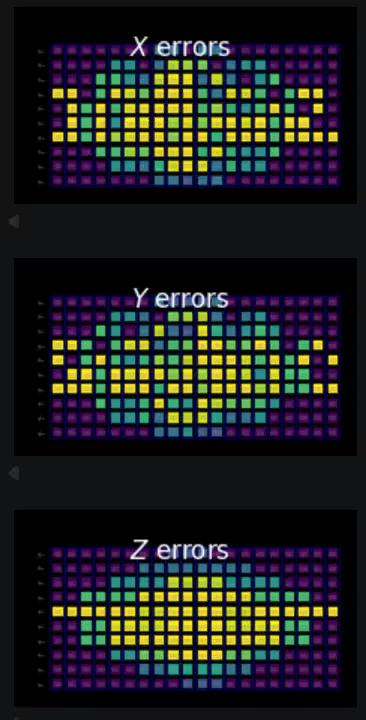
Každý barevný box ve výstupu odpovídá konkrétnímu qubitu v konkrétním čase. Nejtmavší (fialové) boxy označují qubit a vrstvu, ve které se chyba nemůže propagovat do sledovaných měření. Nejsvětlejší (žluté) boxy odpovídají qubitu a vrstvě, ve které může mít chyba silný vliv na sledovaná měření.
Všimni si fialových oblastí na pravé straně každé mapy. Chyba ve stejné vrstvě jako měření, ale na jiném qubitu, nemůže měření ovlivnit prostřednictvím zobrazené konektivity obvodu. Podobně chyba o jednu vrstvu zpět v čase (o jednu vrstvu vlevo) se může propagovat pouze na sousední qubit v následujícím kroku, a to kvůli struktuře provazující (entangling) vrstvy, a tak dále. Tvar kužele na pravé straně je proto obecný vždy, když je do sledovaného měření zapojeno relativně málo qubitů.
Ověř si své porozumění
Myslíš si, že je lepší vytvořit mapu stínovaného světelného kužele před transpilací, nebo po ní? Proč?
Odpověď
Musí se to udělat po transpilaci. Aby byly tyto různé mapy užitečné, musíme zajistit, aby sousední qubity v našem obvodu odpovídaly sousedním qubitům na našem kvantovém čipu. Jinak by provazující hradla (entangling gates), zobrazená jako působící na sousední qubity v diagramu obvodu, nakonec vyžadovala SWAP hradla a složitější strukturu obvodu.