Error mitigation (zmírňování chyb)
Tato lekce poskytuje základní přehled různých technik zmírňování chyb (error mitigation), aby si uživatelé vytvořili intuici, jak a kdy je nejlépe používat. Moderní aplikace těchto technik přitom využívají sofistikovanější nástroje, jako jsou Samplomatic, Shaded Lightcones a Executor. Těmto workflow se budeme věnovat v pozdějších lekcích.
Toto video nabízí přehled technik zmírňování chyb. Text níže přidává podrobnosti a tyto metody zkoumá pomocí Qiskit.
Přehled technik zmírňování chyb
Zmírňování chyb (error mitigation) označuje jakýkoli proces, který se snaží snížit dopady chyb v kvantových výpočtech poté, co k nim došlo. Liší se od potlačování chyb (suppression), které se snaží chybám předcházet, i od korekce chyb, která kóduje informaci do mnoha fyzických qubitů a kontroluje konzistenci této informace, aby zachovala informaci v jediném logickém qubitu. V celé této lekci je třeba techniky zmírňování chyb chápat především jako metody pro konstrukci lepších estimátorů ideálních očekávaných hodnot nebo lepších vzorkovačů rozdělení pravděpodobnosti, nikoli jako metody pro opravu kvantových stavů během provádění. Probereme níže uvedené metody zmírňování chyb, které jsou všechny dostupné v Qiskit a jeho addonech a jsou slibnými nástroji na cestě ke kvantové výhodě.
Twirled readout error extinction (TREX) zrandomizuje proces měření tím, že před měřením aplikuje náhodně zvolené Pauliho operace a poté klasicky zruší jejich známý vliv na pozorované bitové řetězce. Za vhodných předpokladů o šumu měření tím převede kanál chyb čtení do jednodušší a symetričtější podoby, kterou je snazší kalibrovat a zmírnit.
Matrix-free measurement mitigation (M3) je škálovatelná technika zmírňování chyb měření, která se vyhýbá explicitní konstrukci přiřazovací matice nebo její inverze.
Zero noise extrapolation (ZNE) aproximuje hodnotu, kterou by měla pozorovatelná veličina bez šumu, tím, že šum umělě škáluje o známý faktor a extrapoluje zpět na případ s nulovým šumem. To vyžaduje, aby se šum škáloval předvídatelným způsobem. Tato předvídatelnost může vyžadovat další metody probírané v této lekci (roztažení pulzů, skládání hradel a pravděpodobnostní zesilování chyb (PEA)).
Probabilistic error cancellation (PEC) patří mezi nejvýkonnější, ale také výpočetně nejnáročnější techniky zmírňování chyb. Funguje tak, že se učí chování šumu systému a pokouší se šum odstranit statistickou konstrukcí nezkresleného odhadu ideálního výpočtu. PEC poskytuje statisticky opravené pozorovatelné veličiny, nikoli výsledky opravené korekcí chyb.
Nyní se ponoříme do jednotlivých metod.
M3
Chyby měření patří mezi nejtrvalejší a hardwarově nejspecifičtější zdroje šumu v kvantových zařízeních blízké budoucnosti. I když je kvantový stav připraven a vyvíjen správně, závěrečný krok čtení může nesprávně nahlásit skutečný výsledek ve výpočetní bázi. Tyto chyby vznikají z nedokonalého rozlišení mezi fyzickými stavy odpovídajícími a , z relaxace během měření a z nedokonalostí měřicí elektroniky. Pozorované rozdělení bitových řetězců je proto často zkreslenou verzí skutečného (ideálního) rozdělení, v němž je pravděpodobnost nesprávně přeřazena mezi výsledky.
Zmírňování chyb měření řeší tento problém tím, že explicitně modeluje, jak jsou výsledky měření chybně přiřazovány. Ve standardní formulaci je toto chování zachyceno přiřazovací maticí , jejíž prvky představují pravděpodobnost zaznamenání výsledku , když skutečným bázovým stavem bylo . Pokud je šum měření klasický a stacionární, je pozorovaný vektor pravděpodobností s ideálním rozdělením svázán jednoduchým lineárním vztahem,
Všimni si, že přiřazovací matice je klasické stochastické zobrazení, nikoli kvantový kanál. Působí na klasická čtení, nikoli na podkladové kvantové stavy, které byly vzorkovány, aby se čtení získala.
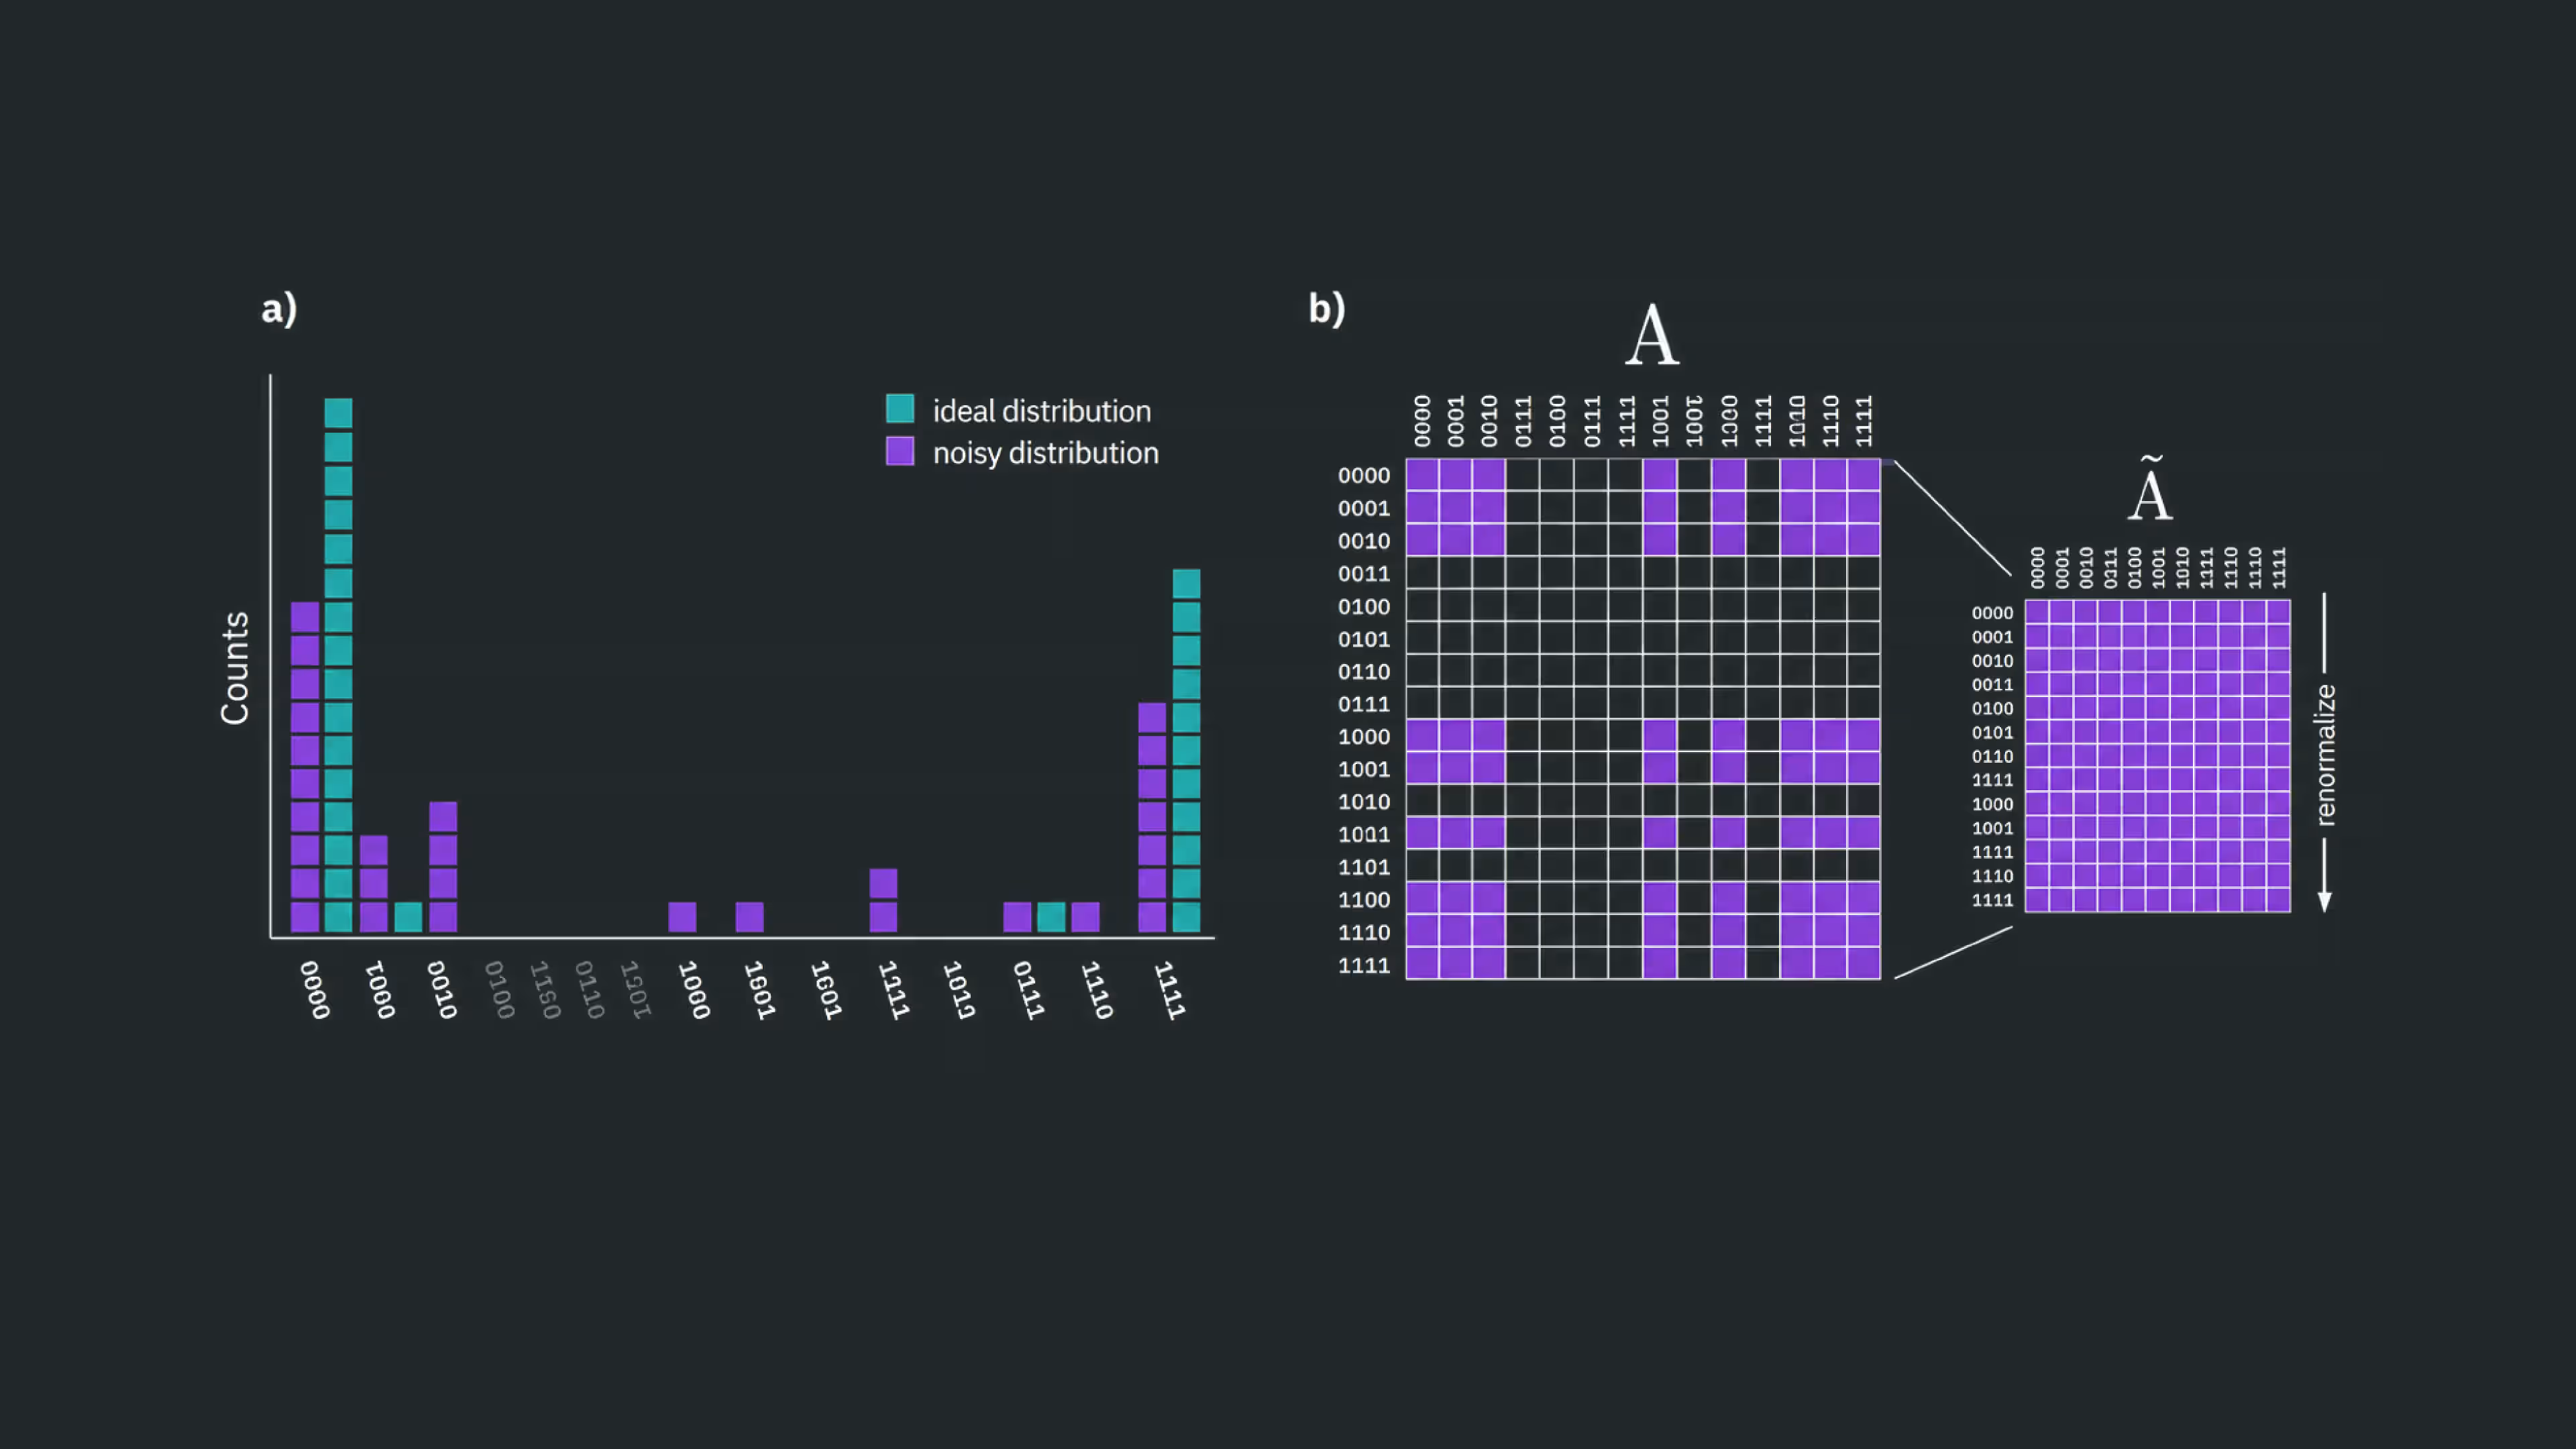
Matrix-free measurement mitigation (M3) využívá tuto strukturu ke konstrukci zmírněného odhadu , aniž by kdy sestavovala nebo invertovala celou matici , což by pro velký počet qubitů bylo neproveditelné. M3 místo toho využívá toho, že mnoho kvantových úloh blízké budoucnosti produkuje silně vrcholová rozdělení s nízkou entropií, takže zmírňování se zaměřuje jen na podmnožinu výsledků, které významně přispívají k pozorovanému rozdělení.
K sestavení přiřazovacího modelu je nutné na kvantovém hardwaru spustit další kalibrační experimenty. Typicky zahrnují přípravu známých stavů výpočetní báze a zaznamenání toho, jak je měřicí systém nahlásí. Kalibrační režie roste s počtem měřených qubitů, zatímco výpočetní náklady zmírňování závisejí na struktuře pozorovaného rozdělení. Tyto náklady jsou mnohem menší, než by bylo potřeba k explicitní charakterizaci celé přiřazovací matice . Ačkoli je tato kalibrační režie skutečná, je ve srovnání s technikami na úrovni obvodů, jako je extrapolace na nulový šum nebo pravděpodobnostní rušení chyb, nenáročná, a proto je M3 praktickým a široce používaným nástrojem pro zmírňování chyb čtení v kvantových experimentech blízké budoucnosti.
Všimni si, že kalibrace je užitečná jen do té míry, do jaké zůstává proces měření dostatečně stabilní mezi kalibračními běhy a cílovým experimentem.
Nejprve ručně provedeme jednoduchý případ, abychom ukázali, jak to funguje, a poté použijeme nástroje zabudované v Qiskit, abychom ukázali použití M3 v realističtějším měřítku.
Malý příklad M3
Začneme sestavením jednoduchého Bellova stavu.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Můžeme použít simulátor s modelem šumu, protože tento příklad omezujeme na velmi malý obvod. Explicitně nastavíme model šumu tak, aby měl chybu čtení ve tvaru:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Tyto míry chyb čtení jsou mnohem vyšší, než jaké vidíme u skutečných kvantových počítačů IBM®. Vysoké hodnoty byly zvoleny z pedagogických důvodů, abychom jasně viděli účinek M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Obvod můžeme spustit na zašuměném simulátoru, abychom pozorovali účinky chyby čtení.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
V našem ilustračním příkladu jsme chybu čtení definovali pro náš model šumu. Při použití skutečného kvantového počítače však chyba čtení není a priori známa. Je třeba ji odhadnout experimentálně. K tomu vytvoříme obvody, které připraví qubit ve známém stavu výpočetní báze nebo , a změříme ho. Bez chyby čtení bychom naměřili přesně připravený stav. Sběrem statistik z těchto měření můžeme sestavit přiřazovací matici popisující chybu čtení. V tomto ilustračním příkladu by měla vypadat podobně jako ta, kterou jsme definovali.
U realističtějšího systému by bylo nutné nasbírat statistiky pro každý fyzický qubit. To je někdy netriviální, protože transpilace mapuje abstraktní obvod na hardware a číslo qubitu se mění. K tomu se vrátíme v dalším příkladu. V tomto příkladu se simulátorem jsme každému qubitu přiřadili stejný model chyby čtení, takže stačí jediná charakterizace.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Všimni si, že je velmi blízká matici chyby čtení použité při konstrukci simulátoru.
Opět platí, že na skutečném kvantovém počítači bychom měli takové statistiky pro více fyzických qubitů. Pro tento simulátor předpokládáme, že oba qubity mají identické a nezávislé chyby čtení, což nám umožňuje sestavit dvouqubitovou přiřazovací matici A_2q jako tenzorový součin odpovídajících jednoqubitových matic. Také si všimni, že smyslem M3 není sestavit celou přiřazovací matici. M3 se místo toho zaměřuje na podmnožinu výsledků, které významně přispívají k pozorovanému rozdělení. Celou matici pro náš velmi malý příklad sestavíme, abychom viděli, jak to funguje. Implementace M3 v qiskit-ibm-runtime je sofistikovanější než tento ilustrační příklad, protože musí zvládat mnoho qubitů s odlišnými charakteristikami čtení a přitom se stále vyhýbat sestavení celé přiřazovací matice.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
V tomto příkladu předpokládáme, že chyby čtení na různých qubitech jsou nezávislé, což umožňuje sestavit dvouqubitovou přiřazovací matici jako tenzorový součin odpovídajících jednoqubitových matic.
Získáme surové a zmírněné výsledky pro srovnání.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
V tomto okamžiku jsme experimentálně charakterizovali, jak proces měření zkresluje ideální pravděpodobnosti výsledků. Naším cílem je nyní toto zkreslení zrušit a výslednou korekci aplikovat na surové pravděpodobnosti.
Protože provádíme lineární inverzi, nikoli fyzikální korekci, výsledné "pravděpodobnosti" nemusejí být vždy kladné. Velmi malé záporné kvazipravděpodobnosti jsou očekávané a odrážejí skutečnost, že zmírňování chyb měření produkuje estimátor, nikoli fyzikální rozdělení pravděpodobnosti.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Pro vykreslení je převedeme na počty.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Nakonec se podíváme na surové, zmírněné a ideální rozdělení. Zmírněné "počty" níže jsou jen pomůckou pro vizualizaci, získanou přeškálováním zmírněných kvazipravděpodobností.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
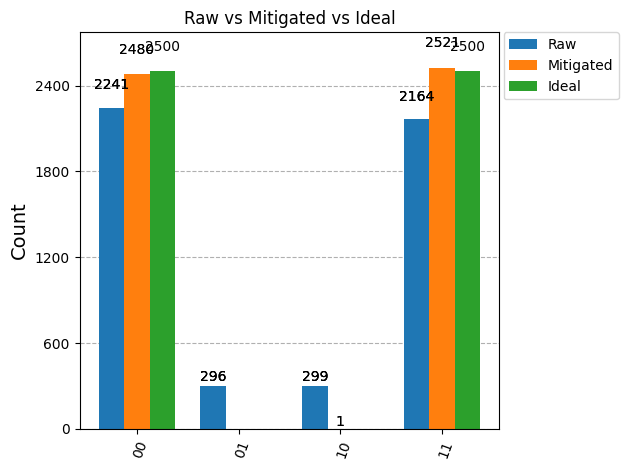
Je jasné, že výsledky zmírněné pomocí M3 jsou mnohem blíže ideálním rozdělením, a vidíme proč.
Použití M3 v realističtějších workflow je mnohem složitější. Zvaž:
- Skutečné kvantové počítače obsahují mnoho fyzických qubitů, každý s vlastními charakteristikami chyby čtení. Tyto chyby je třeba vhodně modelovat a kombinovat.
- Celá přiřazovací matice roste exponenciálně s počtem qubitů a její explicitní sestavení se rychle stává nepraktickým. Proto se M3 zaměřuje na podmnožinu výsledků, které významně přispívají k pozorovanému rozdělení, místo aby sestavovala celou přiřazovací matici.
- U skutečných zajímavých problémů nemusí být ideální rozdělení známo.
Ze všech těchto důvodů je celý workflow zmírňování zapouzdřen v addonu Qiskit mthree.
Větší příklad M3
Nyní aplikujeme M3 na větší obvod, u něhož by bylo určení relevantního podprostoru ručně těžkopádné, ale který je stále dost jednoduchý na to, abychom znali ideální rozdělení: stav GHZ. Začneme importem balíčku mthree a definicí kvantového obvodu GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
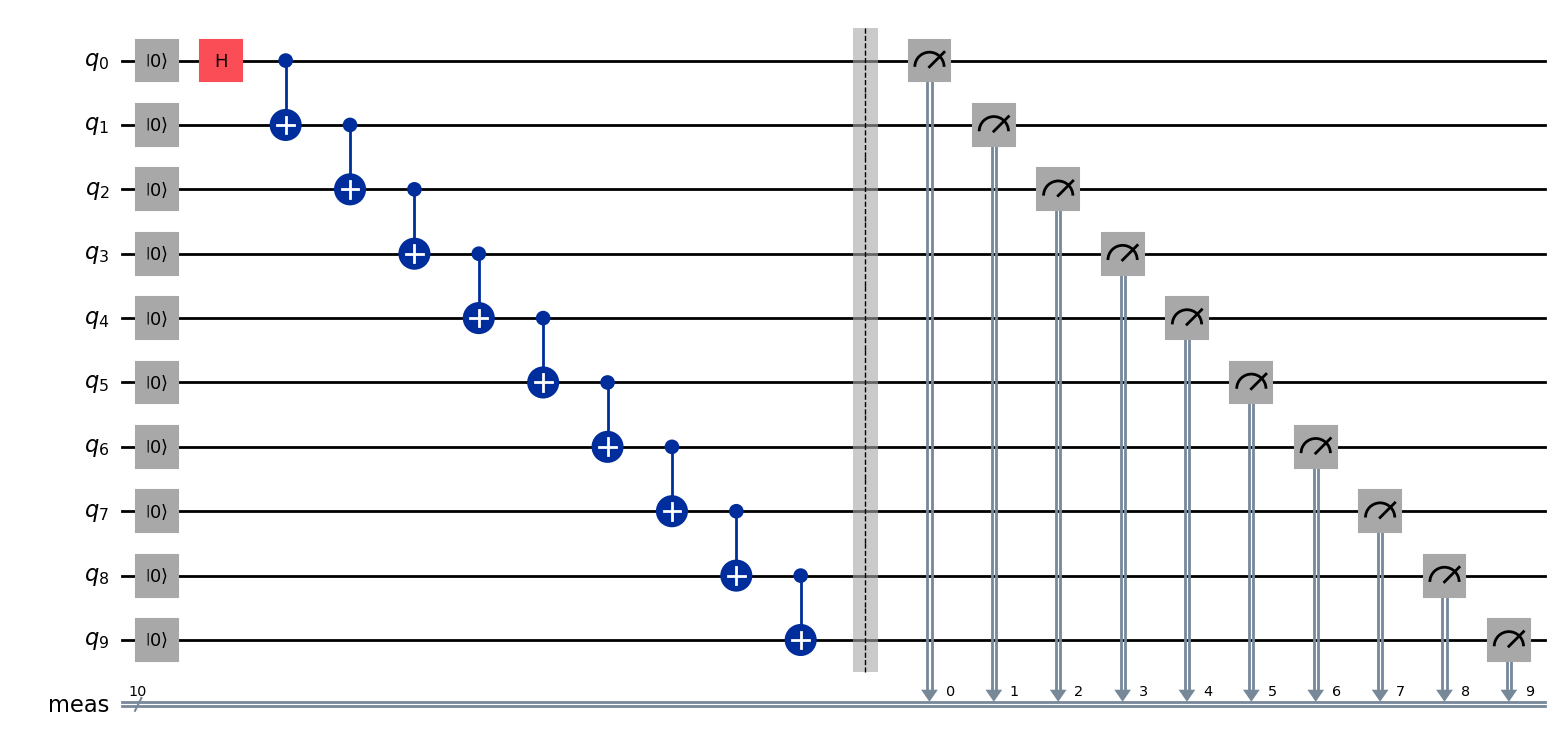
Abychom to spustili na skutečném kvantovém počítači, importujeme qiskit_ibm_runtime a další potřebné balíčky. K získání rozdělení výstupů používáme SamplerV2.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Nyní obvod transpilujeme pro náš backend. Úroveň optimalizace zde nastavujeme na 0, abychom se zaměřili na účinky M3 bez přidávání dalších nástrojů. To znamená, že výsledná věrnost nebude reprezentativní pro to, čeho lze na hardwaru IBM Quantum® dosáhnout s plnou sadou dostupných nástrojů, ale umožňuje nám zaměřit se konkrétně na užitečnost M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Nyní nakonfigurujeme Sampler, opět s vypnutím dalších technik potlačování chyb, jako je dynamické oddělování a twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Nakonec spustíme naši úlohu.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Z výše uvedeného obvodu můžeme získat surové počty.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Nyní na našem backendu spustíme mthree, abychom charakterizovali přiřazovací model použitý pro zmírňování chyb měření. Pomocí těchto informací přeškálujeme surové rozdělení. Všimni si, že to může někdy vést k velmi malým záporným pravděpodobnostem (odtud pojem kvazipravděpodobnosti).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Korekce mthree produkuje kvazipravděpodobnosti, nikoli počty. Na počty můžeme přeškálovat ručně. Pomocná funkce níže převádí na počty a zaokrouhluje na celé hodnoty. U velkých obvodů navíc bude existovat mnoho chybných řetězců s velmi malým počtem výskytů, které však zaplevelují histogram. Druhá pomocná funkce níže odstraní všechny řetězce s méně výskyty, než je námi zvolený práh, abychom získali přehledný pohled na dominantní členy rozdělení.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Pro srovnání můžeme také snadno vytvořit teoretické ideální rozdělení, v němž mají stavy samých nul a samých jedniček stejnou pravděpodobnost a všechny ostatní výsledky nulovou.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Nakonec můžeme výsledky vizualizovat.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
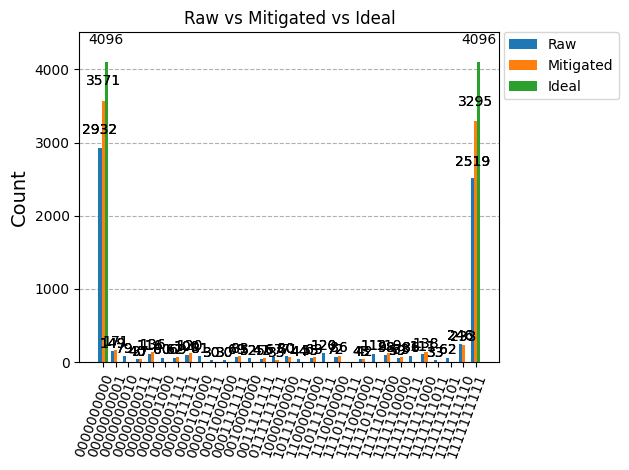
Zmírněné výsledky jsou blíže ideálnímu rozdělení než nezmírněné. Lze to lépe vyčíslit pomocí počtů ideálních bitových řetězců.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Tento jednoduchý nástroj zlepšil naši věrnost o 26 % oproti nezmírněné věrnosti, a to s poměrně nízkou režií. M3 může být zjevně velmi cenné. GHZ obvod byl však vybrán jako dobrý případ použití, protože je silně vrcholový ve dvou výstupních stavech. Některé problémy vedou k rovnoměrněji rozloženým počtům (stavy s vysokou entropií). U velmi hlubokých obvodů s mnoha qubity budou chyby hradel a šum nesouvisející s chybami měření často vést ke stavu s vysokou entropií. V takových případech M3 pracuje v dosti velkém stavovém prostoru. Existují tři možné přístupy:
(1) Smířit se s tím, že jde o omezení M3.
(2) Všimni si, že horní mez prostoru matice vytvořené M3 je num_shots num_shots, nikoli , přičemž první z nich je pro velký počet qubitů mnohem menší.
(3) Pouze s velkou opatrností odstranit velmi málo pravděpodobné bitové řetězce ze surových počtů vstupujících do M3. To může zavést zkreslení a omezení nosiče tvých stavů může narušit konvergenci u přístupů, jako je Krylovova metoda. Mělo by se to dělat jen tehdy, když přesně víš, proč to děláš, a dokážeš předvídat všechny jeho účinky. Proto takové ořezávání není zabudovanou funkcí M3.
Další informace o addonu Qiskit mthree, včetně příkladů, instalačních pokynů, pozadí a referencí API, najdeš v jeho dokumentaci.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) je technika zmírňování chyb měření používaná na moderních kvantových počítačích. Jejím cílem je odstranit zkreslení způsobené klasickými chybami čtení, aniž by bylo nutné provádět úplnou charakterizaci nebo inverzi přiřazovací matice měření.
TREX není korekce chyb a nezlepšuje věrnost stavu. Místo toho zajišťuje, že estimátory očekávaných hodnot jsou vůči šumu čtení nezkreslené, až na statistickou chybu, a to průměrováním přes zrandomizované měřicí báze a přeškálováním. Na hardwaru IBM Quantum je TREX výchozí metodou zmírňování pro odhad očekávaných hodnot a odpovídá resilience_level = 1 v primitivu IBM Quantum Estimator.
Povaha chyb čtení na supravodivém hardwaru
U supravodivých qubitů IBM dominují chybám čtení:
-
Asymetrické pravděpodobnosti překlopení bitu (například častěji než opačně)
-
Relaxace závislá na stavu během samotného měření
-
Mírné, ale nezanedbatelné přeslechy mezi sousedními čtecími rezonátory
Tyto chyby lze často modelovat jako klasický stochastický proces působící na výsledky měření. TREX využívá standardní myšlenku z úpravy šumu (noise tailoring): randomizaci (twirling) procedury měření. TREX typicky probíhá ve dvou fázích:
-
Twirling a klasické "odtočení" (untwirling)
-
Přeškálování očekávaných hodnot pomocí kalibračních obvodů
Předpokládejme, že očekávaná hodnota pozorovatelné souvisí se zašuměnými odhady například takto:
kde je pevný faktor, který škáluje odhad, a je zkreslení ze zdrojů popsaných výše. Zde používáme jako připomínku, že se zde zabýváme pouze chybou čtení; stále je třeba uvažovat chybu hradel.
Těsně před měřením je každý qubit náhodně konjugován Pauliho operátorem (například I nebo X). Výsledky měření jsou poté klasicky odtočeny.
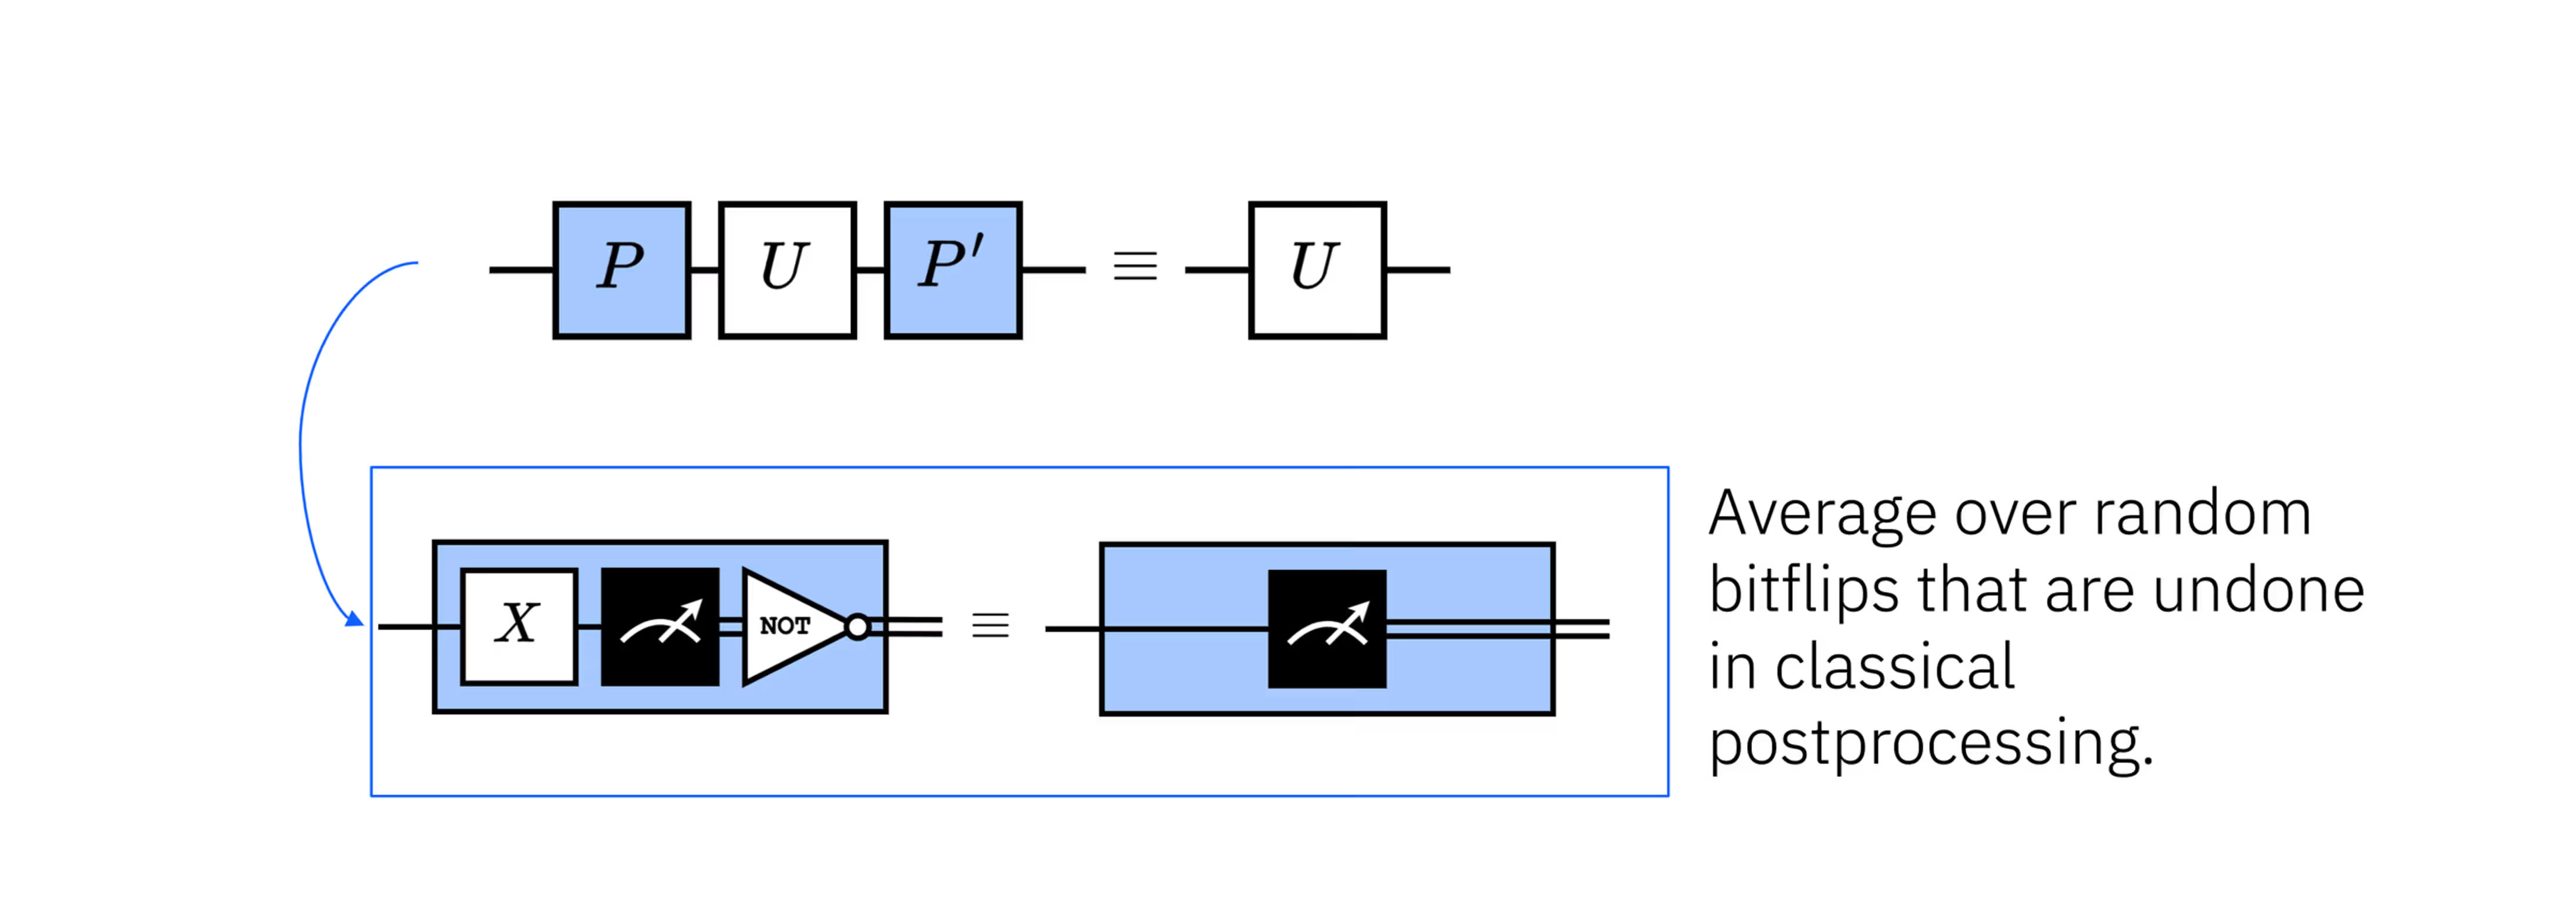
Průměrování přes tyto randomizace symetrizuje kanál čtení. Systematické asymetrie procesu čtení se tak převedou na symetričtější chybový kanál, jehož zbývající účinek lze zpracovat kalibrací a přeškálováním. Jednoduše řečeno, pokud by například existovalo zkreslení ve prospěch stavu , chyběla by nám některá měření . Twirlingem kolem měření náhodně zaměňujeme, který logický výsledek je spojen s fyzickým procesem čtení, a poté tuto záměnu klasicky vrátíme. Průměrování přes mnoho takto zrandomizovaných měření odstraní systematickou preferenci jednoho hlášeného výsledku před druhým. Tím se za předpokladů modelu TREX odstraní dominantní zkreslení měření, takže máme:
Očekávané hodnoty však stále může být nutné přeškálovat. Druhou fází je použití kalibračních obvodů (obvodů se známými výsledky) k odhadu škálovacího faktoru . Ten lze pak použít k získání výrazně vylepšeného odhadu.
Očekávané hodnoty Pauliho pozorovatelných se stávají nezkreslenými estimátory svých ideálních hodnot. Nenaučí se ani neinvertuje žádný explicitní model šumu, a proto je TREX numericky stabilní a levný. Opět platí, že chyba hradel zde řešena nebyla.
Při odhadu očekávané hodnoty pozorovatelné může existovat rozptyl způsobený konečným vzorkováním, mnoho typů nekoherentních i koherentních chyb a také zkreslení způsobené chybou čtení. Toto zkreslení vzniká ze zdrojů, jako jsou asymetrické přechody, o nichž jsme mluvili. V praxi je toto zkreslení typicky dobře modelováno jako klasický stochastický kanál působící po kvantovém vývoji. TREX transformuje efektivní měřicí kanál tak, aby estimátor byl vůči chybě čtení nezkreslený. To je relativně snadné nahlédnout na nejjednodušším příkladu twirlingových hradel: X. Pokud existuje asymetrie mezi a , ale my náhodně přepínáme, který stav se čte (a později klasicky překlopíme zpět), pak se tím systematická asymetrie zjevně odstraní (ačkoli konečné vzorkování stále znamená, že může existovat mírná stochastická asymetrie měření). V praxi nejsou twirlingová hradla pro TREX omezena na I a X, ale pro vysvětlení to stačí.
TREX nám umožňuje získat odhad očekávané hodnoty bez zkreslení způsobeného chybou čtení. Stále může existovat zkreslení z jiného zdroje (například koherentní přetočení); TREX cílí pouze na čtení. Protože TREX nahrazuje systematické zkreslení zrandomizovanou symetrizací, obecně převádí zkreslení na dodatečný stochastický rozptyl, čímž při pevných nákladech na vzorkování zvyšuje rozptyl estimátoru.
Ověř si své porozumění
Předpokládejme, že použijeme estimator na obvod, který připravil stav , při odhadu . Dále předpokládejme, že chyby měření způsobují, že výsledky odpovídající jsou v 10 % případů hlášeny jako , zatímco výsledky odpovídající jsou hlášeny jako jen v 1 % případů. Asymetrie mezi těmito chybami hlášení zavádí zkreslení měření.
(a) Jaká by byla ideální očekávaná hodnota pozorovatelné bez jakýchkoli takových chyb měření?
(b) Jaká je očekávaná hodnota pozorovatelné s asymetrickými chybami měření neboli čtení?
(c) Uvažuj omezenou sadu Pauliho twirlingových hradel: I a X. Předpokládej, že I a X se aplikují náhodně s pravděpodobností 50 % v mnoha shotech. Stále platí stejné míry chyb měření. Poté se Pauliho hradlo (I nebo X) klasicky vrátí zpět. Sestav tabulku všech možných výsledků a jejich pravděpodobností v důsledku počáteční superpozice, asymetrických chyb měření a náhodně přiřazených Pauliho hradel.
(d) Pomocí tabulky urči očekávanou hodnotu při použití strategie twirlingu.
(e) Porovnej očekávané hodnoty: ideální, bez twirlingu a s twirlingem.
(f) Co bylo v tomto zpracování vynecháno oproti plné aplikaci TREX?
Odpověď
(a) Stačí použít intuici a symetrii a říct, že . Explicitně to ukážeme takto:
(b) Stav může při měření zkolabovat buď do , nebo do , každý s pravděpodobností 50 %. Z oněch 50 %, které zkolabují do stavu , však 1 % (neboli 0,5 % všech případů) bude chybně nahlášeno jako . Z oněch 50 %, které zkolabují do , bude 10 % (neboli 5 % všech případů) chybně nahlášeno jako . Zbývá nám tedy:
- 54,5 %
- 45,5 % Při zanedbání všech ostatních možných typů chyb bychom získali odhad
(c)
| Pauli | Ideální výsledek měření | Výsledek po Paulim | Chyba čtení | Zrušení Pauliho | Finální nahlášený výsledek | Pravděpodobnost |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Žádná | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Žádná | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Žádná | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Žádná | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Z předchozích částí známe očekávané hodnoty Z v každém z finálních stavů. Stačí vzít vážený průměr:
(e) V tomto velmi jednoduchém případě naše aplikace twirlingu přesně obnovila ideální očekávanou hodnotu. To není typické. Typické je, že twirling odstraní zkreslení, jako je to zavedené asymetrickými přechody, a vrátí očekávanou hodnotu blíže ideální.
(f) Jde o aplikaci ilustračního modelu. Může chybět několik věcí. Především jsme zde nespustili kalibrační obvody k odhadu přeškálovacího faktoru . To je obvykle nezbytné.
Podrobnosti implementace
TREX se automaticky aplikuje při použití primitiva EstimatorV2 s resilience_level = 1 (výchozí hodnota). Všimni si, že se neaplikuje automaticky na primitivum Sampler, protože Sampler vrací úplná rozdělení pravděpodobnosti, nikoli očekávané hodnoty.
Když je TREX zapnut, runtime generuje varianty obvodů s twirlingem měření vložením náhodných jednoqubitových Pauliho operátorů bezprostředně před měření. Klasické zpracování tyto Pauliho operátory zvrátí. Tyto varianty obvodů jsou náhodné napříč různými shoty a také napříč různými qubity v rámci jednoho shotu. Všechny varianty obvodů se poté zkombinují do jediného estimátoru.
TREX je velmi škálovatelný. Vyžaduje dodatečné kalibrační obvody, takže režie vzorkování je typicky malý konstantní faktor (často 2-4x). Zmírňování je však specifické pro pozorovatelnou veličinu a nezachovává rozdělení.
TREX je navržen tak, aby se čistě integroval s mnoha metodami potlačování a zmírňování chyb, včetně následujících:
-
Dynamické oddělování (DD) - působí během doby nečinnosti, ortogonálně ke zmírňování chyb čtení.
-
Twirling hradel nebo Pauliho twirling - často komplementární; TREX již na twirlingu stojí, ale cílí pouze na šum čtení.
-
Zero-Noise Extrapolation (ZNE) - ZNE cílí na šum hradel, zatímco TREX řeší zkreslení měření. Tato kombinace se používá na úrovni resilience 2.
-
Pravděpodobnostní zesilování chyb a pravděpodobnostní rušení chyb ve workflow s Estimator.
Některé metody však nelze (nebo by se neměly) s TREX kombinovat:
-
Korekce pravděpodobností na úrovni Sampler: TREX nevrací opravené pravděpodobnosti bitových řetězců.
-
Dodatečné zmírňování na datech již zmírněných pomocí TREX: dvojitá korekce může znovu zavést zkreslení.
Kombinovat TREX s mitigací chyb měření založenou na assignment matici, jako je M3, je nepřímočaré. M3 předpokládá pevný měřicí kanál. TREX měření záměrně randomizuje, čímž se předpoklad používaný v M3 stává neplatným. V tomto smyslu tyto techniky nelze jednoduše kombinovat. Pokud ale použiješ measurement twirling během kalibrace používané v M3, můžeš být schopen využít současně přístup podobný assignment matici i twirlingovou mitigaci (i když tento twirlingový přístup není úplně totéž co TREX). To je opakující se téma při kombinaci mitigačních a potlačovacích technik: slepé přidávání technik selhává; jejich pečlivé přidávání tak, aby o sobě „věděly“, může fungovat a být velmi přínosné.
TREX zaručuje pouze střední hodnoty bez zkreslení způsobeného chybami čtení; nesnižuje rozptyl a nechrání ani před jinými typy zkreslení. Rozhodně neopravuje všechny chyby. Často je to ale podstatné zlepšení a lze ho dosáhnout s mnohem nižší režií než u některých jiných metod, které vyžadují učení úplných modelů šumu. TREX je často nejlevnější a nejrobustnější dostupná mitigace chyb čtení, a proto je výborným výchozím nastavením v experimentech.
TREX s Qiskit
Zde vytvoříme jednoduchý dvouqubitový obvod a pomocí Estimator odhadneme střední hodnotu velmi jednoduché pozorovatelné ZX. Ideální střední hodnota je 1. Střední hodnoty porovnáme s TREX a bez něj.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Vytvoř jednoduchý kvantový obvod.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpiluj obvod pomocí pass manageru.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Aplikuj na pozorovatelnou stejné rozložení (layout) z transpilace.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Spusť experiment na skutečném kvantovém počítači. Nejprve pokračujeme s reslience_level = 1; to je výchozí hodnota, ale uvedli jsme ji explicitně, abychom oba případy odlišili.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Nyní nastavíme resilience_level na 0, abychom běželi bez TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Střední hodnota je s TREX podstatně blíže ideální hodnotě (1), jak se dalo očekávat. Samozřejmě šlo o jedinou střední hodnotu na jediném qubitu. Nyní připravíme obvod s non-Cliffordovými hradly a mnoha qubity, abychom otestovali, zda zlepšení z TREX zůstává robustní i v jiném nastavení.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Na rotačním úhlu není nic zvláštního. Zvolili jsme prostě libovolnou nerovnoměrnou superpozici a , abychom prozkoumali účinky asymetrických chybných přechodů a to, jak s nimi TREX zachází. Pro tento stav by ideální střední hodnota Z na každém qubitu, při absenci jakýchkoli chyb (čtení či jiných), byla:
Doufáme tedy, že získáme střední hodnoty blízké -0,924 na všech qubitech. Uvidíme, zda TREX zlepší každou střední hodnotu jednotlivě a také zda zlepší průměr přes všechny qubity.
Ověř si své porozumění
Ověř výše uvedenou střední hodnotu přímým výpočtem.
Odpověď
Transpilujeme pomocí pass manageru.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Nyní sestrojíme jednu pozorovatelnou na qubit, abychom mohli odhadnout všech dvacet středních hodnot v jediném workflow. To znamená, že pro qubit chceme pozorovatelnu se samými identitami , kromě pozice, kde chceme . Nezapomeň aplikovat svůj transpilovaný layout i na pozorovatelné.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Nyní můžeme spustit. Buňka s kódem níže používá session mode; pokud nemáš přístup k sessions, můžeš ho nahradit batch mode a spustit stejný workflow, ale s možnými čekacími dobami ve frontě mezi obvody.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Zde porovnáváme střední absolutní chyby s TREX a bez něj.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
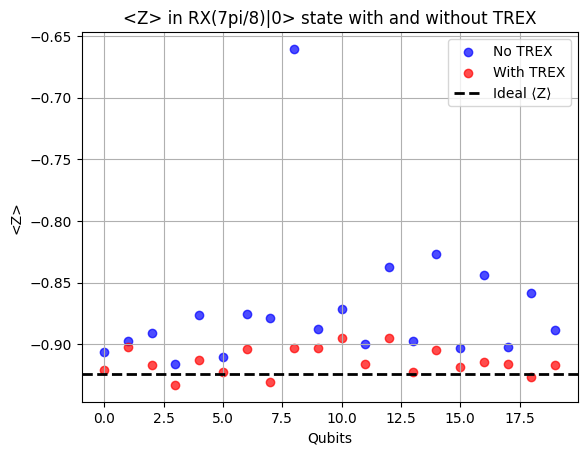
TREX evidentně pomohl. Střední hodnota se zlepšila na každém qubitu, s jedinou výjimkou qubitu 16. Takový odlehlý případ je očekávaný. Celkový účinek TREX na obvod můžeme vyčíslit pomocí průměrných hodnot.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
V průměru TREX posunul naše výsledky asi o 2,9 % blíže k ideálním výsledkům a zanechal nás s výsledkem, který se v průměru liší od teoretického ideálu pouze o 0,4 %. To je skvělé a právě toto zlepšení s nízkou režií je důvodem, proč je TREX výchozí mitigací chyb v Estimator. Musíme ale znovu zdůraznit, že TREX odstraňuje zkreslení způsobené chybou čtení, nikoli opravuje všechny naše chyby. Zvolili jsme počáteční stav, který měl velkou šanci být ovlivněn asymetrií čtení. Kdybychom každý qubit připravili v jiném stavu, účinek by byl jiný. Jednoduchý argument, proč tomu tak musí být: uvaž, co by se stalo, kdybychom každý qubit nechali v základním stavu . Nebyla by žádná příležitost pozorovat (ani opravit) asymetrii chyby čtení mezi stavy a .
Extrapolace k nulovému šumu (ZNE)
Extrapolace k nulovému šumu (ZNE) je jednou z nejpoužívanějších technik mitigace chyb. Obecná strategie je také snadno pochopitelná, i když detaily implementace jsou složité. ZNE funguje takto:
-
Spouští cílový obvod při několika „úrovních šumu“ — úpravách obvodu, které způsobí, že jeho šum roste předvídatelným způsobem
-
Odhaduje sledovanou pozorovatelnou pro každou úroveň šumu.
-
Extrapoluje zpět k nulovému šumu pomocí fitovacího modelu (lineárního, polynomiálního, exponenciálního atd.).
Výsledkem je odhad toho, jaká by pozorovatelná byla v limitě nulového šumu, kterou implikuje extrapolační model.
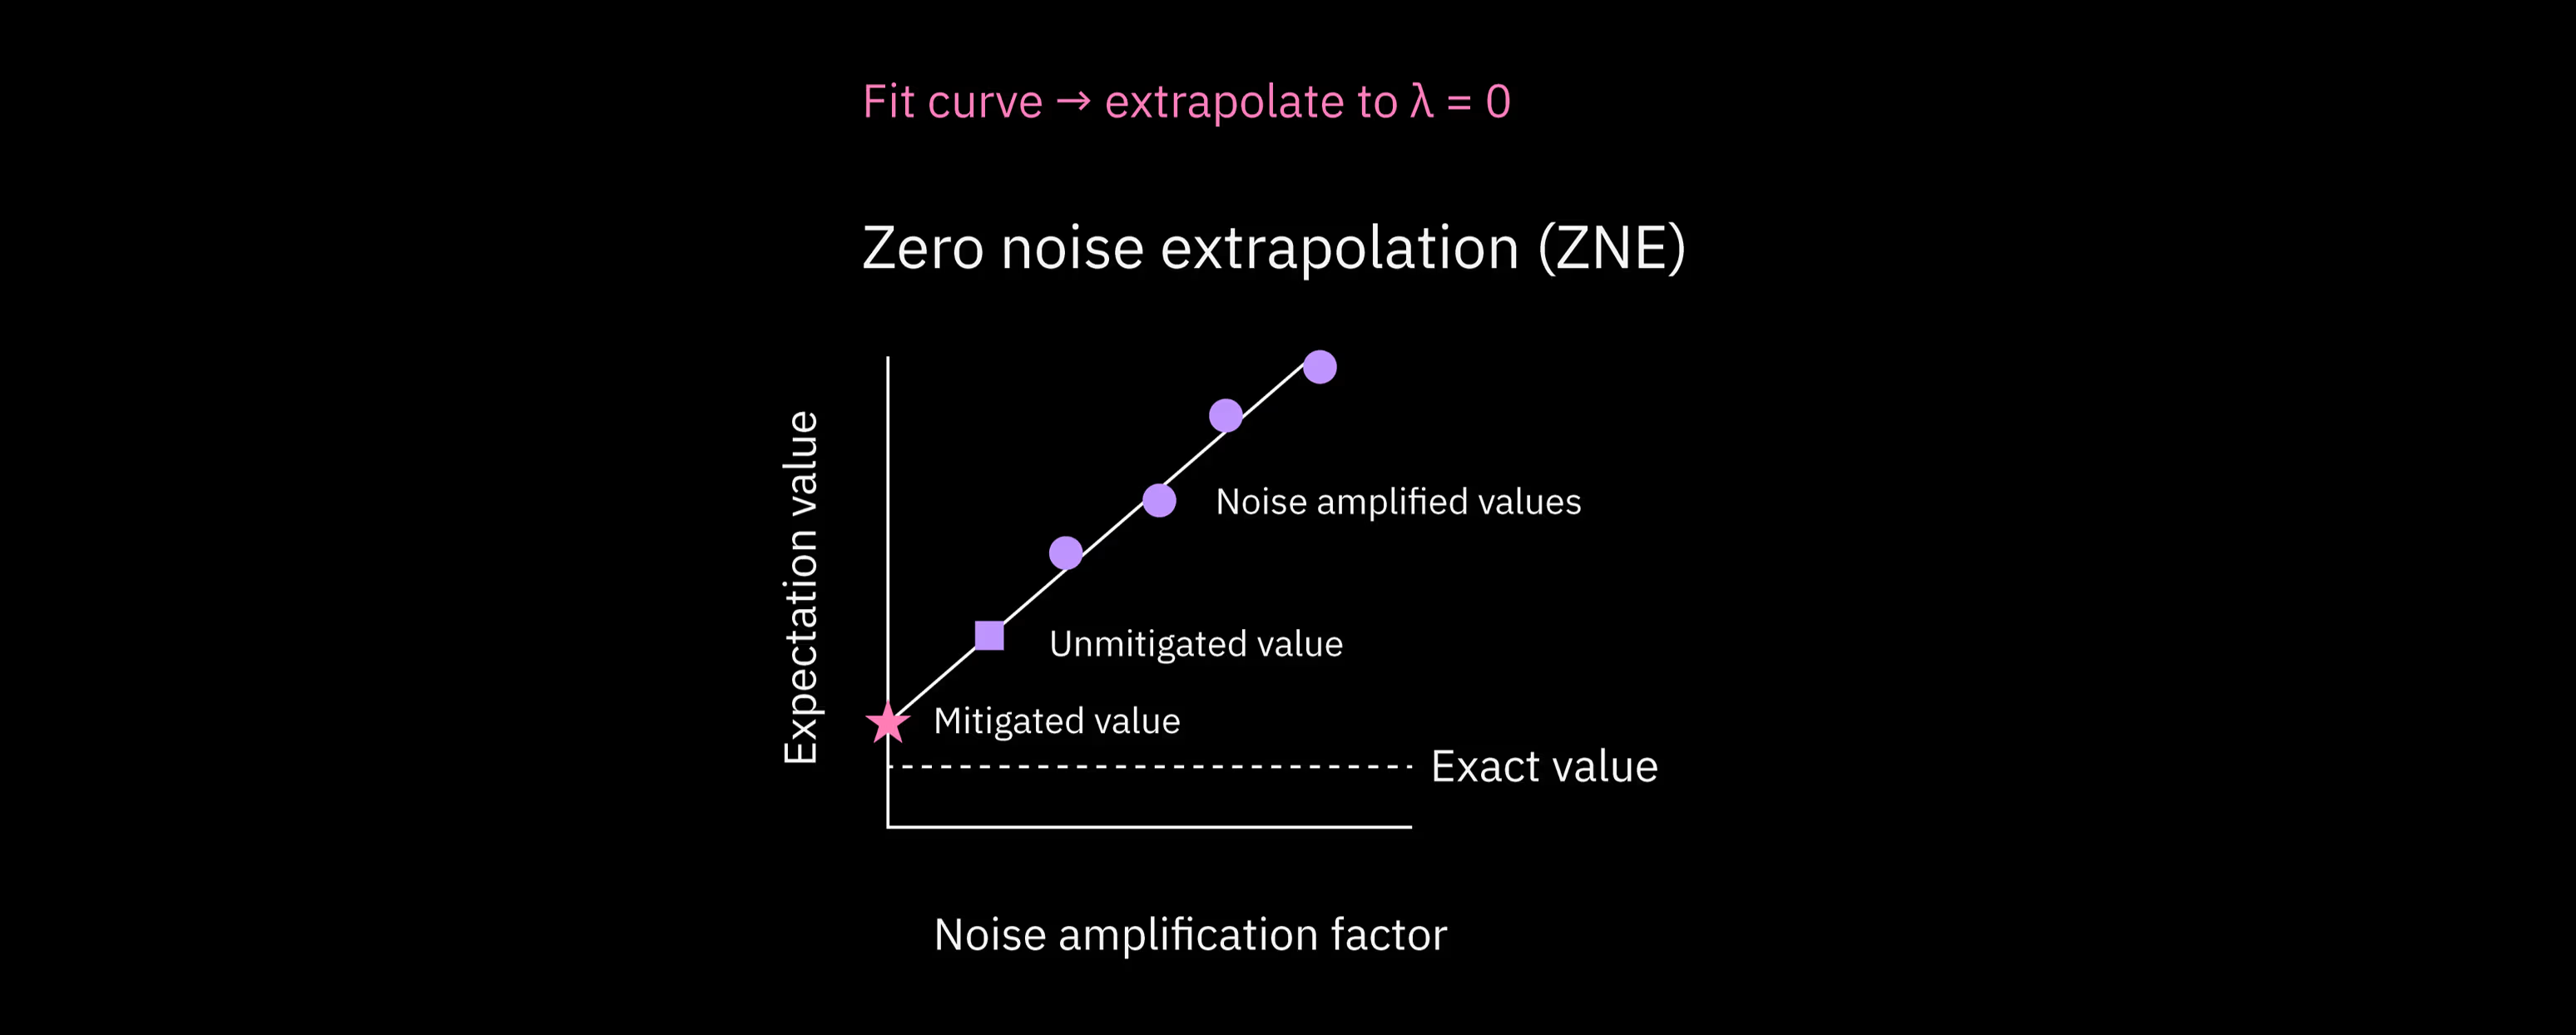
ZNE nezaručuje, že šum roste plynule nebo lineárně, když obvody upravujeme. Místo toho předpokládá, že škálování šumu je dostatečně dobře chovající se, aby umožnilo extrapolaci. Složitost ZNE spočívá v tom, jak upravit obvody, aby byl tento předpoklad splněn co nejlépe. V této lekci se podíváme na některé přístupy.
Škálování zdrojů u ZNE
U ZNE je režie převážně kvantová. To znamená, že pro získání středních hodnot při úrovních šumu musíš provést experiment na obvodech, každém s mnoha shoty. Aby se zachovala pevná statistická přesnost, celkový počet vzorků obecně roste s přidáváním dalších obvodů se škálovaným šumem.
Počet úrovní šumu, které zkoumáš, , závisí na metodě použité ke škálování šumu. Pro jednu jednoduchou techniku škálování šumu (nazývanou „gate-folding“, probíranou níže) je běžně mezi 3 a 5. Jiná metoda (probabilistic noise amplification (PNA)) umožňuje neceločíselné faktory šumu a typicky vede k nižším úrovním šumu než gate-folding. Celková režie roste zhruba jako:
kde je základní počet shotů. Další věc, na kterou je třeba myslet: pokud škálování šumu zahrnuje opakovaná hradla, hloubka obvodu se může zvětšit o faktor úměrný hodnotě škálování šumu. Škálování šumu, které přichází se zvýšenou hloubkou, je právě záměrem, ale celkovou hloubku měj na paměti.
ZNE se hodí pro problémy, u kterých platí následující body:
-
Potřebuješ univerzální metodu mitigace účinnou na mnoho typů chyb.
-
Hloubka obvodu není příliš velká; ZNE selhává, když se škálovaný obvod stane příliš zašuměným na extrapolaci.
-
Můžeš tolerovat mírnou režii doby běhu výměnou za vyšší přesnost.
V praxi je ZNE díky tomu ideální pro mnoho variačních obvodů, odhad středních hodnot a další kvantové algoritmy blízké budoucnosti. V Estimator je implementováno pomocí resilience_level = 2. Všimni si, že ZNE extrapoluje v prostoru, který má jediný výsledek jako funkci šumu v celém obvodu. To znamená, že se hodí pro problémy odhadu, ale ne pro problémy vzorkování. Není navrženo pro práci s rozděleními bitových řetězců.
Faktory šumu
Jak přesně můžeme zvýšit úroveň šumu v obvodu? Existují dva hlavní způsoby, ačkoli existuje mnoho variant.
-
Nahraď hradlo nebo blok hradel za . Protože hradla na kvantových počítačích jsou unitární, víme, že , takže logicky: . Každé opakování nebo však přidává podobnou nebo stejnou chybu, což nám umožňuje zvyšovat úrovně šumu/chyb. Všimni si, že výše uvedená náhrada nás přivádí od původního šumu hradla (úroveň šumu 1) k trojnásobné úrovni šumu v (úroveň šumu 3). V praxi můžeme poslední dvě hradla opakovat krát: a získat úroveň šumu . Tomu se říká gate folding a je to velmi běžná technika škálování šumu.
-
Existují i jiné metody zvyšování úrovně šumu, například probabilistic error amplification (PEA). U PEA se nejprve naučíme vhodný model šumu pro obvod, typicky vyjádřený jako Pauliho kanál. Šum se pak zesiluje vzorkováním z přeškálované verze tohoto naučeného kanálu šumu. Úpravou vzorkování můžeš spojitě škálovat efektivní sílu šumu, včetně neceločíselných hodnot.
V praxi gate folding dokáže chyby škálovat velmi spolehlivě, ale může také vést k velmi hlubokým obvodům. Pokud potřebuješ jen tři úrovně šumu (1, 3 a 5), znamená to zvětšit hloubku obvodu 5krát a stále získat rozumné výsledky. Proto pokud má tvůj cílový obvod po transpilaci dvouqubitovou hloubku 60 nebo více, je PEA pravděpodobně vhodnější než gate-folding.
Hradla lze skládat buď lokálně (tedy opakuješ pro každé dvouqubitové hradlo hned, jakmile se vyskytne), nebo je lze seskupit do bloku hradel a tento blok opakovat (jako hradla ). Lokální skládání je často výhodnější vzhledem k předpokladům ZNE, ale možné jsou obě varianty.
Do statistického zpracování výsledků se škálovaným šumem v ZNE vstupuje mnoho nuancí. Například při pětinásobné úrovni šumu budou mít tvé výsledky jistě vyšší rozptyl a budou méně spolehlivé. Měly by se zpracovat se stejnou vahou jako datové body s nižším šumem? Ne. Pro účely ukázky ZNE v praxi však část této složitosti u modelového experimentu ignorujeme: poskládané obvody sestavíme ručně a provedeme naivní extrapolaci se stejnými vahami, abychom ilustrovali klíčové kroky. Poté ale následuje experiment s funkcionalitou ZNE zabudovanou v Qiskit a uvidíš, že se se složitostí, kterou přeskakujeme, vyrovná podstatně lépe.
ZNE ručně
Začneme výběrem kvantového obvodu a pozorovatelné, pro které dokážeme spočítat ideální střední hodnotu bez šumu a chyb. Zvolíme GHZ stav se sudým počtem qubitů. Naše pozorovatelná je . Volíme ji z několika důvodů:
- Střední hodnotu je v ideálním případě triviální spočítat. Protože je počet qubitů sudý, dostaneme buď
1z každého , vynásobené dohromady, nebo-1z každého , vynásobené dohromady sudý početkrát. - Bude poměrně citlivá na chyby a šum, protože jediná chyba na jednom qubitu může převrátit celkový výsledek daného shotu z +1 na -1.
- Střední hodnota je daleko od 0. ZNE může narazit na potíže, když je ideální střední hodnota velmi blízko nule, protože vysoké úrovně šumu mají tendenci výsledky randomizovat, takže jsou stejně často kladné jako záporné. Výsledkem je, že vysoké hodnoty šumu nakonec dávají hodnoty blízké ideálu; to může extrapolaci velmi ztížit.
S touto motivací v mysli sestavme naše obvody.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Všimni si jemnosti, že zde . I když byl gate folding představen jako skládání operátorů tvaru , zde tatáž struktura vypadá jako CNOT CNOT CNOT.
Ujistěme se, že náš obvod je skutečně normální GHZ obvod:
ghz_amp[0].draw("mpl")
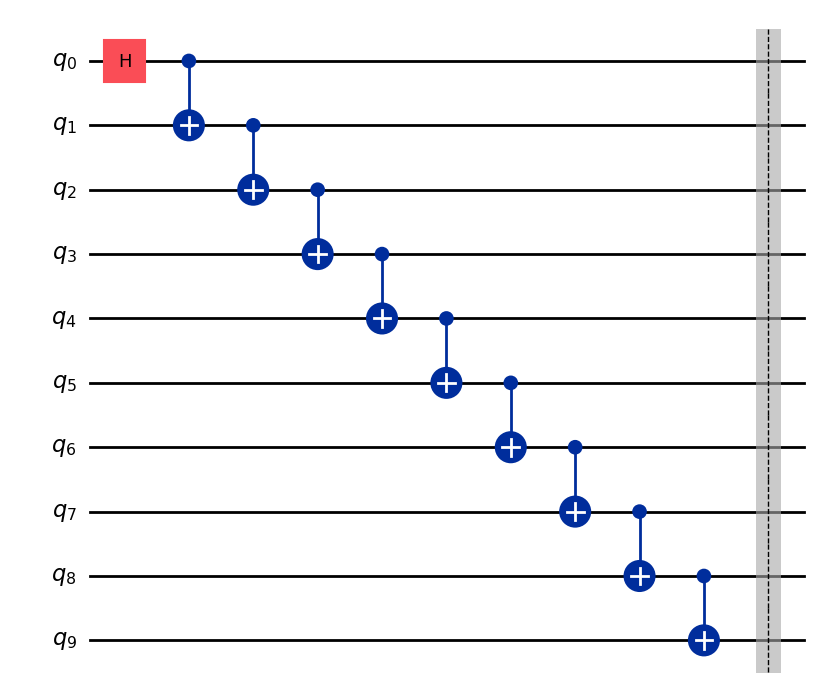
Můžeš se podívat na ostatní obvody a ověřit, že mají očekávanou strukturu.
Nyní sestavíme naše pozorovatelné.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Sestavíme pass manager a aplikujeme ho na naše obvody. Poté vezmeme layouty a aplikujeme je na naše pozorovatelné.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Naformátuj pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Nyní spustíme Estimator. Chtěli bychom se zaměřit na úlohu ZNE, a proto bychom mohli chtít nastavit resilience_level = 0, abychom nemíchali účinky twirlingu s účinkem ZNE. Chceme však také porovnat naše „ruční“ ZNE s nastavením ZNE zabudovaným v Qiskit, které zahrnuje twirling. Zde proto nastavujeme resilience_level = 1. Nastavení resilience_level = 2 vyvolá nastavení ZNE z Qiskit, které použijeme za chvíli.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Nyní vypíšeme úrovně šumu a střední hodnoty.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Toto je část, kde jsme nejnedbalejší: provádíme lineární fit těchto dat bez ohledu na rozptyl každé získané hodnoty a bez pokusu teoreticky předpovědět, zda musí být fit lineární. Zabudované ZNE opět odvádí mnohem lepší práci než to, co děláme ručně.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Před interpretací to rovnou vykreslíme.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
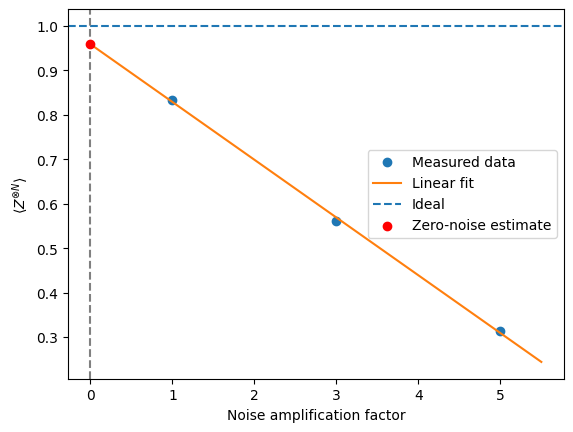
V době vzniku této lekce jsme z extrapolace k případu nulového šumu dostali střední hodnotu 0,959. Tvé hodnoty se mohou lišit. To je podstatně lepší než střední hodnota surového obvodu 0,83, asi o 13 % blíže ideální hodnotě. Vidíš ale také, že používáme jeden datový bod, kde střední hodnota klesla na 0,31. Tento datový bod je zjevně horší kvality. Kdyby tento bod dostal v naší lineární aproximaci nižší váhu a přímka by byla více přiložena k prvním dvěma datovým bodům, vidíme, že extrapolovaný odhad pro nulový šum by byl vyšší (blíže ideální hodnotě). Takovéto úvahy řeší automaticky ZNE zabudované v Estimator.
ZNE zabudované v Estimator
Nyní se podívejme, co se stane, když použijeme funkcionalitu ZNE zabudovanou v Estimator. Začneme definicí jednoduchého GHZ obvodu bez jakéhokoli gate foldingu.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definujeme stejnou pozorovatelnou jako předtím.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Znovu definujeme pass manager s optimization_level = 1. K této volbě se vrátíme níže.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpiluj obvod a aplikuj layout na pozorovatelné.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Spustíme Estimator s ZNE a twirlingem a porovnáme výsledky s naší ruční implementací ZNE. Zejména je porovnáme s výsledkem bez ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Hodnoty při každém faktoru šumu můžeme získat pomocí syntaxe job_zne.result()[0].data.evs_noise_factors. Stejně jako dříve bychom mohli tyto výsledky naivně použít k lineárnímu fitu a extrapolaci k případu nulového šumu, ale estimator s resilience_level = 2 už odvedl lepší práci, když zohlednil rozptyl a další aspekty. Níže ukazujeme, co by dala lineární extrapolace, a co skutečně dalo zabudované ZNE.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
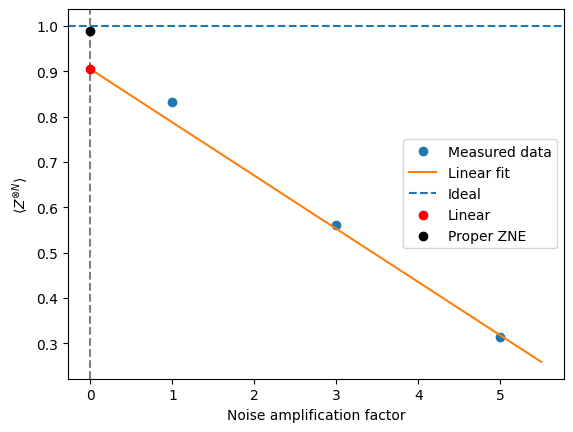
Vidíme, že zabudované ZNE zlepšilo náš odhad o více než 15 % a fungovalo podstatně lépe než náš ruční pokus.
Než půjdeme dál, všimni si, že během celého tohoto zkoumání ZNE jsme v pass manageru nastavili optimization_level = 1. Vyšší úrovně optimalizace snižují chybu a někdy může snížení chyby způsobit, že chyby škálují méně předvídatelně. Jako často jde o rovnováhu: snižuj chyby, kromě případů, kdy je záměrně zvyšuješ o známý faktor.
Kombinování metod
ZNE se opírá o následující:
-
Dobře definovaný parametr škálování šumu
-
Dostatečně hladké a předvídatelné škálování středních hodnot s
-
Stejný efektivní kanál šumu při různých silách
-
Žádné zkreslení, které by neškálovalo s
ZNE se dobře kombinuje s technikami, které odstraňují neškálující zkreslení (jako M3) nebo činí šum pravidelnějším (jako twirling), ale je v konfliktu s technikami, které se buď snaží šum zcela vyrušit (PEC), nebo ho dynamicky přetvářejí (DD).
M3 konkrétně řeší pouze chyby měření/čtení, které lze v praxi považovat za oddělené od chyb hradel (na ty se zaměřují procesy škálování chyb v ZNE). M3 je do značné míry nezávislé na gate foldingu; lze ho čistě kombinovat se ZNE. TREX je velmi podobný a lze ho se ZNE kombinovat.
Pauli twirling se na rozdíl od M3 a TREX zaměřuje na hradla. Připomeň si ale, že Pauli twirling šum/chyby přímo nemitiguje; spíše je mění tak, aby byly předvídatelnější. Pauli twirling může být pro proces ZNE skutečně prospěšný, protože způsobí lineárnější škálování chyb hradel, a extrapolace tak bude přesnější.
Dynamical decoupling (DD) je nuancovanější. DD dynamicky mění chování šumu tím, že přidáním sekvencí hradel částečně ruší určité chyby. Pokud je možné obvody sestrojit tak, aby se DD choval stejně i při složených hradlech či blocích, pak by se v principu ZNE a DD daly kombinovat, ale v praxi DD někdy škálování ruší. Pokud je chceš kombinovat, je třeba zvážit například následující:
- Je DD aplikováno konzistentně na všech úrovních šumu?
- Zachovává skládání strukturu DD?
- Chová se výsledné škálování šumu stále monotónně?
Poslední metoda mitigace chyb, kterou probereme jako samostatný přístup, není se ZNE kompatibilní: probabilistic error cancellation.
Probabilistic Error Cancellation (PEC)
Na rozdíl od ZNE nebo mitigace chyb měření se PEC snaží rušit šum na úrovni hradel tím, že v průměru rekonstruuje ideální kanál. Probabilistic Error Cancellation (PEC) je nejvýkonnější a nejnákladnější technika mitigace chyb probíraná v této lekci. PEC je postavena na explicitní inverzi kanálu šumu, prováděné staticky, nikoli fyzicky. PEC funguje takto:
-
Charakterizuje model šumu pomocí báze „chybových operací“.
-
Vyjadřuje inverzi kanálu šumu jako kvazipravděpodobnostní rozdělení nad fyzickými operacemi.
-
Vzorkuje z tohoto rozdělení během provádění obvodu, aby statisticky sestavila nezkreslený odhad ideálního výpočtu.
Koncepčně je PEC jako virtuální korekce chyb — šum „odčiňuje“ kombinováním zašuměných operací v pečlivě vážených náhodných vzorcích. Procedurálně však PEC s korekcí chyb ani s kódy detekce chyb úzce nesouvisí. Nezkreslený odhad ideální bezšumové střední hodnoty u PEC přichází za cenu velmi velké režie vzorkování a silné závislosti na přesné charakterizaci šumu.
Na kvantových počítačích IBM je PEC nejlépe chápat jako přesný nástroj spíše než jako univerzální vrstvu mitigace: nejvhodnější je pro malé obvody nebo malé části větších obvodů, úlohy benchmarkingu a studie s vysokou přesností, kde je vysoká kvantová režie přijatelná.
Charakterizace kanálu šumu
U PEC je každé ideální hradlo v kvantovém obvodu modelováno jako ideální unitární kanál následovaný procesem šumu. Nechť označuje matici hustoty kvantového stavu. Ideální hradlo je reprezentováno unitární maticí , která indukuje kvantový kanál:
Na skutečném hardwaru je tento ideální vývoj narušen šumem. Fyzickou implementaci hradla modelujeme jako efektivní zašuměný kanál:
kde je kanál šumu zachycující stochastické chyby spojené s hradlem. V celé této diskusi jsou , a lineární zobrazení působící na operátory hustoty. Ideální kanál je unitární a vratný, zatímco kanál šumu (a tedy i ) je úplně pozitivní zobrazení zachovávající stopu (CPTP).
PEC předpokládá, že kanál šumu je znám nebo přibližně znám. Na hardwaru IBM Quantum se tato informace typicky získává z kalibračních dat zařízení, z chybovosti odvozené z benchmarkingových experimentů a ze zjednodušených modelů šumu, jako jsou Pauliho nebo depolarizační aproximace pro malé sady hradel. PEC sice nevyžaduje dokonale přesný model šumu, ale jeho výkon rychle klesá, když se předpokládaný kanál šumu odchyluje od skutečného chování hardwaru.
Kvazipravděpodobnostní rozklad inverzního kanálu šumu
Ústřední myšlenkou PEC je v průměru zrušit vliv šumu sestrojením stochastické aproximace inverze kanálu šumu. Formálně je cílem aplikovat lineární zobrazení, které přibližně odčiní , tak, aby:
v průměru přes mnoho provedení obvodu.
Inverze je zde definována jako algebraická inverze chápaného jako lineární superoperátor působící na operátory. Tato inverze existuje, pouze pokud má plnou hodnost; neinvertovatelné procesy šumu nelze pomocí PEC přesně mitigovat.
Když je inverze možná, PEC vyjádří inverzní kanál šumu jako lineární kombinaci fyzicky realizovatelných operací:
Zde je každé zašuměná operace, kterou lze na hardwaru provést (typicky nativní hradla nebo krátké sekvence hradel), a reálné koeficienty tvoří kvazipravděpodobnostní rozdělení. Na rozdíl od běžných pravděpodobností mohou být koeficienty záporné nebo přesáhnout 1.
Kvazipravděpodobnostní norma:
vyčísluje náklady inverze šumu. Pro jakýkoli netriviální kanál šumu platí . Na hardwaru IBM Quantum se tento rozklad typicky provádí:
- pro každé hradlo nebo pro každou malou sadu hradel,
- za předpokladu omezených modelů šumu (často Pauli-diagonálních aproximací),
- s použitím nativních operací specifických pro backend a omezení plánování.
Monte Carlo rekonstrukce ideálního obvodu
K odhadu střední hodnoty pozorovatelné používá PEC Monte Carlo vzorkování založené na výše uvedeném rozkladu. Pro každý výskyt zašuměného hradla v obvodu se aplikuje následující postup:
-
Náhodně vyber operaci s pravděpodobností:
-
Přiřaď klasickou váhu:
-
Proveď výsledný randomizovaný zašuměný obvod na kvantovém backendu.
-
Vynásob naměřený výsledek součinem všech nasbíraných vah.
-
Zprůměruj vážené výsledky přes mnoho provedení obvodu.
Výsledný estimátor splňuje
pokud model šumu přesně popisuje hardware. PEC tedy v průměru nezavádí žádné systematické zkreslení, ale nahrazuje zkreslení velkým statistickým rozptylem. Každý běh dává zašuměný, ale vážený odhad; teprve po zprůměrování mnoha takových běhů se objeví ideální střední hodnota.
Koncepční interpretace
PEC je někdy popisována jako virtuální korekce chyb. Ačkoli toto vyjádření není zcela nesprávné, nemělo by se zaměňovat se skutečnou kvantovou korekcí chyb. PEC nezahrnuje žádné logické kódování, žádnou extrakci syndromu a žádnou zpětnou vazbu v reálném čase. Chyby se během provádění obvodu nepředcházejí ani neopravují.
Místo toho PEC ruší šum statisticky, kombinováním mnoha zašuměných realizací obvodu se znaménkovými klasickými vahami tak, aby se chyby vyrušily až po klasickém post-processingu. Informace není během provádění chráněna; ideální výsledky se rekonstruují dodatečně.
Škálování zdrojů a náklady
Dominantní náklad PEC pramení ze zesílení rozptylu. Rozptyl estimátoru PEC škáluje jako:
z čehož plyne:
Toto škálování je zásadní a nelze ho zlepšit klasickým post-processingem.
U obvodů obsahujících mnoho zašuměných hradel každé hradlo přispívá faktorem , takže celková kvazipravděpodobnostní norma roste přibližně multiplikativně:
kde je hloubka obvodu. Na hardwaru IBM Quantum to typicky vede k exponenciálnímu růstu nákladů na vzorkování s hloubkou obvodu, s obzvlášť silnou citlivostí na chyby dvouqubitových hradel. Toto škálování stanovuje praktické limity použitelnosti PEC.
PEC je v současnosti praktická pouze tehdy, když je splněna jedna nebo všechny z následujících podmínek:
-
Obvody jsou velmi malé nebo mělké (často hradel),
-
Modely šumu jsou jednoduché a dobře validované (například Pauliho šum),
-
Vysoké statistické náklady jsou přijatelné,
-
Cílem je přesnost spíše než propustnost.
Z tohoto důvodu se PEC často aplikuje na:
-
Izolované podobvody ve větších workflow,
-
Kroky krátkodobého vývoje,
-
Rutiny přípravy stavu nebo měření,
-
Benchmarkingové a validační experimenty.
Softwarový stack IBM (IBM Quantum Compute a nástroje pro mitigaci chyb) to odráží tím, že PEC považuje za specializovanou volbu, nikoli za výchozí vrstvu mitigace.
Typické případy použití PEC zahrnují:
-
Přesné srovnávací testování kvantového hardwaru,
-
Ověřování malých kvantových algoritmů,
-
Vysoce přesná kvantová chemie na zmenšených systémech,
-
Křížová kontrola ZNE nebo jiných metod mitigace.
Vztah PEC k ostatním metodám mitigace
Mnoho jiných technik mitigace obětuje přesnost ve prospěch škálovatelnosti; PEC dělá pravý opak a soustředí se především na přesnost.
Protože se PEC může použít jen na podobvod, je tu obzvlášť důležité ptát se, které další metody mitigace lze s ním kombinovat. Aby šlo jasně uvažovat o kompatibilitě s PEC, pomáhá rozdělit techniky podle toho, co dělají se šumem. Uvažuj tyto obecné kategorie:
-
Potlačení šumu - pokus o inverzi chybových kanálů
-
Škálování šumu - záměrné zvýšení šumu za účelem extrapolace
-
Přetváření šumu - změna struktury nebo spektra šumu
-
Odstranění systematické chyby - oprava chyb, které se neškálují se šumem hradel
PEC patří jednoznačně do kategorie (1). Každou metodu, která mění nebo přeškálovává šumový kanál, je třeba pečlivě prozkoumat.
Souhrnná tabulka (na vysoké úrovni)
| Technika | Kompatibilní s PEC | Poznámky |
|---|---|---|
| ZNE | Ne | Odstraňování oproti škálování a někdy i přizpůsobování chyby |
| Pauliho twirling | Ano (s opatrností) | Ovlivňuje chování chyb, ale může usnadnit jejich učení |
| TREX | Ano | Žádný překryv v pracovním postupu. Plně kompatibilní. |
| Dynamické oddělení | Většinou ne | Mění chybový kanál |
PEC a ZNE řeší stejné zdroje chyb (chyby hradel) prostřednictvím vzájemně neslučitelných předpokladů či pracovních postupů, nebo obojího. Například v ZNE předpokládáme, že chybu lze rozvinout v parametru :
a že chybu lze účinně škálovat tak, aby odpovídala tomuto rozvoji. PEC by odstranilo právě tu chybu, na které škálování stavíme. Parametr by ztratil smysl. Jiný pohled na věc je:
-
Použití ZNE před PEC mění šumový kanál, který se snažíš invertovat.
-
Použití PEC před ZNE odstraní právě ten šum, na který se ZNE při extrapolaci spoléhá.
PEC a ZNE je třeba považovat za alternativní paradigmata mitigace chyb, nikoli za skládatelné vrstvy. Porovnávat je vedle sebe je poučné, kombinovat je nikoli.
PEC a Pauliho twirling jsou obecně kompatibilní a často přínosné. Twirling může PEC pomoci tím, že převádí koherentní chyby na stochastické Pauliho chyby. Tím se šumový kanál zjednoduší, takže je snazší ho reprezentovat a invertovat. Pro PEC je to nesmírně cenné z těchto důvodů:
-
Kvazipravděpodobnostní rozklady jsou pro Pauliho kanály mnohem jednodušší
-
Kvazipravděpodobnostní norma bývá výrazně menší
-
Rozptyl vzorkování se snižuje
Mnoho ukázek PEC předpokládá Pauliho twirlovaný šum nebo jej přímo zahrnuje. Je důležité zdůraznit, že Pauliho twirling chyby sám o sobě nemitiguje; přetváří šum do podoby, kterou dokáže pravděpodobnostní potlačení chyb zpracovat efektivněji.
PEC lze a je vhodné kombinovat s TREX. Tyto přístupy jsou plně kompatibilní a hrají ortogonální role. TREX působí pouze při měření, odstraňuje chybu čtení pomocí náhodných twirlů měřicího kanálu a neovlivňuje šum hradel ani dynamiku obvodu. PEC působí na šum hradel. Protože je chyba měření aditivní, a nikoli kompoziční, nezávisí na posloupnosti hradel. Je bezpečné a často žádoucí používat TREX spolu s PEC.
Pořadí těchto metod je takové, jaké bys očekával:
- Spusť obvod randomizovaný pro PEC
- Použij TREX k mitigaci chyby čtení
- Aplikuj váhování a průměrování PEC
PEC a DD jsou obecně nekompatibilní, pokud se charakterizace šumu použitá pro PEC neprovádí se zapnutým DD. PEC předpokládá, že je stacionární, opakovatelný a přesně charakterizovatelný. DD výslovně přetváří šumový kanál v čase tím, že moduluje interakce systému s prostředím a zavádí netriviální efekty časování pulzů. Výsledkem je, že efektivní šum s DD není stejný kanál jako bez DD. Situaci ještě komplikuje to, že šumový kanál může citlivě záviset na plánování obvodu. Konečným důsledkem je, že inverze šumu se stává špatně definovanou nebo neplatnou.
Teoreticky je možné charakterizovat šum se zapnutým DD a podle toho sestavit model PEC, ale je to velmi pokročilé a v současnosti to není doporučený postup.
Ruční aplikace PEC
PEC je složité a nedoporučuje se implementovat ho ručně. Přesto si chceme projít matematiku základní aplikace na jednom qubitu, abychom pochopili, jaké kroky tento proces zahrnuje. Volíme smíšený, ale netriviální stav, abychom dobře viděli numerické efekty.
Vezmi qubit, který by měl být v čistém stavu
Ideální matice hustoty je:
Tuto matici hustoty jsme zvolili proto, že není diagonální a týká se jen jednoho qubitu, takže ji lze snadno zkoumat „ručně“.
Nyní aplikujeme velmi jednoduchý, ale realistický model šumu: depolarizační kanál jednoho qubitu s malou silou .
Aby byla aritmetika přívětivá, vezmi . Tento kanál je zcela pozitivní a zachovává stopu (CPTP), jak má být. Je to realistický šumový kanál pro skutečný hardware, nebo alespoň realistický pro popis části šumu. Dále je tento šumový kanál analyticky invertovatelný jako lineární zobrazení. Jinými slovy existuje inverzní matice, ale to neznamená, že tato matice odpovídá fyzikálnímu kanálu CPTP, a rozhodně neodpovídá unitární operaci, kterou by šlo na hardwaru implementovat.
Nyní aplikujeme náš depolarizační šumový kanál na matici hustoty jednoho qubitu a dostaneme:
Pro : a .
So:
Aplikací na náš stav dostaneme:
Spočítáme explicitně:
Je to stále fyzikální matice hustoty a stále má stopu jedna — ale nyní je více smíšená.
Nyní spočítáme ideální inverzní kanál, ale s plným vědomím, že nemusí být fyzikální. Ověříme, zda je. Matematicky je inverzní lineární zobrazení:
Kdyby tato inverzní akce sama byla platným fyzikálním kanálem, byli bychom v pokušení implementovat ji přesně. Samozřejmě bychom stále museli vymyslet, jak ji realizovat pomocí unitárních operací a klasických kroků, ale cílem by byla její implementace. Ukazuje se však, že není CPTP a obecně neexistuje záruka, že taková inverzní zobrazení budou CPTP. To je pro naši diskusi zásadní, protože právě proto PEC existuje.
Možná na první pohled poznáš, že není CPTP. Spolehlivou kontrolou je aplikovat ji na matici hustoty a zjistit, zda vrací fyzikální výsledky. To je ponecháno jako cvičení k ověření tvého porozumění.
Ověř si své porozumění
Ověř, zda je výše uvedené inverzní zobrazení CPTP, tak, že ho aplikuješ na novou matici hustoty:
Interpretuj výsledky jako fyzikální nebo nefyzikální.
Odpověď
Jako fyzikální matice hustoty to odpovídá klasické pravděpodobnosti větší než 1, že je systém ve stavu , a záporné pravděpodobnosti, že je ve stavu . Je zřejmé, že toto zobrazení může dávat nesmyslné matice hustoty. Dále lze pohledem zjistit, že vlastní čísla výsledné matice hustoty jsou 1.0625 a -0.0625, takže ne všechna vlastní čísla jsou kladná. Zobrazení tedy není „zcela pozitivní“, což je „CP“ v CPTP.
Ověř si své porozumění
Ověř explicitním výpočtem, že výše uvedená inverzní operace ruší šumový kanál a vrací stav bez šumu.
Odpověď
Aplikuj ji na zašuměný stav:
Je to přesně původní stav (až na zaokrouhlení).
Pro úplnou jasnost zopakujme: šumový kanál nelze invertovat přesně; inverze není CPTP ani platný fyzikální kanál. Můžeme však kanál účinně invertovat jako lineární kombinaci fyzikálních kanálů.
Pro depolarizační kanál:
kde: atd.
Inverzi lze zapsat jako:
with:
-
= fyzikálně implementovatelné Cliffordovy kanály
-
= kvazipravděpodobnosti
-
Some
To je základní myšlenka PEC:
-
Vzorkuj kanály podle ∣
-
Připoj znaménka k výsledkům měření
-
Střední hodnoty konvergují k hodnotě bez šumu
Aplikujeme PEC „ručně“ na odhad pomocí matice hustoty a uvidíme, zda dokážeme obnovit výsledky pro . Pro očekáváme:
Všimni si také, že pro zašuměnou matici hustoty dostaneme:
Je to správný řád, ale podstatně se to liší od ideálního případu.
Nyní si projdeme, jak můžeme pomocí procesu PEC rekonstruovat nezkreslenou střední hodnotu ze zašuměné matice hustoty. Ve skutečných pracovních postupech je to pravděpodobnostní a automatizované. V tomto „ručním“ postupu zvolíme pravděpodobnostní hodnoty, které jsou realistické, ale možná vhodné pro naši prezentaci. Neber to jako tvrzení, že PEC je dokonalé. Jde jen o ukázku věrohodného scénáře, který by se mohl odehrát uvnitř balíčků PEC.
Připomeňme, že náš šumový kanál má tvar:
Inverzi lze zapsat (přesně):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Pro tento úvod je jednodušší soustředit se na vliv kanálu na naši matici hustoty. Díky tomu můžeme pracovat se známými objekty, jako jsou matice hustoty a střední hodnoty. Proto uvažuj, co musí platit o účincích této inverzní operace na náš proces odhadu: odhadovač vytvořený PEC musí být normalizovaný a nezkreslený. Odpovídá to dvěma podmínkám:
-
Normalizace: Aby tato operace neměnila měřítko pozorovatelné, požadujeme . Abychom pochopili, proč tomu tak je, můžeme uvažovat působení inverze na matici hustoty, nebo její působení na střední hodnotu něčeho triviálního, jako je samotné .
-
Kalibrace: Ve skutečném pracovním postupu používáme kalibrační obvody, abychom poznali chování šumu na úrovni hradel. Poté využijeme znalost chování šumu na úrovni hradel a linearitu středních hodnot k aplikaci naučeného modelu šumu na větší obvod. V našem případě jsme vyšli z umělé znalosti, že ideální střední hodnota je . Bylo by ale velmi snadné vymyslet stav, u kterého teoreticky víme, že by to byla ideální hodnota, a pak použít skutečná měření ke kalibraci. Klíčové je, že u PEC se typicky nenaučí úplný model šumu celého obvodu. Místo toho se učí lokální modely šumu pro jednotlivá hradla nebo vrstvy obvodu a ty se použijí k sestavení kvazipravděpodobnostního rozkladu.
Pomocí těchto podmínek určíme a . Uvažujeme ansatz
and apply it to an arbitrary single-qubit density matrix .
Připomeňme, že Pauliho kanály působí konjugací:
Aplikací na dostaneme:
Vezmeme-li stopu, dostaneme:
Každý Pauliho operátor je unitární, takže konjugace zachovává stopu:
Therefore,
Aby byl odhadovač PEC normalizovaný, musí efektivní inverzní zobrazení zachovávat stopu všech matic hustoty. To znamená, že požadujeme:
Z toho plyne normalizační podmínka:
V našem případě to však dává podmínku:
Nyní použijeme kalibrační informace, abychom propojili pozorovanou střední hodnotu se známou ideální hodnotou.
Or equivalently,
Vyřešením našich dvou podmínek pro a dostaneme:
Tyto koeficienty se sčítají na 1, ale jeden z nich je záporný.
Ideální střední hodnotu můžeme obnovit tak, že obvod náhodně upravíme, změříme, výsledek vynásobíme znaménkovou vahou a zprůměrujeme. Zejména se nerekonstruují žádné matice hustoty a žádný inverzní kanál se fyzicky neimplementuje.
Klíčový krok: toto je PEC
Pro naši sílu šumu lze inverzní kanál zapsat jako:
Důležitá fakta:
-
Koeficienty se sčítají na 1
-
Jeden koeficient je záporný
-
Každý člen je fyzikálně implementovatelný
-
Zápornost se přesouvá do klasického následného zpracování
Ze absolutních hodnot vah vytvoříme vzorkovací rozdělení:
(pro každé z X, Y, Z)
Celková váha:
Pro pravděpodobnosti vzorkování vydělíme W.
| Operace | Pravděpodobnost | Znaménko |
|---|---|---|
| Nedělej nic () | 1.1875 / 1.375 ≈ 0.864 | + |
| Aplikuj X | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplikuj Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Aplikuj Z | 0.0625 / 1.375 ≈ 0.045 | - |
Znaménko pochází z původního koeficientu, nikoli z pravděpodobnosti.
Každý shot se skládá z těchto kroků:
-
Připrav stav
-
Nech hardware aplikovat zašuměný obvod
-
Náhodně vyber operaci z výše uvedené tabulky podle příslušných pravděpodobností
-
Apply it
-
Změř a získej
-
Vynásob výsledek hodnotou
-
Zaznamenej toto číslo
Nyní si ukážeme příklady několika shotů.
Shot 1 (případ identity)
Předpokládejme, že naše náhodně vybraná operace je identita (nebo ekvivalentně: nedělat nic). Podle argumentů a tabulky výše se to stane v 86.4 % případů. Protože koeficient u v inverzi šumového kanálu je kladný, zvolíme znaménko . Naše měření Z může snadno dát . Předpokládejme, že dá .
Příspěvek tohoto shotu opraveného pomocí PEC by byl:
Shot 2 (opět identita)
Předpokládejme, že jako náhodnou operaci opět dostaneme (takže znaménko členu je zpočátku stále ), ale tentokrát naše měření Z dá . Tentokrát je příspěvek:
Shot 3 (vybráno X)
Tentokrát je naše náhodná operace X. Tento člen v inverzi je záporný, takže ponecháme znaménko . Aplikujeme X a poté změříme Z. Opět můžeme dostat kteroukoli vlastní hodnotu; řekněme, že dostaneme . Příspěvek tohoto členu je:
Shot 4 (vybráno Z)
Náhodná operace je Z. Z tabulky tak dostaneme znaménko . Předpokládejme, že změříme Z a dostaneme . Příspěvek je:
Shot 5 (vybráno Y)
Náhodná operace je Y. Z tabulky tak dostaneme znaménko . Předpokládejme, že změříme Z a dostaneme . Příspěvek je:
Průměrování výsledků
Představ si, že shromáždíme mnoho takových výsledků vážených pomocí PEC:
Z konstrukce aplikujeme identitu v 86.4 % případů. Každé z ostatních hradel aplikujeme v 4.5 % případů. Ve skutečném pracovním postupu neznáme přesné podkladové stavy ani celý šumový kanál. Známe ale váhový faktor shora a relativní pravděpodobnost, s jakou každou operaci aplikujeme. Ve skutečném pracovním postupu se spoléháme na neznámou matici hustoty, která nám dává výsledky měření. Zde ověříme, že by tento postup vedl ke správným výsledkům.
Chceme spočítat průměr všech vážených měření se znaménky včetně aplikací Pauliho operátorů před měřením. Celkový počet všech shotů označme . Množinu všech shotů, u nichž byl aplikován Pauliho operátor , označme a pro indexování těchto shotů použijme . Výsledek měření -tého shotu při aplikaci -tého Pauliho operátoru označme . Tento průměr můžeme zapsat jako:
Pauliho operátor se aplikuje pravděpodobnostně s pravděpodobností . V limitě velkého počtu shotů platí
To můžeme využít k zápisu:
kde je střední hodnota Z pouze přes soubor shotů, v nichž byl aplikován . To je užitečné, protože z matice hustoty víme, jaká musí každá taková střední hodnota být. Ve skutečném pracovním postupu by to opět vzešlo z měření, nikoli ze známé matice hustoty.
Ověř si své porozumění
Ověř výše uvedené střední hodnoty výpočtem nebo logickou úvahou.
Odpověď
Y a Z probíhají úplně stejně jako výše.
Nyní můžeme celkovou střední hodnotu přepsat takto:
Pokud známe parametry a našeho šumu hradel (nebo více parametrů pro složitější šumové kanály), stačí to k určení (1) celkového váhového faktoru a (2) pravděpodobností, s nimiž máme aplikovat Pauliho operátory. Výše uvedený výsledek ukazuje, že tímto postupem šum zmírníme a získáme nezkreslené střední hodnoty. Průměr přes všechna tato měření konvergoval k , přestože:
-
Jednotlivá měření dávají příspěvky větší než ±1
-
Některá měření mají zápornou statistickou váhu
-
Každá kvantová operace byla fyzikální
Přehled pracovního postupu PEC
U PEC jsou všechny kroky na kvantovém počítači následující:
-
Učení šumu
-
Příprava stavu pro tvůj cílový obvod
-
Pravděpodobnostní aplikace Pauliho hradel, jak je popsáno výše
-
Measurement
Efektivní inverzní šumová mapa je realizována staticky v klasickém následném zpracování. To umožňuje obecnější inverzi šumových kanálů, která by jinak vyžadovala nefyzikální kroky, jako jsou záporné pravděpodobnosti.
Cenou, kterou za to platíme, je rozptyl. Každé měření mělo dříve „velikost“ rovnou velikostem možných výsledků měření . Po přeškálování váhovým faktorem má velikost (v našem příkladu výše 1.375).
To je původ režie vzorkování u PEC.
Vestavěné PEC
Nyní použijeme PEC tak, jak je zabudováno v primitivech IBM Quantum. Je zde zásadní rozlišovat mezi plnou PEC na úrovni hradel a lokálním modelem učení šumu pro škálovatelnější PEC, který používají primitiva IBM Quantum. Režie plné PEC by omezila její použití na malé obvody. To je v pořádku, ale užitečnější je mít nástroj, který se dá škálovat do velikosti, při níž se kvantové počítání stává cenným pro reálné problémy. Z tohoto důvodu primitiva IBM Quantum používají PEC po vrstvách s naučeným Pauli-Lindbladovým modelem šumu a s agresivními pojistkami škálovatelnosti. V této implementaci PEC se šum učí pro každou opakovanou vrstvu obvodu, nikoli pro každou instanci hradla, a model šumu je Pauli-twirlovaný, lokální a markovovský. Cliffordova hradla jsou pohlcena do modelu šumu, zatímco necliffordovská hradla dominují nákladům na zmírnění. Režie vzorkování je omezena shora, aby nedocházelo k exponenciálnímu nárůstu.
PEC zabudovanou v primitivech IBM Quantum použijeme ve dvou měřítcích: malém (šest qubitů) a středním (30 qubitů), abychom viděli, jak se v této verzi PEC udržují náklady pod kontrolou. V rámci každého experimentu také explicitně porovnáme výsledky PEC s výsledky bez zmírnění, se ZNE a s ideální hodnotou.
Začneme importem několika potřebných balíčků.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Zvolíme pozorovatelnou k odhadu. Pozorovatelná níže je hamiltonián řetězce isingovských spinů s interakcí nejbližších sousedů pouze ve složce a členem pro jeden qubit ve složce , jako by byl způsoben vnějším polem ve směru .
Pro výběr tohoto hamiltoniánu není žádný zvláštní důvod. Potřebujeme jen netriviální kombinaci pozorovatelné a obvodu, aby mohlo zmírňování chyb odvést svou práci. Hamiltonián explicitně škálujeme (pomocí koeficientů) a dělíme počtem qubitů, aby energie zůstala při zvyšování počtu qubitů ve stejném řádu. Začínáme jen se šesti.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Stejně jako u volby hamiltoniánu není ani obvod pro přípravu stavu níže zvolen z fyzikálních důvodů. Je zvolen tak, aby měl dostatečnou dvouqubitovou hloubku a dostatek necliffordovských hradel, aby PEC mohla být užitečná. Není důvod se domnívat, že tento obvod je například dobrou aproximací základního stavu tohoto řetězce spinů.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
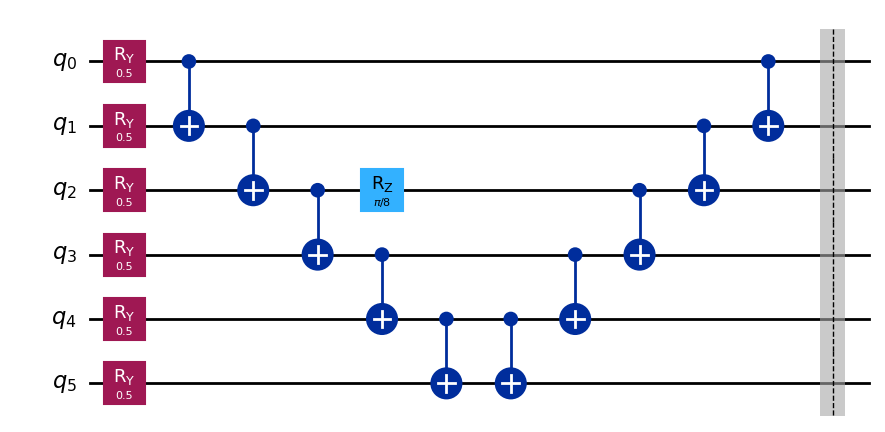
Obvod transpilujeme a výsledné rozložení aplikujeme na naše pozorovatelné.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Ideální střední hodnotu získáme pomocí simulátoru Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Očekáváme, že ostatní ideální hodnoty budou podobně velké. Nyní to spustíme na skutečném kvantovém počítači IBM bez zmírňování chyb.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Nyní na stejný problém aplikujeme ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Nakonec aplikujeme PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Níže výsledky vykreslíme a porovnáme.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
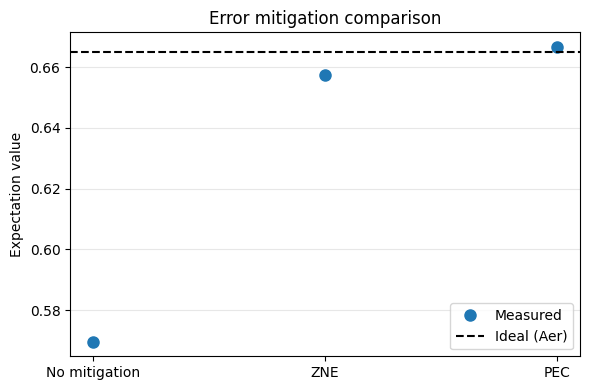
Fungovalo to velmi dobře. Náš odhad pomocí PEC se od ideální hodnoty liší jen o 0.2 %.
Pamatuj ale, že kvantová režie roste exponenciálně. Vynutili jsme maximální režii max_overhead = 100. Podle času a kvality výsledků to vypadá, že jsme tohoto maxima možná nedosáhli. Pokud však výpočet zvětšíme a necháme toto maximum beze změny, narazíme na něj a naše výsledky utrpí.
Můžeme se podívat, co se stane, když obvod zvětšíme na 30 qubitů. Zajímavé je, že na mnoha noteboocích začne simulátor Statevector přibližně při 24–28 qubitech končit na časovém limitu. Mohli bychom najít výpočetní způsoby, jak to obejít. Místo toho ale přijměme fakt, že kvantové počítače budou schopny řešit některé problémy v měřítku, se kterým klasické počítače nemohou držet krok. O to jde. Co tedy můžeme dělat pro ověření výsledků kvantového počítání v takových případech? Existuje několik možných odpovědí:
- Některé problémy je obtížné vyřešit, ale snadné ověřit (například rozklad na prvočinitele jako v Shorově algoritmu).
- Některé problémy mají parametrické režimy nebo varianty, které jsou méně složité a lze je řešit klasicky nebo dokonce analyticky, abychom porovnali několik bodů. V tomto případě jsme zvolili hamiltonián, který je intrinsický (dělili jsme počtem qubitů). Ideální střední hodnota by měla být poměrně stabilní. Podívejme se, jak se ideální střední hodnota mění s počtem qubitů, a zkusme udělat klasické předpovědi hodnoty pro 30 qubitů.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Skutečně vidíme, že jsme zvolili hamiltonián a stav, které se s počtem qubitů nemění. Pro výzkumné využití kvantového počítání je to velmi slabé, ale pro benchmarking technik zmírňování chyb výborné. Tuto pevnou střední hodnotu můžeme s jistotou použít jako ideální výsledek, i když při testování zmírňování chyb zvyšujeme počet qubitů.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Nyní tento větší obvod spustíme se ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Nakonec spustíme příklad s 30 qubity pomocí PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
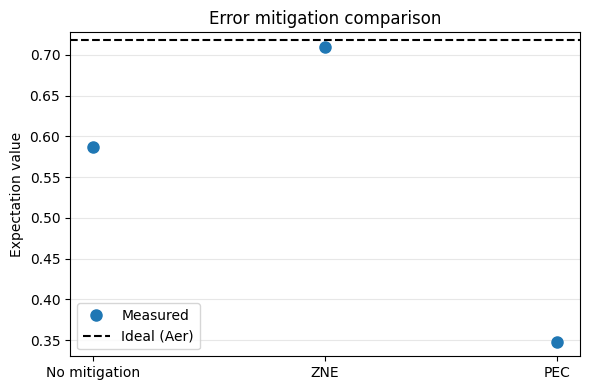
PEC netrvala jen mnohem déle než ostatní možnosti, ale také jsme jasně dosáhli prahu maximální režie. Výsledky PEC zaplatily cenu za režii, ale strop režie zabránil dostatečně přesnému vyrušení naučeného modelu šumu. To je zásadní. Při šesti qubitech jsme mohli PEC využít a získat lepší výsledky jen s mírným nárůstem kvantové režie (zhruba pětinásobným). Při 30 qubitech jsme zaplatili mnohem vyšší cenu (zhruba 60krát vyšší) a výsledky byly dokonce horší než nezmírněný odhad. Neznamená to, že PEC nemůže nikdy fungovat s 30 qubity; to může záviset na obvodu. Sdělení je jednoduše to, že exponenciální růst kvantové režie ztěžuje spouštění velkých obvodů.
Hlavní poznatky:
-
Zmírnění chyb měření často pomáhá a obvykle má nízkou režii: odstraňuje zkreslení, které neroste s hloubkou obvodu, a čistě se kombinuje téměř se vším.
-
Některé techniky nelze kombinovat. I když lze, dbej na to, abys je kombinoval konzistentně, aby jedna nerušila druhou. Dobrým příkladem je zajistit, aby bylo twirling zapnuté během kalibrace pro M3, pokud mají být tyto metody kombinovány.
-
PEC a ZNE je třeba chápat jako vzájemné alternativy. Řeší stejný problém s opačnými kompromisy:
-
PEC: poskytuje nezkreslené střední hodnoty za cenu exponenciálního rozptylu.
-
ZNE obvykle poskytuje zbytkové zkreslení, které závisí na extrapolačním modelu, ale za mírnou cenu.
-
-
DD může pomoci při dlouhých obdobích nečinnosti, ale mění tvar modelu šumu a může zneplatnit předpoklady extrapolace nebo inverze.
-
Pauli twirling šum nesnižuje. Mění jeho tvar a často umožňuje, aby jiné techniky (ZNE a PEC) fungovaly lépe.