Detekce chyb s nízkou režií pomocí prostoročasových kódů
Odhad využití: 4 minuty na procesoru Heron (ibm_kingston nebo ekvivalent) (POZNÁMKA: Toto je pouze odhad. Tvůj skutečný čas běhu se může lišit.)
Výstupy z učení
-
Jak prostoročasové Pauliho kontroly detekují logické chyby v Cliffordových obvodech a jak postselekce na jejich syndromech zvyšuje fidelitu vzorkovaného rozdělení.
-
Jak používat balíček
qiskit-paulicek automatickému nalezení a vložení hardwarově efektivních kontrol pomocíget_check_qubits,NoiseModelaadd_pauli_checks. -
Jak odhadnout fidelitu stabilizátorového stavu vzorkováním jeho stabilizátorů a postselekcí na syndromech kontrol.
-
Jak spustit celý workflow detekce chyb na hardwaru IBM Quantum® a porovnat zašuměné a postselektované fidelity.
Předpoklady
-
Základy hardwaru pro kvantové počítání v užitkovém měřítku.
-
Cliffordův a stabilizátorový formalismus, včetně toho, jak stabilizátorová grupa popisuje čistý stabilizátorový stav.
Pozadí
Low-overhead error detection with spacetime codes [1] od Simona Martiela a Aliho Javadi-Abhariho představuje metodu detekce logických chyb v obvodech s převahou Cliffordových operací, která se nachází mezi plnou korekcí chyb a lehčí mitigací chyb. Tato myšlenka staví na koherentních Pauliho kontrolách (CPC) z práce Single-shot error mitigation by coherent Pauli checks [2] od van den Berga a dalších. V obou přístupech je Cliffordův „payload“ obvod provázán s pomocnými qubity (ancilla), aby kontroloval určité invarianty. Měřením pomocných qubitů vznikne syndrom, který oznámí, zda byla během provádění detekována chyba. Ponecháním pouze vzorků bez detekované chyby se zlepší věrnost vzorkovaného rozdělení, a to za cenu snížené míry postselekce.
Klíčový rozdíl mezi koherentními Pauliho kontrolami a spacetime kontrolami spočívá v operátorech, které měří. Koherentní Pauliho kontroly měří časově lokalizované operátory s vysokou váhou. Na topologiích qubitů s omezenou konektivitou, jako je heavy hex, takové kontroly potřebují mnoho SWAP hradel a obvod se tak často stane příliš hlubokým na to, aby ho bylo možné v praxi spustit. Implementace kontrol jako spacetime kódů místo toho rozloží každou kontrolu napříč payload obvodem v prostoru i čase. To vede k hardwarově efektivnímu kódování, které zůstává účinné při detekci logických chyb, přičemž zachovává nízkou režii na qubity a hloubku.
Co dělá balíček qiskit-paulice
Balíček qiskit-paulice automatizuje konstrukci těchto kontrol, takže je nemusíš vytvářet ručně. Jeho hlavní úlohou je najít a vložit platné spacetime Pauliho kontroly na místa v obvodu, která maximalizují detekci chyb při minimalizaci režie na qubity. Kontrola je platná, pokud její operátory ponechávají logickou funkci payload obvodu nezměněnou, nízkovážená, pokud používá málo provazujících hradel, a účinná, pokud detekuje velkou část chyb vzhledem k šumu, který sama kontrola zavádí. Balíček hodnotí kandidátní kontroly podle modelu šumu a do obvodu zavede ty nejlepší. Tento tutoriál používá tři metody API:
-
get_check_qubitsprohlédne mapu propojení backendu a vrátí páry cílových a pomocných qubitů. Kontrola natarget_qubits[i]používáancilla_qubits[i]. -
NoiseModel.from_backendsestaví přibližný model šumu z benchmarkových dat backendu. Model hodnotí kandidátní kontroly, takže přesný, naučený model šumu není nutný. Naučený Pauli-Lindbladův model najdeš vNoiseModel.from_pauli_lindblad_maps. -
add_pauli_checksnajde a vloží kontroly do obvodu. Vrací posloupnost objektůCheckedCircuits rostoucím počtem kontrol a každý objekt poskytuje metoduget_postselection_method, která mapuje naměřený bitový řetězec na vektor syndromu. Argumentcostvybírá funkci, která kontrolu hodnotí (gamma, míra vzorkovací režie postselektovaného inverzního šumového kanálu, neboLER, míra logické chybovosti). Argumentmethodvybírá strategii vyhledávání (windowed,geneticnebowindowed_genetic). Tento tutoriál používácost="gamma"amethod="windowed", což společně dává deterministický, reprodukovatelný výběr kontrol.
Odhad věrnosti ze stabilizátorového vzorkování
Abys změřil, jak dobře detekce chyb funguje, můžeš odhadnout věrnost stabilizátorového stavu , který obvod ideálně připravuje, vůči zašuměnému stavu , který hardware skutečně produkuje. Projektor na čistý stabilizátorový stav se rovná rovnoměrnému průměru přes prvků jeho stabilizátorové grupy :
Dosazením do věrnosti získáme věrnost jako průměrnou střední hodnotu každého stabilizátoru vzhledem k :
U větších problémů je vyčíslení všech stabilizátorů neproveditelné, takže věrnost můžeš odhadnout z náhodného vzorku. Vylosováním stabilizátorů rovnoměrně náhodně z dostaneme nezkreslený odhad:
Protože Cliffordův obvod připravuje stabilizátorový stav, můžeš jeho věrnost odhadnout přímo ze vzorkovaných středních hodnot jeho stabilizátorů. Tento tutoriál nejprve projde postup na simulátoru s malým obvodem, poté spustí stejný postup na hardwaru s větším a hlubším obvodem. S tím, jak obvody obsahují více non-Cliffordových operací, se počet platných kontrol rychle zmenšuje, takže tato metoda funguje nejlépe pro obvody s převahou Cliffordových operací.
Požadavky
Než začneš s tímto tutoriálem, ujisti se, že máš nainstalováno následující:
-
Qiskit SDK v2.0 nebo novější, s podporou vizualizace
-
Qiskit Runtime v0.40 nebo novější (
pip install qiskit-ibm-runtime) -
Qiskit Aer v0.17 nebo novější (
pip install qiskit-aer) -
Qiskit Paulice (
pip install qiskit-paulice) -
tqdm (
pip install tqdm)
Nastavení
Naimportuj potřebné knihovny a definuj pomocné funkce, které nejsou dostupné jako importy. Funkce random_clifford_circuit sestaví brickworkový náhodný Cliffordův payload, find_check_layout prohledá mapu propojení backendu a najde cestu qubitů s nízkou chybovostí a mnoha dostupnými pomocnými qubity, learned_noise_model převede výstup NoiseLearner na model šumu qiskit-paulice, append_basis_rotation otočí obvod tak, aby byl stabilizátor měřen ve výpočetní bázi, expectation vypočítá střední hodnotu stabilizátoru z naměřených výsledků a cum_mean_sem sleduje průběžný odhad věrnosti.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime qiskit-paulice tqdm
# Standard library imports
import random
import time

# External libraries
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

# Qiskit
from qiskit import QuantumCircuit
from qiskit.quantum_info import Clifford, Pauli, PauliLindbladMap, PauliList
from qiskit.result import sampled_expectation_value
from qiskit.transpiler import generate_preset_pass_manager
from qiskit.visualization import plot_coupling_map

# Qiskit Aer
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel as AerNoiseModel
from qiskit_aer.noise import ReadoutError, depolarizing_error

# Qiskit IBM Runtime
from qiskit_ibm_runtime import NoiseLearner, QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler

# Qiskit Paulice
from qiskit_paulice import add_pauli_checks
from qiskit_paulice.layout import get_check_qubits
from qiskit_paulice.noise_models import NoiseModel
def random_clifford_circuit(
    num_qubits: int, depth: int, rng: np.random.Generator
) -> QuantumCircuit:
    """Brickwork random Clifford on `num_qubits`, with `depth` CZ layers."""
    qc = QuantumCircuit(num_qubits)
    qc.h(range(num_qubits))
    for d in range(depth):
        for i in range(d % 2, num_qubits - 1, 2):
            qc.cz(i, i + 1)
        for q in range(num_qubits):
            if rng.integers(0, 2):
                qc.sx(q)
            if rng.integers(0, 2):
                qc.s(q)
            if rng.integers(0, 2):
                qc.sx(q)
    return qc

def find_check_layout(
    backend,
    num_qubits: int,
    rng: np.random.Generator,
    num_trials: int = 200,
    max_gate_error: float = 0.03,
    max_readout_error: float = 0.2,
) -> list[int]:
    """Find a low-error path of `num_qubits` qubits with many available ancillas.

    Builds random self-avoiding walks on the coupling map, excluding the qubits
    and two-qubit gates whose reported errors exceed the thresholds, and keeps
    the path that offers the most target and ancilla pairs. Ties are broken by
    the lower average two-qubit gate error along the path.
    """
    target = backend.target
    gate_2q = next(
        name for name in ("cz", "ecr", "cx") if name in target.operation_names
    )

    # Collect per-edge gate errors and per-qubit readout errors
    edge_error = {}
    for qubits, props in target[gate_2q].items():
        edge = tuple(sorted(qubits))
        if props is not None and props.error is not None:
            edge_error[edge] = min(edge_error.get(edge, 1.0), props.error)
    readout_error = {
        qubit: target["measure"][(qubit,)].error
        for (qubit,) in target["measure"]
    }

    # Keep only the edges whose gate and readout errors are acceptable
    adjacency = {}
    for (q1, q2), error in edge_error.items():
        if (
            error <= max_gate_error
            and readout_error.get(q1, 1.0) <= max_readout_error
            and readout_error.get(q2, 1.0) <= max_readout_error
        ):
            adjacency.setdefault(q1, set()).add(q2)
            adjacency.setdefault(q2, set()).add(q1)

    # Random self-avoiding walks; keep the path with the most check pairs
    starts = sorted(adjacency)
    best_path = None
    best_score = (-1, float("inf"))
    for _ in range(num_trials):
        path = [starts[rng.integers(len(starts))]]
        while len(path) < num_qubits:
            options = sorted(adjacency[path[-1]] - set(path))
            if not options:
                break
            path.append(options[rng.integers(len(options))])
        if len(path) < num_qubits:
            continue
        num_pairs = len(get_check_qubits(backend.coupling_map, path)[0])
        mean_error = float(
            np.mean(
                [edge_error[tuple(sorted(e))] for e in zip(path, path[1:])]
            )
        )
        if num_pairs > best_score[0] or (
            num_pairs == best_score[0] and mean_error < best_score[1]
        ):
            best_path, best_score = path, (num_pairs, mean_error)

    if best_path is None:
        raise RuntimeError(
            "No connected low-error path found. Relax the error thresholds."
        )
    return best_path

def learned_noise_model(layer_errors, layout: list[int]) -> NoiseModel:
    """Build a `NoiseModel` from `NoiseLearner` results.

    `NoiseLearner` reports one `PauliLindbladError` per entangling layer, whose
    generators are indexed against that layer's own physical qubits, while
    `NoiseModel.from_pauli_lindblad_maps` expects `PauliLindbladMap`s indexed the
    way `NoiseModel.from_backend` indexes them: by position in `layout`. This
    translates between the two and drops generators that fall outside `layout`.
    """
    phys_to_virt = {phys: virt for virt, phys in enumerate(layout)}
    maps = []
    for layer in layer_errors:
        if layer.error is None:
            continue
        terms = []
        for pauli, rate in zip(
            layer.error.generators, layer.error.rates, strict=True
        ):
            label, indices = [], []
            for local, phys in enumerate(layer.qubits):
                x, z = bool(pauli.x[local]), bool(pauli.z[local])
                if not (x or z):
                    continue
                if phys not in phys_to_virt:
                    break  # generator reaches outside the layout, so skip it
                label.append("Y" if x and z else "X" if x else "Z")
                indices.append(phys_to_virt[phys])
            else:
                if label:
                    terms.append(
                        ("".join(label), tuple(indices), float(rate))
                    )
        # Each map needs a 2-qubit generator to define an entangling layer
        if any(len(t[1]) == 2 for t in terms):
            maps.append(
                PauliLindbladMap.from_sparse_list(
                    terms, num_qubits=len(layout)
                )
            )
    if not maps:
        raise RuntimeError(
            "No usable layer errors. Check that the learner ran on this layout."
        )
    return NoiseModel.from_pauli_lindblad_maps(maps)

def append_basis_rotation(
    circuit: QuantumCircuit, pauli: Pauli
) -> QuantumCircuit:
    """Strip measurements, append basis rotations for `pauli`, and re-measure."""
    out = circuit.remove_final_measurements(inplace=False)
    for q in range(pauli.num_qubits):
        if pauli.x[q]:
            if pauli.z[q]:
                out.sdg(q)
            out.h(q)
    out.measure_all()
    return out

def expectation(counts: dict, pauli: Pauli) -> float:
    """Expectation value of `pauli` from counts measured in the Z basis.

    Pads with identity on any qubits beyond the support of `pauli`, such as the
    check ancillas that appear in the postselected counts.
    """
    if not counts:
        return float("nan")
    n = pauli.num_qubits
    sign = -1 if int(pauli.phase) % 4 == 2 else 1
    total = len(next(iter(counts)))
    label = "".join(
        "Z" if q < n and (pauli.x[q] or pauli.z[q]) else "I"
        for q in range(total - 1, -1, -1)
    )
    return sign * sampled_expectation_value(counts, label)

def cum_mean_sem(values: np.ndarray):
    """Cumulative mean and standard error of the mean, ignoring NaNs."""
    valid = ~np.isnan(values)
    total = np.cumsum(np.where(valid, values, 0.0))
    total_sq = np.cumsum(np.where(valid, values**2, 0.0))
    count = np.maximum(np.cumsum(valid).astype(float), 1)
    mean = total / count
    sem = np.sqrt(np.maximum(total_sq / count - mean**2, 0) / count)
    return np.where(np.cumsum(valid) > 0, mean, np.nan), sem
Příklad na malém simulátoru
Tato sekce projde celý postup na zašuměném simulátoru. Používá benchmarková data backendu k výběru rozložení qubitů a modelu šumu, automaticky nachází kontroly a používá postselekci na vzorkovaném rozdělení k prokázání zlepšení věrnosti.
Krok 1: Mapování klasických vstupů na kvantový problém
Payload obvod je mělký jednorozměrný brickworkový náhodný Cliffordův obvod. Protože je obvod Cliffordův, připravuje stabilizátorový stav, jehož věrnost můžeš odhadnout přímo ze vzorkovaných středních hodnot stabilizátorů. Začni mělkým obvodem, aby bylo možné kontroly v dalším kroku snadno vizualizovat.
num_qubits = 12
depth = 4
seed = 1764
rng = np.random.default_rng(seed)
np.random.seed(seed)

circuit = random_clifford_circuit(num_qubits, depth, rng)
circuit.measure_all()
circuit.draw("mpl", fold=-1, scale=0.6)

Krok 2: Optimalizace pro spuštění na kvantovém hardwaru
Mapování obvodu na hardware nastaví fyzické rozložení qubitů, model šumu, který hodnotí kandidátní kontroly, a samotné kontroly.
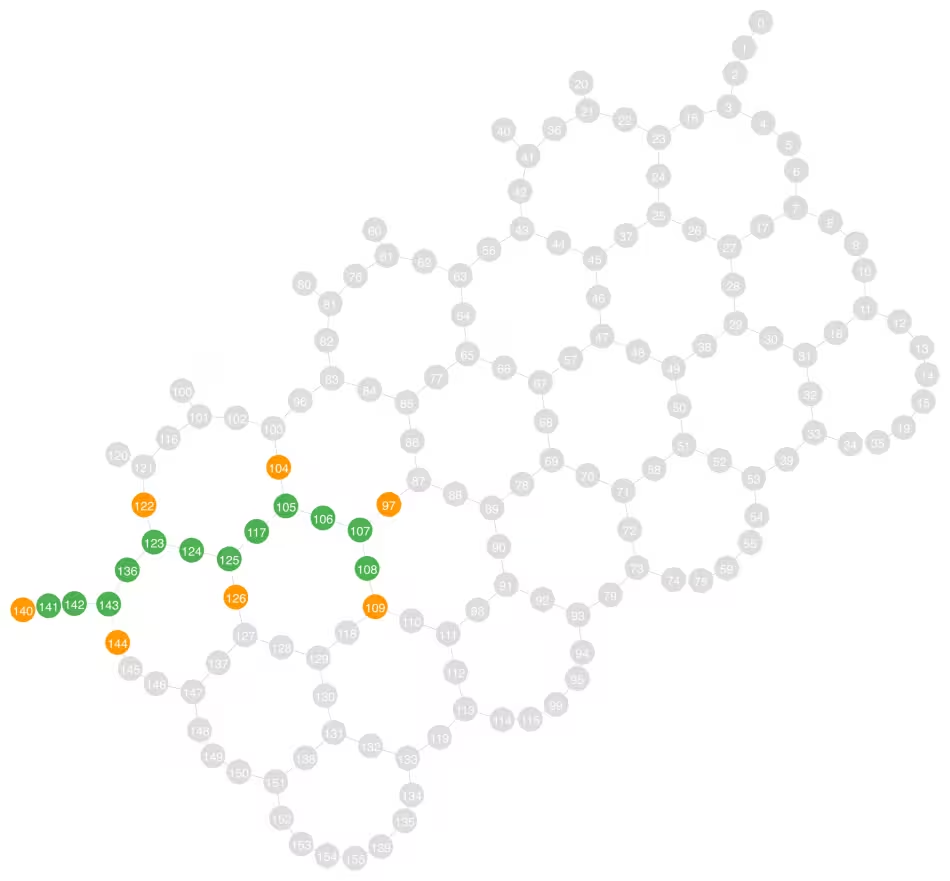
Nejprve vyber backend a prohledej jeho mapu propojení pro jednorozměrné rozložení qubitů pomocí pomocné funkce find_check_layout definované v sekci Nastavení. Tato pomocná funkce sestaví náhodné vlastní vyhýbavé procházky, které se vyhýbají hradlům a čtením s nejvyšší chybovostí, a ponechá tu cestu, která nabízí nejvíce párů cílových a pomocných qubitů. Protože vyhledávání čte konektivitu a data o chybovosti přímo z backendu, stejný kód poběží na jakémkoli QPU IBM Quantum. Funkce get_check_qubits pak vrátí páry cílových a pomocných qubitů, přičemž kontrola na target_qubits[i] používá ancilla_qubits[i].
V grafu propojení, který následuje, jsou zelené qubity payload qubity a oranžové qubity jsou pomocné qubity, které implementují kontroly. Qubity se sousedním pomocným qubitem jsou používány jako cílové qubity pro kontroly.
service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)

print(f"Backend: {backend.name}")

# Search for a low-error path, then pair each target qubit with a neighboring ancilla
layout = find_check_layout(backend, num_qubits, rng)
target_qubits, ancilla_qubits = get_check_qubits(backend, layout)
num_checks = len(target_qubits)

print(f"Target qubits:  {target_qubits}")
print(f"Ancilla qubits: {ancilla_qubits}")
plot_coupling_map(
    num_qubits=backend.num_qubits,
    qubit_coordinates=getattr(
        backend.configuration(), "qubit_coordinates", None
    ),
    coupling_map=backend.configuration().coupling_map,
    figsize=(12, 12),
    qubit_color=[
        "#4CAF50"
        if i in set(layout)
        else "#FF9800"
        if i in set(ancilla_qubits)
        else "#DDDDDD"
        for i in backend.coupling_map.graph.node_indices()
    ],
    qubit_size=220,
    line_width=2,
    font_size=90,
)
Backend: ibm_boston
Target qubits:  [105, 107, 108, 123, 125, 141, 143]
Ancilla qubits: [104, 97, 109, 122, 126, 140, 144]
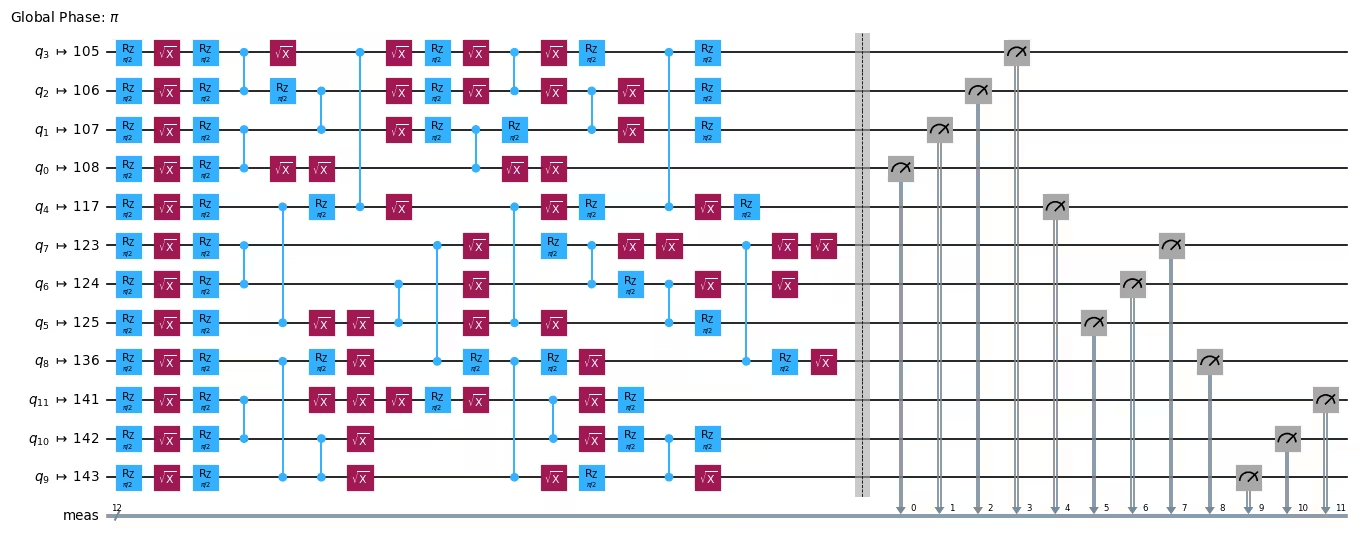
S vybraným backendem a rozložením zkompiluj payload do obvodu podle architektury instrukční sady (ISA). Je nutné pouze nastavit rozložení a přeložit hradla do nativní sady hradel backendu.
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=layout
)
circuit_isa = pm.run(circuit)
circuit_isa.draw("mpl", fold=-1, scale=0.6)
Dále namodeluj, jak šum hradel a čtení na backendu ovlivňuje provádění. Model šumu určuje, kde v obvodu kontrola zachytí nejvíce chyb. Přesnější model zlepšuje detekci, ale obvykle není nutné jej naučit vzorkováním QPU. Následující model odvozuje z benchmarkových dat qiskit-ibm-runtime jednotný depolarizační kanál pro šum hradel a čtení.
noise_model = NoiseModel.from_backend(
    backend, layout, uniform_gate_noise=True
)
print(noise_model)
NoiseModel(gate_noise=0.001079865281450939, readout_noise=0.006001790364583333, idling_noise=None)
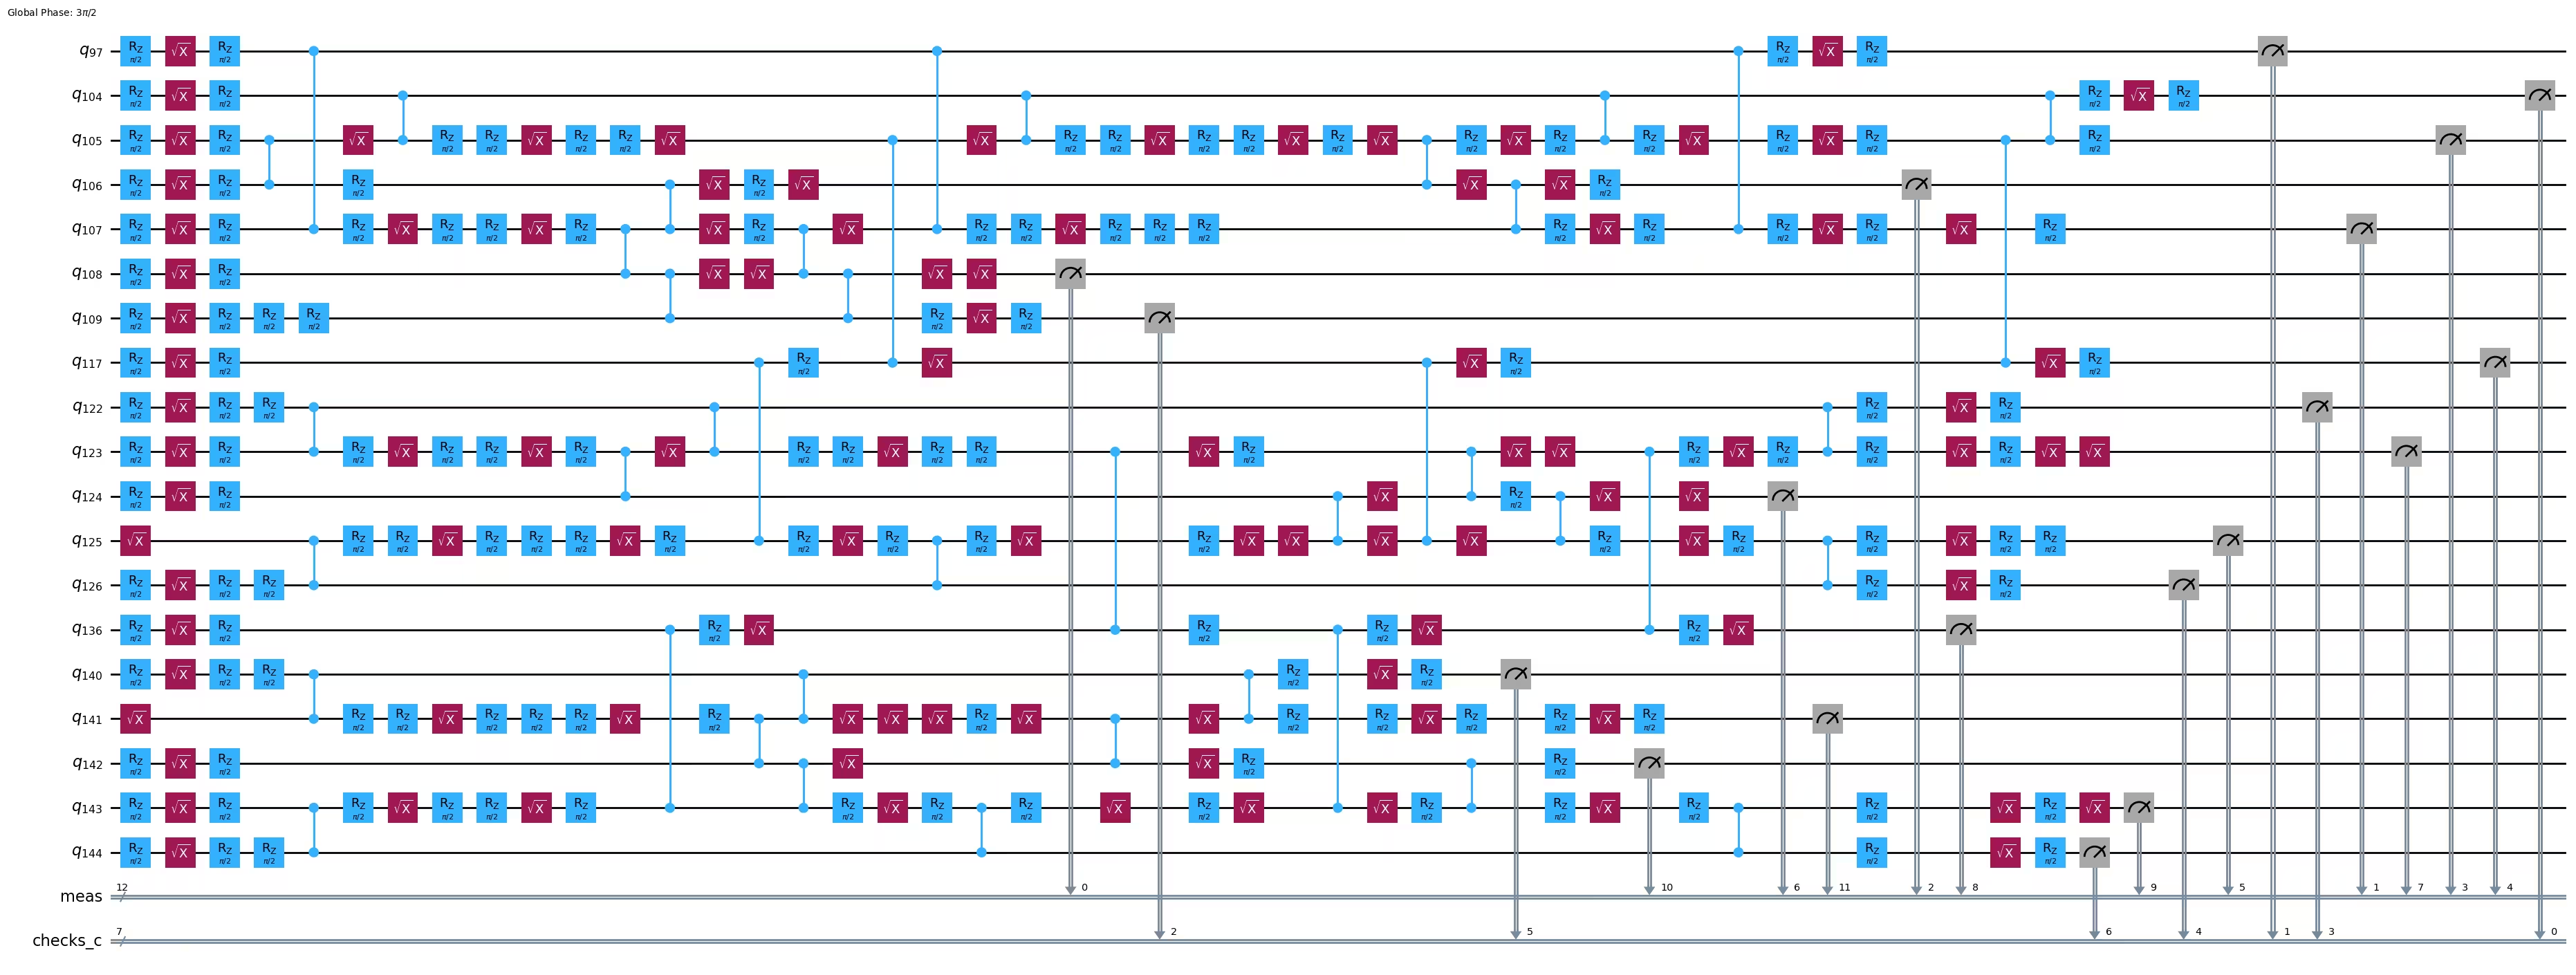
Nyní přidej kontroly do obvodu. Funkce add_pauli_checks bere jako vstup Cliffordův payload, seznam cílových qubitů a model šumu. Argument ancilla_qubits říká funkci, který fyzický pomocný qubit spárovat s každým cílem. Kontroly se přidávají v pořadí, v jakém se objevují cílové qubity, takže konečné rozložení kontrolovaného obvodu je layout + ancilla_qubits. Pro spuštění výstupního obvodu s méně (i) kontrolami je konečné rozložení layout + ancilla_qubits[:i].
Výstupem add_pauli_checks je posloupnost obvodů s rostoucím počtem kontrol, od žádné kontroly až po jednu kontrolu na každém cílovém qubitu. Vizualizace potvrzuje, že kontroly používají zadané páry cílových a pomocných qubitů. Podrobnosti o hledání dobrých kontrol najdeš v sekcích II až IV doplňujících informací v referenci [1].
checked = add_pauli_checks(
    circuit_isa,
    target_qubits,
    noise_model,
    ancilla_qubits=ancilla_qubits,
    cost="gamma",
    method="windowed",
    seed=seed,
)

print(f"Physical layout of payload and ancillas: {layout + ancilla_qubits}")
print("Checked circuit:")
checked[-1].circuit.draw("mpl", fold=-1, idle_wires=False)
Physical layout of payload and ancillas: [108, 107, 106, 105, 117, 125, 124, 123, 136, 143, 142, 141, 104, 97, 109, 122, 126, 140, 144]
Checked circuit:
Krok 3: Spuštění pomocí Qiskit primitiv
Aby byl efekt šumu hradel viditelný, zvyš hloubku payloadu a vzorkuj podmnožinu jeho stabilizátorů. Každý stabilizátor obecně není qubit-wise komutující s ostatními, takže jedna sada kontrol není platná pro dva různé stabilizátory. Namísto seskupování stabilizátorů do komutujících množin najdi dobrou sadu kontrol pro každý stabilizátor nezávisle. Vzorkování stabilizátorů rovnoměrně náhodně dává nezkreslený odhad věrnosti.
Sestav hlubší obvod a vylosuj náhodný vzorek jeho stabilizátorů.
depth = 24
num_stabilizers = 20
num_shots = 1_000

circuit = random_clifford_circuit(num_qubits, depth, rng)

# Build the full stabilizer group, then sample from it uniformly at random
circ_no_meas = circuit.remove_final_measurements(inplace=False)
stabilizer_group = PauliList([Pauli("I" * num_qubits)])
for generator in (
    Pauli(label) for label in Clifford(circ_no_meas).to_labels(mode="S")
):
    stabilizer_group = stabilizer_group + stabilizer_group.compose(generator)

keep = np.where(
    stabilizer_group.x.any(axis=1) | stabilizer_group.z.any(axis=1)
)[0]
chosen = np.random.default_rng(seed).choice(
    keep, size=min(num_stabilizers, len(keep)), replace=False
)
stabilizers = [stabilizer_group[int(i)] for i in chosen]

two_qubit_depth = circuit.depth(lambda x: x.operation.num_qubits == 2)
print(
    f"Sampled {len(stabilizers)} stabilizers of a {circuit.num_qubits}-qubit "
    f"circuit with two-qubit depth {two_qubit_depth}: "
    f"{{{stabilizers[0]}, {stabilizers[1]}, ...}}"
)
Sampled 20 stabilizers of a 12-qubit circuit with two-qubit depth 24: {ZXIIXZYYXIZZ, XXXYIIZYXIII, ...}
Pro každý vzorkovaný stabilizátor otoč obvod tak, aby byl stabilizátor měřen ve výpočetní bázi, zkompiluj ho na backend a najdi dobrou sadu kontrol. Páry cílových a pomocných qubitů jsou pro každý stabilizátor prohozeny společně, takže si každý cíl zachová svůj pomocný qubit. Pamatuj, že kontroly se zavádějí postupně v pořadí, v jakém jsou zadány cílové qubity, a zavedená kontrola se s přidáváním dalších kontrol nemění.
noisy_circuits = []
checked_circuits = []
depths_2q = []
t0 = time.time()
for i, pauli in enumerate(tqdm(stabilizers)):
    noisy_circuits.append(pm.run(append_basis_rotation(circuit, pauli)))
    # Shuffle target and ancilla pairs together so each target keeps its ancilla
    targets, ancillas = zip(
        *random.sample(
            list(zip(target_qubits, ancilla_qubits, strict=True)),
            k=len(target_qubits),
        ),
        strict=True,
    )
    checked_circuits.append(
        add_pauli_checks(
            noisy_circuits[-1],
            list(targets),
            noise_model,
            ancilla_qubits=list(ancillas),
            cost="gamma",
            method="windowed",
            seed=seed + 1 + i,
        )
    )
    depths_2q.append(
        checked_circuits[-1][-1].circuit.depth(lambda x: len(x.qubits) == 2)
    )

print(
    f"Added {num_checks} checks to {len(stabilizers)} circuits "
    f"in {(time.time() - t0):.0f}s."
)
print(
    f"On average, two-qubit depth increased from "
    f"{circuit.depth(lambda x: len(x.qubits) == 2)} to {int(np.mean(depths_2q))} "
    f"when adding {num_checks} checks."
)
100%|██████████| 20/20 [00:15<00:00, 1.29it/s]
Added 7 checks to 20 circuits in 15s.
On average, two-qubit depth increased from 24 to 33 when adding 7 checks.
Vzorkuj holý payload a kontrolované obvody pomocí Qiskit Aer. Simulátor používá stejný depolarizační model, podle kterého byly kontroly hodnoceny, takže šum, na který kontroly cílí, je stejný šum, jaký simulátor aplikuje.
aer_nm = AerNoiseModel()
aer_nm.add_all_qubit_quantum_error(
    depolarizing_error(noise_model.gate_noise, 2), ["cz"]
)
p = noise_model.readout_noise
aer_nm.add_all_qubit_readout_error(ReadoutError([[1 - p, p], [p, 1 - p]]))
noisy_sim = AerSimulator(method="stabilizer", noise_model=aer_nm)

counts = []
for i, checked_circ_result in enumerate(tqdm(checked_circuits)):
    noisy_counts = (
        noisy_sim.run(
            noisy_circuits[i], shots=num_shots, seed_simulator=seed * i + 1
        )
        .result()
        .get_counts()
    )
    checked_counts_per_variant = []
    for k, ck in enumerate(checked_circ_result):
        variant_counts = (
            noisy_sim.run(
                ck.circuit, shots=num_shots, seed_simulator=seed * i + 2 + k
            )
            .result()
            .get_counts()
        )
        checked_counts_per_variant.append(variant_counts)
    counts.append((noisy_counts, checked_counts_per_variant))
100%|██████████| 20/20 [00:17<00:00, 1.13it/s]
Krok 4: Zpracování a vrácení výsledku v požadovaném klasickém formátu
Každá kontrola používá provazující hradla mezi jedním pomocným a jedním cílovým qubitem. Pomocný qubit začíná ve stavu , takže stabilizuje jeho vstup. Propagací dopředu kontrolovaným obvodem vznikne na výstupu Pauliho operátor, jehož neidentické členy definují podporu kontroly. Kontrola projde, pokud bity v její podpoře mají sudou paritu. Vzorek je ponechán pouze tehdy, když projdou všechny kontroly.
get_postselection_method každého CheckedCircuit vrací funkci, která mapuje naměřený bitový řetězec na vektor syndromu. Ponechej vzorky, jejichž syndrom je pro každou kontrolu nulový, a zbytek zahoď. Následující graf ukazuje, že přidávání dalších kontrol snižuje míru postselekce. Nižší míra postselekce vyžaduje více výstřelů (shots) k dosažení cílové přesnosti, takže existuje kompromis mezi schopností detekce a náklady na vzorkování. Zdá se, že míra konverguje, což naznačuje, že další kontroly přispívají menší schopností detekce.
rate_per_variant = []
kept_per_stab = []
for i, (_, checked_counts_per_variant) in enumerate(counts):
    rates = []
    kept_at_num_checks = None
    for k, variant_counts in enumerate(checked_counts_per_variant):
        ps_fn = checked_circuits[i][k].get_postselection_method()
        kept = {
            bs: n for bs, n in variant_counts.items() if not ps_fn(bs).any()
        }
        rates.append(sum(kept.values()) / num_shots)
        if k == num_checks:
            kept_at_num_checks = kept
    rate_per_variant.append(rates)
    kept_per_stab.append(kept_at_num_checks)

max_len = max(len(s) for s in rate_per_variant)
rates_arr = np.full((len(rate_per_variant), max_len), np.nan)
for i, s in enumerate(rate_per_variant):
    rates_arr[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, rates_arr.T, color="#ff8c00", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(rates_arr, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Postselection rate")
ax.set_ylim((0, 1.05))
ax.set_title(
    f"Per-stabilizer postselection rate ({len(rates_arr)} stabilizers)"
)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

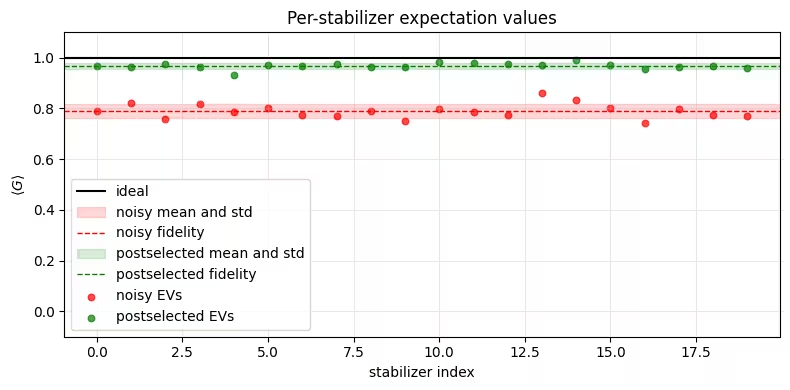
Nyní porovnej věrnost holého zašuměného stavu s postselektovaným stavem. Postselekce pouze vzorků bez detekované chyby zvyšuje střední hodnotu každého stabilizátoru, a tedy i odhadovanou věrnost. Postselektované hodnoty využívají méně vzorků než hodnoty surové, přesto jsou střední hodnoty přesnější a vzorkovaný rozptyl je nižší. Všimni si také, že průměrná míra postselekce je blízká zašuměné věrnosti. To je to, co bys očekával, pokud kontroly detekují téměř všechny chybné vzorky: podíl vzorků, které projdou všemi kontrolami, se blíží podílu bezchybných vzorků, což je věrnost zašuměného stavu.
results = []
for i, ((noisy_counts, _), kept) in enumerate(
    zip(counts, kept_per_stab, strict=True)
):
    results.append(
        (
            expectation(noisy_counts, stabilizers[i]),
            expectation(kept, stabilizers[i]),
            sum(kept.values()) / num_shots,
        )
    )

fidelity_noisy = float(np.nanmean([r[0] for r in results]))
fidelity_postsel = float(np.nanmean([r[1] for r in results]))
psr = float(np.mean([r[2] for r in results]))
print(
    f"ideal fidelity:          1.0\n"
    f"noisy fidelity:          {fidelity_noisy:.4f}\n"
    f"postselected fidelity:   {fidelity_postsel:.4f}\n"
    f"mean postselection rate: {psr:.3f}"
)

evs_ideal = np.ones(len(results))
evs_noisy = np.array([r[0] for r in results])
evs_post = np.array([r[1] for r in results])
idx = np.arange(len(results))

def strip(ax, ys, color, label):
    m, s = np.nanmean(ys), np.nanstd(ys)
    ax.axhspan(
        m - s, m + s, color=color, alpha=0.15, label=f"{label} mean and std"
    )
    ax.axhline(
        m, color=color, linewidth=1, linestyle="--", label=f"{label} fidelity"
    )

fig, ax = plt.subplots(figsize=(8, 4))
ax.axhline(np.nanmean(evs_ideal), color="black", linewidth=1.5, label="ideal")
strip(ax, evs_noisy, "red", "noisy")
strip(ax, evs_post, "green", "postselected")
ax.scatter(idx, evs_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    evs_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_title("Per-stabilizer expectation values")
ax.legend(loc="lower left")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

M = np.arange(1, len(results) + 1)
fig, ax = plt.subplots(figsize=(8, 4))
for ys, color, label in [
    (evs_ideal, "black", "ideal"),
    (evs_noisy, "red", "noisy"),
    (evs_post, "green", "postselected"),
]:
    cm, sem = cum_mean_sem(ys)
    ax.plot(M, cm, color=color, linewidth=1.5, label=label)
    ax.fill_between(M, cm - sem, cm + sem, color=color, alpha=0.15)
ax.set_xlabel("number of stabilizers averaged")
ax.set_ylabel("running fidelity estimate")
ax.set_title("Fidelity convergence versus number of stabilizers")
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ideal fidelity:          1.0
noisy fidelity:          0.7899
postselected fidelity:   0.9679
mean postselection rate: 0.780

Skóre gamma udává, kolik z modelovaného šumového kanálu zůstává kontrolami neodhaleno. Vykreslení skóre gamma v závislosti na počtu zavedených kontrol ukazuje, jak se schopnost detekce zlepšuje s přidáváním každé kontroly. Hodnota 1.0 znamená, že kontroly zachycují veškerý modelovaný šum. Křivky klesají směrem k 1.0 s přibývajícími zavedenými kontrolami, což ukazuje, že každá další kontrola zachytí část zbývající neodhalené chyby.
stab_scores = [
    [variant.cost for variant in checked_circ_result]
    for checked_circ_result in checked_circuits
]
max_len = max(len(s) for s in stab_scores)
scores = np.full((len(stab_scores), max_len), np.nan)
for i, s in enumerate(stab_scores):
    scores[i, : len(s)] = s
ks = np.arange(max_len)

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(ks, scores.T, color="#4682b4", alpha=0.15, linewidth=1)
ax.plot(
    ks,
    np.nanmedian(scores, axis=0),
    color="black",
    linewidth=1,
    linestyle="--",
    label="median",
)
ax.set_xlabel("Checks committed")
ax.set_ylabel("Gamma")
ax.set_yscale("log")
ax.set_title(f"Per-stabilizer gamma curves ({len(scores)} stabilizers)")
ax.legend()
ax.grid(True, alpha=0.3, which="both")
plt.tight_layout()
plt.show()

Příklad na rozsáhlém hardwaru
Stejný postup běží na hardwaru s větším a hlubším payloadem. Tato sekce znovu použije backend z příkladu se simulátorem, ale sestaví nové rozložení s 20 qubity s vlastními páry cílových a pomocných qubitů a vlastním pass managerem, poté odešle obvody na QPU v jediné úloze. Při této velikosti spustí většina výstřelů alespoň jednu kontrolu, takže míra postselekce je nízká a každý obvod potřebuje velký rozpočet výstřelů, aby přežilo dostatek vzorků. Příklad proto soustředí svůj rozpočet na několik vzorkovaných stabilizátorů; stále se jedná o nezkreslený odhad věrnosti, ale je hrubší než průměr přes mnoho stabilizátorů v příkladu se simulátorem.
Jedna věc se oproti příkladu se simulátorem mění: namísto odvození jednotného depolarizačního kanálu z kalibračních dat tato sekce naučí model šumu pomocí NoiseLearner a sestaví model qiskit-paulice z výsledku pomocí NoiseModel.from_pauli_lindblad_maps. Naučený Pauli-Lindbladův model zachycuje prostorovou strukturu šumu na tomto konkrétním rozložení, namísto předpokladu, že každá hrana je stejně zašuměná, takže umístění kontrol je hodnoceno vůči šumu, který se více podobá tomu, jenž ovlivňuje QPU. Naučení šumu vyžaduje vzorkování QPU a mělo by být zahrnuto do celkového rozpočtu vzorkování QPU.
Následující parametry nastavují počet qubitů, hloubku, počet stabilizátorů a počet výstřelů. Škáluj hw_num_shots s převrácenou hodnotou míry postselekce: při míře 3 % ponechá 40 000 výstřelů zhruba 1 200 postselektovaných vzorků na obvod. Zvyš hw_num_stabilizers pro přesnější odhad věrnosti za cenu více obvodů na úlohu, z nichž každý potřebuje stejný rozpočet výstřelů.
Kroky 1-4 (sloučené do jednoho bloku kódu)
Následující buňka provádí stejné čtyři kroky jako příklad se simulátorem. Sestaví větší payload a vzorkuje několik stabilizátorů (krok 1); zvolí rozložení, naučí na něm model šumu a najde plně kontrolovaný obvod pro každý stabilizátor (krok 2); odešle jednu úlohu Sampler, která obsahuje jak holé, tak kontrolované obvody (krok 3); a provede postselekci kontrolovaných výsledků, aby porovnala zašuměný a postselektovaný odhad věrnosti, pro každý stabilizátor i v průměru (krok 4). Při této velikosti je vyčíslení celé stabilizátorové grupy jako v příkladu se simulátorem neproveditelné, takže buňka vybere náhodnou podmnožinu stabilizátorů pro výpočet odhadu věrnosti.
Všimni si, že krok 2 zde dělá více než v příkladu se simulátorem: naučení modelu šumu odešle vlastní úlohu NoiseLearner ještě před úlohou Sampler, takže buňka celkem spustí dvě úlohy. Nesou štítky TUT_ASPC_LEARN a TUT_ASPC, abys je později mohl najít. Více o označování úloh najdeš v Organizace a vyhledávání podle štítků úloh.
# -------------------------Step 1: build a larger payload and sample stabilizers-------------------------
hw_num_qubits = 20
hw_depth = 36
hw_num_stabilizers = 10
hw_num_shots = 40_000

hw_circuit = random_clifford_circuit(hw_num_qubits, hw_depth, rng)
hw_no_meas = hw_circuit.remove_final_measurements(inplace=False)

# Enumerating all 2^n stabilizers is infeasible at this size, so draw each
# stabilizer by composing a random subset of the group generators
hw_generators = [
    Pauli(label) for label in Clifford(hw_no_meas).to_labels(mode="S")
]
sample_rng = np.random.default_rng(seed)
hw_stabilizers = []
while len(hw_stabilizers) < hw_num_stabilizers:
    mask = sample_rng.integers(0, 2, hw_num_qubits).astype(bool)
    if not mask.any():
        continue  # skip the identity
    stabilizer = Pauli("I" * hw_num_qubits)
    for generator, chosen in zip(hw_generators, mask, strict=True):
        if chosen:
            stabilizer = stabilizer.compose(generator)
    hw_stabilizers.append(stabilizer)

# -------------------------Step 2: find a 20-qubit layout, learn its noise, and add checks-------------------------
# A single bad coupler or bad-readout qubit on the path drags every
# stabilizer down, so search harder and with tighter error thresholds
hw_layout = find_check_layout(
    backend,
    hw_num_qubits,
    rng,
    num_trials=500,
    max_gate_error=0.015,
    max_readout_error=0.05,
)
hw_target_qubits, hw_ancilla_qubits = get_check_qubits(backend, hw_layout)
hw_pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=hw_layout
)
print(f"Layout with {len(hw_target_qubits)} check pairs: {hw_layout}")

# ----- learn a Pauli-Lindblad noise model on this layout -----
# The simulator example scored checks against a uniform depolarizing channel
# inferred from calibration data. Here, learn the noise instead: NoiseLearner
# runs its own job on the QPU and returns a Pauli-Lindblad channel per unique
# entangling layer, so the checks are placed against the noise this layout
# actually has, including its spatial structure. All the sampled stabilizers
# share the same entangling layers and differ only in their final basis
# rotation, so learning on the bare payload covers all of them.
learner = NoiseLearner(
    mode=backend,
    options={
        "max_layers_to_learn": 4,
        "num_randomizations": 32,
        "shots_per_randomization": 128,
        "environment": {"job_tags": ["TUT_ASPC_LEARN"]},
    },
)
learner_job = learner.run([hw_pm.run(hw_circuit)])
print(f"Submitted noise-learner job {learner_job.job_id()}")
hw_layer_errors = learner_job.result().data

# To see how much the learned model helps, swap the next line for the
# simulator example's uniform model - a one-line change:
# hw_noise_model = NoiseModel.from_backend(backend, hw_layout, uniform_gate_noise=True)
hw_noise_model = learned_noise_model(hw_layer_errors, hw_layout)
# NoiseLearner characterizes gate noise only, so keep the readout estimate
# from calibration data rather than leaving it unset
hw_noise_model.readout_noise = NoiseModel.from_backend(
    backend, hw_layout, uniform_gate_noise=True
).readout_noise
print(
    f"Learned {len(hw_layer_errors)} layers; "
    f"readout noise {hw_noise_model.readout_noise:.5f}"
)

# ----- add the fully checked circuit per stabilizer -----
hw_noisy_circuits = []
hw_checked_circuits = []
for i, pauli in enumerate(tqdm(hw_stabilizers)):
    bare = hw_pm.run(append_basis_rotation(hw_circuit, pauli))
    hw_noisy_circuits.append(bare)
    variants = add_pauli_checks(
        bare,
        hw_target_qubits,
        hw_noise_model,
        ancilla_qubits=hw_ancilla_qubits,
        cost="gamma",
        method="windowed",
        seed=seed + 1 + i,
    )
    hw_checked_circuits.append(variants[-1])  # keep the fully checked circuit

# -------------------------Step 3: submit one Sampler job with the bare and checked circuits-------------------------
sampler = Sampler(mode=backend)
sampler.options.default_shots = hw_num_shots
sampler.options.environment.job_tags = ["TUT_ASPC"]

pubs = hw_noisy_circuits + [cc.circuit for cc in hw_checked_circuits]
job = sampler.run(pubs)
print(f"Submitted job {job.job_id()} with {len(pubs)} circuits")

# -------------------------Step 4: postselect and compare fidelity-------------------------
result = job.result()
n_stab = len(hw_stabilizers)

hw_results = []
for i in range(n_stab):
    noisy_counts = result[i].join_data().get_counts()
    checked_counts = result[n_stab + i].join_data().get_counts()
    ps_fn = hw_checked_circuits[i].get_postselection_method()
    kept = {bs: c for bs, c in checked_counts.items() if not ps_fn(bs).any()}
    hw_results.append(
        (
            expectation(noisy_counts, hw_stabilizers[i]),
            expectation(kept, hw_stabilizers[i]),
            sum(kept.values()) / sum(checked_counts.values()),
        )
    )

hw_fidelity_noisy = float(np.nanmean([r[0] for r in hw_results]))
hw_fidelity_postsel = float(np.nanmean([r[1] for r in hw_results]))
hw_psr = float(np.mean([r[2] for r in hw_results]))
print(
    f"noisy fidelity estimate:        {hw_fidelity_noisy:.4f}\n"
    f"postselected fidelity estimate: {hw_fidelity_postsel:.4f}\n"
    f"mean postselection rate:        {hw_psr:.4f} "
    f"(~{int(round(hw_psr * hw_num_shots))} kept shots per circuit)"
)

# Per-stabilizer breakdown. The postselection rate varies from stabilizer to
# stabilizer, so a stabilizer whose postselected value barely moves is usually
# one whose checks rejected little; the kept-shot count says how much of the
# gap is statistics rather than signal.
print("\nper-stabilizer results:")
print(
    f"{'idx':>3}  {'noisy':>8}  {'postsel':>8}  {'psr':>7}  {'kept shots':>10}"
)
for i, (noisy, post, psr_i) in enumerate(hw_results):
    print(
        f"{i:>3}  {noisy:>8.4f}  {post:>8.4f}  {psr_i:>7.4f}  "
        f"{int(round(psr_i * hw_num_shots)):>10}"
    )

hw_noisy = np.array([r[0] for r in hw_results])
hw_post = np.array([r[1] for r in hw_results])
idx = np.arange(n_stab)

fig, ax = plt.subplots(figsize=(9, 4))
ax.axhline(1.0, color="black", linewidth=1.5, label="ideal")
strip(ax, hw_noisy, "red", "noisy")
strip(ax, hw_post, "green", "postselected")
ax.scatter(idx, hw_noisy, color="red", s=22, alpha=0.7, label="noisy EVs")
ax.scatter(
    idx,
    hw_post,
    color="green",
    s=22,
    alpha=0.7,
    label="postselected EVs",
)
ax.set_xlabel("stabilizer index")
ax.set_ylabel(r"$\langle G \rangle$")
ax.set_ylim((-0.1, 1.1))
ax.set_xticks(idx)
ax.set_title("Per-stabilizer expectation values on hardware")
# Outside the axes so it cannot hide a data point
ax.legend(loc="center left", bbox_to_anchor=(1.02, 0.5), frameon=False)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Layout with 11 check pairs: [153, 152, 151, 138, 131, 130, 129, 118, 109, 110, 111, 98, 91, 90, 89, 78, 69, 70, 71, 58]
Submitted noise-learner job d9f4mncjeosc73fjfmkg
Learned 4 layers; readout noise 0.00470
100%|██████████| 10/10 [01:01<00:00, 6.18s/it]
Submitted job d9f4s04jeosc73fjftkg with 20 circuits
noisy fidelity estimate:        0.3685
postselected fidelity estimate: 0.6869
mean postselection rate:        0.2851 (~11404 kept shots per circuit)

per-stabilizer results:
idx     noisy   postsel      psr  kept shots
  0    0.3769    0.6918   0.3247       12987
  1    0.3745    0.6760   0.2999       11995
  2    0.3659    0.6389   0.3549       14196
  3    0.3821    0.7060   0.2660       10641
  4    0.3653    0.7475   0.2531       10124
  5    0.3752    0.7022   0.2698       10791
  6    0.3508    0.7144   0.2711       10842
  7    0.3485    0.7087   0.2381        9523
  8    0.3825    0.6289   0.2928       11711
  9    0.3630    0.6549   0.2808       11232

U obvodů této velikosti obsahuje většina vzorků alespoň jednu detekovanou chybu, takže míra postselekce je malá a postselekce zahodí většinu výstřelů. Vzorky, které projdou všemi kontrolami, dávají mnohem lepší střední hodnotu než holý obvod a hodnoty pro jednotlivé stabilizátory se čistě oddělují od zašuměného základu. Pro zpřesnění odhadu věrnosti vzorkuj více stabilizátorů se stejným rozpočtem výstřelů na obvod. Pro zvýšení míry postselekce sniž hloubku obvodu nebo zaveď méně kontrol; pro posun k větším payloadům škáluj rozpočet výstřelů s převrácenou hodnotou míry postselekce.
Další kroky
Pokud tě tato práce zaujala, mohly by tě zajímat následující materiály:
-
Tutoriál o repetičních kódech jako úvod do kvantové korekce chyb.
-
Dokumentace
qiskit-paulicepro úplné API pro hledání kontrol a GitHub repozitář balíčku pro zdrojový kód. -
Článek Low-overhead error detection with spacetime codes pro teorii za kontrolami.
Reference
-
[1] Martiel, S., & Javadi-Abhari, A. (2025). Low-overhead error detection with spacetime codes. arXiv preprint arXiv:2504.15725.
-
[2] van den Berg, E., Bravyi, S., Gambetta, J. M., Jurcevic, P., Maslov, D., & Temme, K. (2023). Single-shot error mitigation by coherent Pauli checks. Physical Review Research, 5(3), 033193.