Učení zašuměných kvantových stavů pomocí klasických stínů
Odhad využití: 34 minut na procesoru Heron r2 (POZNÁMKA: Jedná se pouze o odhad. Tvá doba běhu se může lišit.)
Výukové cíle
-
Sbírat randomizovaná měření na kvantovém procesoru IBM® z jazyka Julia a uložit je pro pozdější analýzu
-
Před učením zkontrolovat měřicí data na vadné qubity a hradla
-
Naladit model zašuměného stavu ve tvaru maticového součinového operátoru (MPO) na klasické stíny
-
Ověřit model na odložených měřeních a porovnat ho s ideálním obvodem
Předpoklady
-
Klasické stíny, jak jsou představeny v tutoriálu Shadow tomography of the Greenberger-Horne-Zeilinger (GHZ) state
-
Matice hustoty a smíšené stavy, probrané v kurzu Basics of quantum information
-
Spouštění obvodů z jazyka Julia pomocí
Qiskit.jlaQiskitIBMRuntime.jl, představené v tutoriálu Simulate time evolution of the transverse-field Ising model
Pozadí
Na skutečném kvantovém procesoru šum mění čistý stav , který má obvod připravit, na smíšený stav . Úplná kvantová tomografie stavu dokáže rekonstruovat, ale počet potřebných měření roste exponenciálně s počtem qubitů. Votto et al. [1] se místo toho z randomizovaných měření naučili kompaktní model až pro 96 qubitů. Tento tutoriál sleduje jejich postup.
Při randomizovaném měření [2] je každý qubit otočen nezávislou náhodnou unitární transformací a poté změřen ve výpočetní bázi. Jedno vylosování rotací se nazývá nastavení měření a každé nastavení se opakuje shotů. Shot s výsledkem bitů dává klasický stín [3]
jehož průměr přes nastavení a shoty je . Tutoriál s předpoklady losuje každé ze tří Pauliho bází; tento tutoriál, stejně jako článek, je losuje rovnoměrně ze všech jednoqubitových unitárních transformací (Haarovsky náhodně) a platí stejný vzorec.
Stíny odhadují vlastnosti několika qubitů najednou. Článek je kombinuje do maticového součinového operátoru (MPO), který zapisuje matici hustoty jako řetězec malých tenzorů, po jednom na qubit; zašuměné stavy s krátkodosahovými korelacemi potřebují jen malé vazby mezi sousedními tenzory. Podobně jako algoritmus renormalizační grupy matice hustoty (DMRG) prochází učící algoritmus řetězec a aktualizuje vždy jeden tenzor tak, aby model odpovídal stínům na okně qubitů vycentrovaném na tento tenzor (rovnice 4 v článku). Vazebná dimenze zůstává během těchto aktualizací pevná, takže učící algoritmus model nikdy neořezává. Protože data vstupují pouze přes tato okna, počet potřebných nastavení neroste s délkou řetězce.
Nastavení se dělí na trénovací a testovací množinu. Na testovací množině článek odhaduje maximální věrnost mezi a modelem ,
Přímé měření by vyžadovalo exponenciálně mnoho měření. Článek místo toho předpokládá podmínku přibližné faktorizace (AFC): korelace v odeznívají během několika qubitů, takže globální překryvy a čistoty se faktorizují na členy na blocích sousedních qubitů. Čistota také dává Rényiho-2 entropii , která měří, jak smíšený stav je.
Článek připravuje kicked-Isingův stav hloubky
na 96 qubitech zařízení ibm_brisbane, procesoru Eagle, s 2 048 nastaveními po 1 024 shotech pro . Obrázek 1(c,d) v článku uvádí dva výsledky pro :
-
Naučený model dosahuje s experimentálním stavem při , což je daleko nad překryvem ideálního stavu s experimentem.
-
Entropie roste lineárně, , a entropie modelu souhlasí s nezávislým odhadem z testovací množiny.
Tento tutoriál ověřuje oba výsledky, nejprve v osmiqubitové simulaci, kde jsou přesné odpovědi známé, a poté v novém 96qubitovém běhu na ibm_fez, procesoru Heron r2. Učící algoritmus je nezávislá implementace rovnic z článku a jeho dodatku v jazyce Julia.
Požadavky
Tento tutoriál vyžaduje macOS nebo Linux, protože Qiskit.jl zatím nepodporuje Windows (Qiskit.jl issue #15). Dále potřebuješ následující:
-
Julia 1.11, ze stránky ke stažení Julie nebo pomocí
juliaup add 1.11, a balíčekIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Pro příklad na hardwaru účet IBM Quantum® Platform s přístupem k QPU s alespoň 96 qubity a uložené přihlašovací údaje. Bez účtu můžeš příklad na hardwaru spustit z uložených měření běhu na
ibm_fez, který vytvořil výsledky v tomto tutoriálu. Ostatní sekce běží bez účtu.
Notebook používá Qiskit.jl a QiskitIBMRuntime.jl k sestavení a spouštění obvodů, RandomMeas.jl [4] pro randomizovaná měření (poskytuje také ITensors.jl a ITensorMPS.jl) a NPZ.jl, JSON.jl a Plots.jl. Tento tutoriál je testován s Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 a RandomMeas.jl 0.3.1.
Prostředí lze nastavit dvěma způsoby:
-
Možnost 1: Nainstaluj nejnovější kompatibilní verze balíčků do dočasného prostředí. Spusť následující buňku beze změn.
-
Možnost 2: Přesně reprodukuj testované prostředí. V následující buňce nastav
download_toml_files = true. Buňka stáhneProject.tomlaManifest.tomlz repozitáře dokumentace do složkyenv_tutorial/classical-shadows/vedle tohoto notebooku a poté nainstaluje přesnou verzi každého balíčku, kterou manifest zaznamenává, včetně nepřímých závislostí. Podrobnosti najdeš v dokumentaci Julie k těmto souborům.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Nastavení
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Pomocný modul mpo_learning.jl, který stahuje buňka Setup, implementuje učící algoritmus. Tutoriál z něj volá následující funkce:
| Funkce | Účel |
|---|---|
kicked_ising_reference(N, D; depolarization) | Přesný MPO ideálního kicked-Isingova stavu nebo stavu po lokálním depolarizačním šumu |
split_settings(group; seed, train_fraction) | Náhodně přiřadí nastavení měření do trénovací a testovací množiny (ve výchozím nastavení každé polovině) |
training_marginals(train; ell, prior) | Odhady každého učícího okna ze stínů, pouze z trénovacích nastavení |
fitted_prior(ideal, train) | Prior pro společná randomizovaná měření (CRM), naladěný na naměřenou čistotu každého okna, jako v článku |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Projde řetězec jednopozičními aktualizacemi z článku, počínaje maximálně smíšeným stavem |
max_fidelity(a, b), mpo_overlap(a, b) | Přesné a mezi dvěma MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Odhady a pomocí AFC z testovacích nastavení, s chybovými úsečkami jackknife |
Učící algoritmus ukládá MPO v Pauliho bázi. Tím zůstává model hermitovský s jednotkovou stopou, ale nevynucuje se pozitivní semidefinitnost, takže notebook hlásí, jak záporné jeho vlastní hodnoty jsou.
Příklad v simulátoru malého rozsahu
Začni se systémem dostatečně malým, aby se vše dalo spočítat přesně: kicked-Isingův stav hloubky jedna na osmi qubitech s 12% lokálním depolarizačním šumem, který modeluje hardware. Protože zašuměný stav je znám, můžeš s ním naučený model přímo porovnat.
Krok 1: Převeďte klasické vstupy na kvantový problém
Funkce kicked_ising_reference vrací přesný stav jako MPO. Při depolarization=0.12 se Blochův vektor každého qubitu po obvodu zmenší o 12 %.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Krok 2: Optimalizujte problém pro provedení na kvantovém hardwaru
Tento příklad vzorkuje výsledky měření klasicky, takže není co transpilovat. Tento krok pokrývá příklad na hardwaru.
Krok 3: Proveďte pomocí primitiv Qiskit
Pomocí RandomMeas.jl vylosuj 2 048 Haarovsky náhodných nastavení měření a z každého vzorkuj 256 shotů, poté nastavení rovnoměrně rozděl na trénovací a testovací množinu. Dělení proveď podle nastavení, nikoli podle shotů: shoty ze stejného nastavení sdílejí jeho rotace, takže nejsou nezávislé.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Krok 4: Postprocessing a vrácení výsledku v požadovaném klasickém formátu
Nauč model s parametry hloubky jedna z článku: okna, která sahají qubity na každou stranu aktualizovaného tenzoru, vazebná dimenze 4 a 20 průchodů počínaje maximálně smíšeným stavem. První průchod aktualizuje sousední dvojice tenzorů, což umožňuje vazebné dimenzi vzrůst z 1 na 4; každý další průchod aktualizuje vždy jeden tenzor při této pevné vazebné dimenzi.
Aby se snížil statistický šum stínů, článek používá společná náhodná měření (CRM) [5]. Pro každé nastavení odečte průměrný stín, který by v tomtéž nastavení vytvořil předběžný odhad stavu, a poté přičte zpět přesnou hodnotu tohoto předběžného odhadu. Korekce má nulovou střední hodnotu, takže předběžný odhad mění velikost statistické chyby, ale ne to, co se odhaduje. Zde je předběžným odhadem ideální stav s 10% lokální depolarizací, blízko skutečným 12 %. Na hardwaru je úroveň šumu neznámá, takže příklad na hardwaru fituje předběžný odhad na změřené čistoty, stejně jako v článku.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
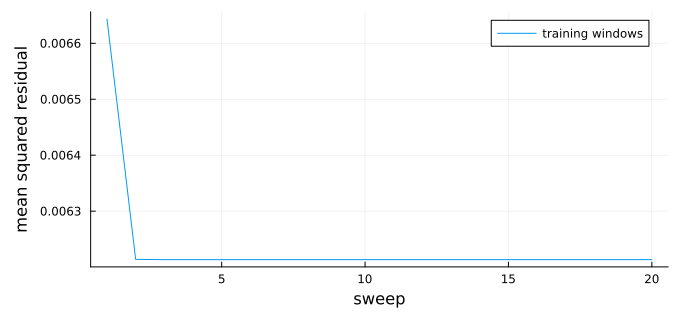
Reziduum měří, jak daleko jsou okna modelu od trénovacích stínů. Klesne, když začnou aktualizace jednoho místa, ve druhém průchodu, a pak zůstane přibližně konstantní místo toho, aby dosáhlo nuly, protože stíny obsahují statistický šum, který model s malou vazebnou dimenzí nedokáže reprodukovat.
Protože je tento stav známý, můžeš s ním naučený model porovnat přesně a také s ním porovnat dva nejjednodušší odhady: předběžný odhad CRM a ideální stav.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Naučený model je blíže zašuměnému stavu než předběžný odhad i ideální stav, takže se šum naučil z dat. Jeho malé záporné vlastní hodnoty pocházejí z konečného počtu měření.
Na hardwaru je stav neznámý, takže odhadneš místo toho z testovacích nastavení. AFC rozdělí řetězec na bloky po qubitech a čistotu aproximuje pomocí
a stejným poměrem lokálních překryvů. Pro pokrývají dva bloky všech osm qubitů a vzorec je přesný; pro se spoléhá na předpoklad faktorizace. Chybové úsečky jackknife, které vynechávají vždy jedno testovací nastavení, pokrývají pouze statistickou chybu testovacích dat, nikoli náhodnost trénování ani aproximaci AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Oba odhady na zadržených datech souhlasí s přesnou hodnotou v rámci svých chybových úseček.
Příklad velkého hardwaru
Nyní spusť experiment na 96qubitovém řetězci procesoru ibm_fez, což je procesor Heron r2. Stejně jako ibm_brisbane má coupling mapu typu heavy-hex a podobnou úroveň šumu.
Sběr dat zabere 1 024 úloh Sampler a asi 34 minut času QPU. Pokud nemáš přístup k QPU s alespoň 96 qubity nebo je fronta dlouhá, spusť příklad na hardwaru z měření zaznamenaných na ibm_fez dne 27. září 2026, která vytvořila výsledky zobrazené v tomto tutoriálu. S use_saved_data = true notebook stáhne tato měření (15 MB) ze Zenodo [6] v kroku 1 a přeskočí odesílání úloh v kroku 3. Chceš-li sbírat vlastní data, nastav hodnotu na false.
use_saved_data = true; # set to false to collect new measurements on hardware
Krok 1: Mapování klasických vstupů na kvantový problém
Každé nastavení potřebuje jeden obvod: obvod kicked-Ising, hradlo na každém qubitu pro a měření každého qubitu. Vzorkování , kde , a jsou rovnoměrné v , činí Haarovsky náhodnou. Funkce u3_matrix vrací matici , kterou používá krok 4.
Rozpočet je 1 024 nastavení po 1 024 shotech, polovina počtu nastavení z článku, rozdělená rovnoměrně mezi trénování a testování. S uloženými daty buňka načte zaznamenané úhly. Jinak vylosuje nové úhly a uloží je dřív, než cokoli odešleš, protože bez nich nelze výsledky analyzovat. Pokud soubor již existuje, buňka ho načte, aby úhly po restartu session stále odpovídaly uloženým výsledkům.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Krok 2: Optimalizace problému pro provedení na kvantovém hardwaru
Řetězec je tak dobrý jako jeho nejhorší qubit, proto si 96 fyzických qubitů vyber sám. Funkce transpile z Qiskit.jl zatím nepřijímá pevné počáteční rozložení a v testu na ibm_phoenix rozložení, které zvolila, zahrnovalo qubit s 51% chybou čtení. Následující řetězec je 96qubitová cesta v coupling mapě ibm_fez, kterou vybralo rozložení s ohledem na chyby funkce transpile z Pythonu Qiskit (s optimization_level=3) z kalibračních dat ze dne 27. září 2026. Jeho průměrná chyba čtení je 1,6 %, ale mřížka heavy-hex má málo 96qubitových cest a tato zahrnuje qubit 35 s 15% chybou čtení. Kalibrace se mění, proto před spuštěním v jiný den nebo na jiném QPU vyber nový řetězec z aktuálních kalibračních dat.
Abys tento řetězec zachoval, zapiš obvody přímo v nativních hradlech místo transpilace. Hradlo se rovná až na globální fázi. Tento rozklad pokrývá náhodné rotace i kop . Hradlo se rovná hradlu CZ následovanému na obou qubitech, až na globální fázi. Protože jsou tato hradla diagonální, komutují s hradly CZ, takže každý qubit před svou měřicí rotací nasbírá jedno na každou vazbu.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Krok 3: Provedení pomocí primitiv Qiskit
QiskitIBMRuntime.jl spouští jeden obvod na úlohu Sampler, takže sběr dat vyžaduje 1 024 úloh. Následující buňka udržuje ve frontě až 32 úloh a výsledky každého nastavení ukládá, jakmile jeho úloha skončí. Každý shot se vrací jako vektor bitů, v němž prvek je výsledek qubitu řetězce.
Výsledky musíš získat ve stejné session, která úlohy odeslala, protože QiskitIBMRuntime.jl zatím neumí vyhledat úlohu podle jejího ID (qiskit-ibm-runtime-c issue #28). Pokud úloha selže, buňka vydá varování a pokračuje. Pokud session skončí, spusť kroky 1 až 3 znovu. Opětovné spuštění buňky odešle jen nastavení, jejichž výsledky chybí. S use_saved_data = true buňka neodešle nic.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Krok 4: Následné zpracování a vrácení výsledku v požadovaném klasickém formátu
Tento krok čte pouze uložená data: stažený běh ibm_fez, pokud je use_saved_data true, jinak soubory, které zapsal krok 3. Můžeš ho tedy spustit v nové session bez odesílání úloh (nejdřív spusť buňku Setup, buňku use_saved_data a krok 1). Stažený soubor ukládá 96 výsledků každého shotu zabalených do 12 bajtů, nejvýznamnější bit první, takže je načítač rozbalí. RandomMeas.jl značí výsledky 1 a 2, takže načítač ke každému bitu také přičte 1.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Před učením zkontroluj data. Rozbitý qubit nebo špatně zkalibrované hradlo způsobí, že změřený stav je kolem něj mnohem více smíšený, a může způsobit divergenci učení. Čistota několika sousedních qubitů je benchmark tohoto šumu nezávislý na modelu: funkce get_purity z RandomMeas.jl odhaduje pro podsystém porovnáním dvojic shotů ze stejného nastavení. Spočítej Rényiho-2 entropii každého okna šesti sousedních qubitů a porovnej ji se stejným oknem ideálního stavu. Ideální hodnota není nula, protože každé okno je provázané se zbytkem řetězce; šum ji zvyšuje a rozbitý qubit posune každé okno, které ho obsahuje, k maximu šesti.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
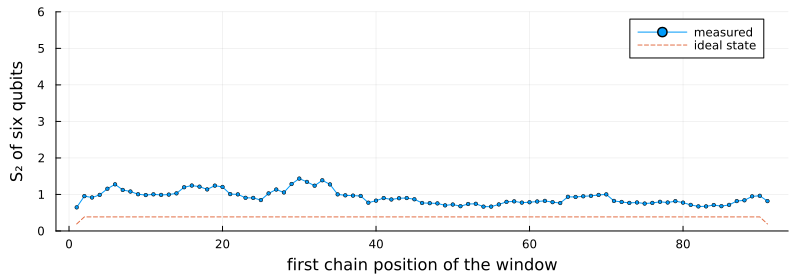
Každé okno je více smíšené než ideální stav, přibližně o půl bitu až bit, a nejhlučnější úsek je kolem pozic řetězce 30 až 35. Žádné okno se k maximu šesti ani nepřibližuje, takže žádný qubit není rozbitý a analýza používá celý 96qubitový řetězec. Kdyby některá okna měla entropii blízkou šesti, odstranil bys qubit, který tato okna sdílejí, a učil by ses nejdelší část řetězce bez něj.
Stejné čistoty určují předběžný odhad CRM. Pro každé okno fitted_prior vezme ideální stav a nafituje sílu lokální depolarizace tak, aby jeho čistota odpovídala čistotě změřené v trénovacích nastaveních, jako v článku.
Funkce learn_and_validate v následující buňce provede zbytek analýzy. Naučí model z trénovacích nastavení a poté odhadne a na testovacích nastaveních pro prvních qubitů řetězce, po krocích po 12. Jsou to veličiny na obrázku 1(c,d) v článku. Ideální stav se vyhodnotí na stejných testovacích datech jako základní srovnání.
Buňka spustí funkci s a pak ji zopakuje s a , aby se ukázalo, jak moc záleží na velikosti učicích oken. Vazebná dimenze může být nejvýše , takže se učí součinový stav: každý qubit zvlášť, bez korelací mezi qubity.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
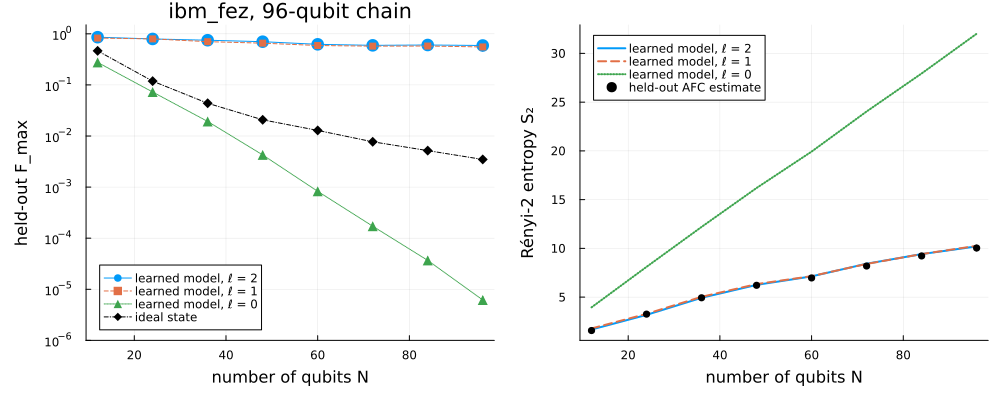
Výsledky reprodukují obě tvrzení článku na jiném procesoru:
-
Model popisuje data mnohem lépe než ideální stav. Při je zadržené modelu s rovno 0,59 ± 0,10, oproti 0,0035 u ideálního stavu. Článek uvádí asi 0,75 na
ibm_brisbane. -
Entropie modelu souhlasí s testovacími daty pro každé . Při je 10,2 z modelu a 10,0 ± 0,3 z testovacích dat, tedy , oproti 0,14 až 0,15 na starším
ibm_brisbane.
Porovnání velikostí oken ukazuje, kde je informace. S je model téměř stejně dobrý (), takže pro tato data korelace za hranicí několika qubitů přidávají málo. S součinový stav míjí provázání mezi sousedními qubity: jeho entropie roste na 32 místo 10 a jeho klesá ještě rychleji než u ideálního stavu, na při .
Při čtení těchto čísel mysli na následující omezení:
-
Rozdělení na trénování. Chybové úsečky pokrývají pouze statistickou chybu testovacích dat. Jiná náhodná rozdělení stejných nastavení dávají mezi 0,49 a 0,59 při pro .
-
Poslední průchod. Učení vždy vrací model z posledního průchodu, takže testovací data model nikdy neovlivní.
-
Pozitivita. Model není omezen na pozitivní semidefinitnost; jeho nejzápornější vlastní hodnota v učicím okně je asi . Jeho a proto popisují operátor, nikoli certifikované vlastnosti fyzického stavu.
-
Faktorizace. Každý odhad na zadržených datech spoléhá na předpoklad AFC, který samotná měření nemohou certifikovat.
Další kroky
-
Zopakuj experiment v hloubce dva s parametry z článku pro tuto hloubku ( a maximální vazebná dimenze 8) a zjisti, kolik měřicích nastavení učení potřebuje.
-
Uč se pomocí dvoumístné aktualizace (
update=:two_sitevtraining_marginalsalearn_mpo), která po každém kroku ořezává vazebnou dimenzi, a sleduj, jak se chová s menším počtem trénovacích nastavení. -
Uč se bez předběžného odhadu CRM (
prior=nothing) a porovnej fidelitu na zadržených datech. -
Použij stejnou analýzu na zveřejněná měření
ibm_brisbaneod autorů. -
Přečti si dodatek k článku, kde najdeš odvození aktualizace a odhadů AFC.
-
Prozkoumej další protokoly náhodných měření v příkladech
RandomMeas.jl.
Reference
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174