Kvantový aproximační optimalizační algoritmus
Odhad využití: 22 minut na procesoru Heron r3 (POZNÁMKA: Jedná se pouze o odhad. Skutečná doba běhu se může lišit.)
Co se naučíš
-
Jak mapovat klasický kombinatorický optimalizační problém (max-cut) na kvantový Hamiltonián
-
Jak implementovat a spustit Kvantový aproximační optimalizační algoritmus (QAOA) pomocí IBM Quantum Compute Service sessions
-
Jak škálovat pracovní postup QAOA z malého příkladu na simulátoru na spuštění na hardwaru v užitkové škále
Předpoklady
-
QAOA do hloubky — pro komplexní zpracování algoritmu QAOA a jeho aplikaci v užitkové škále
Pozadí
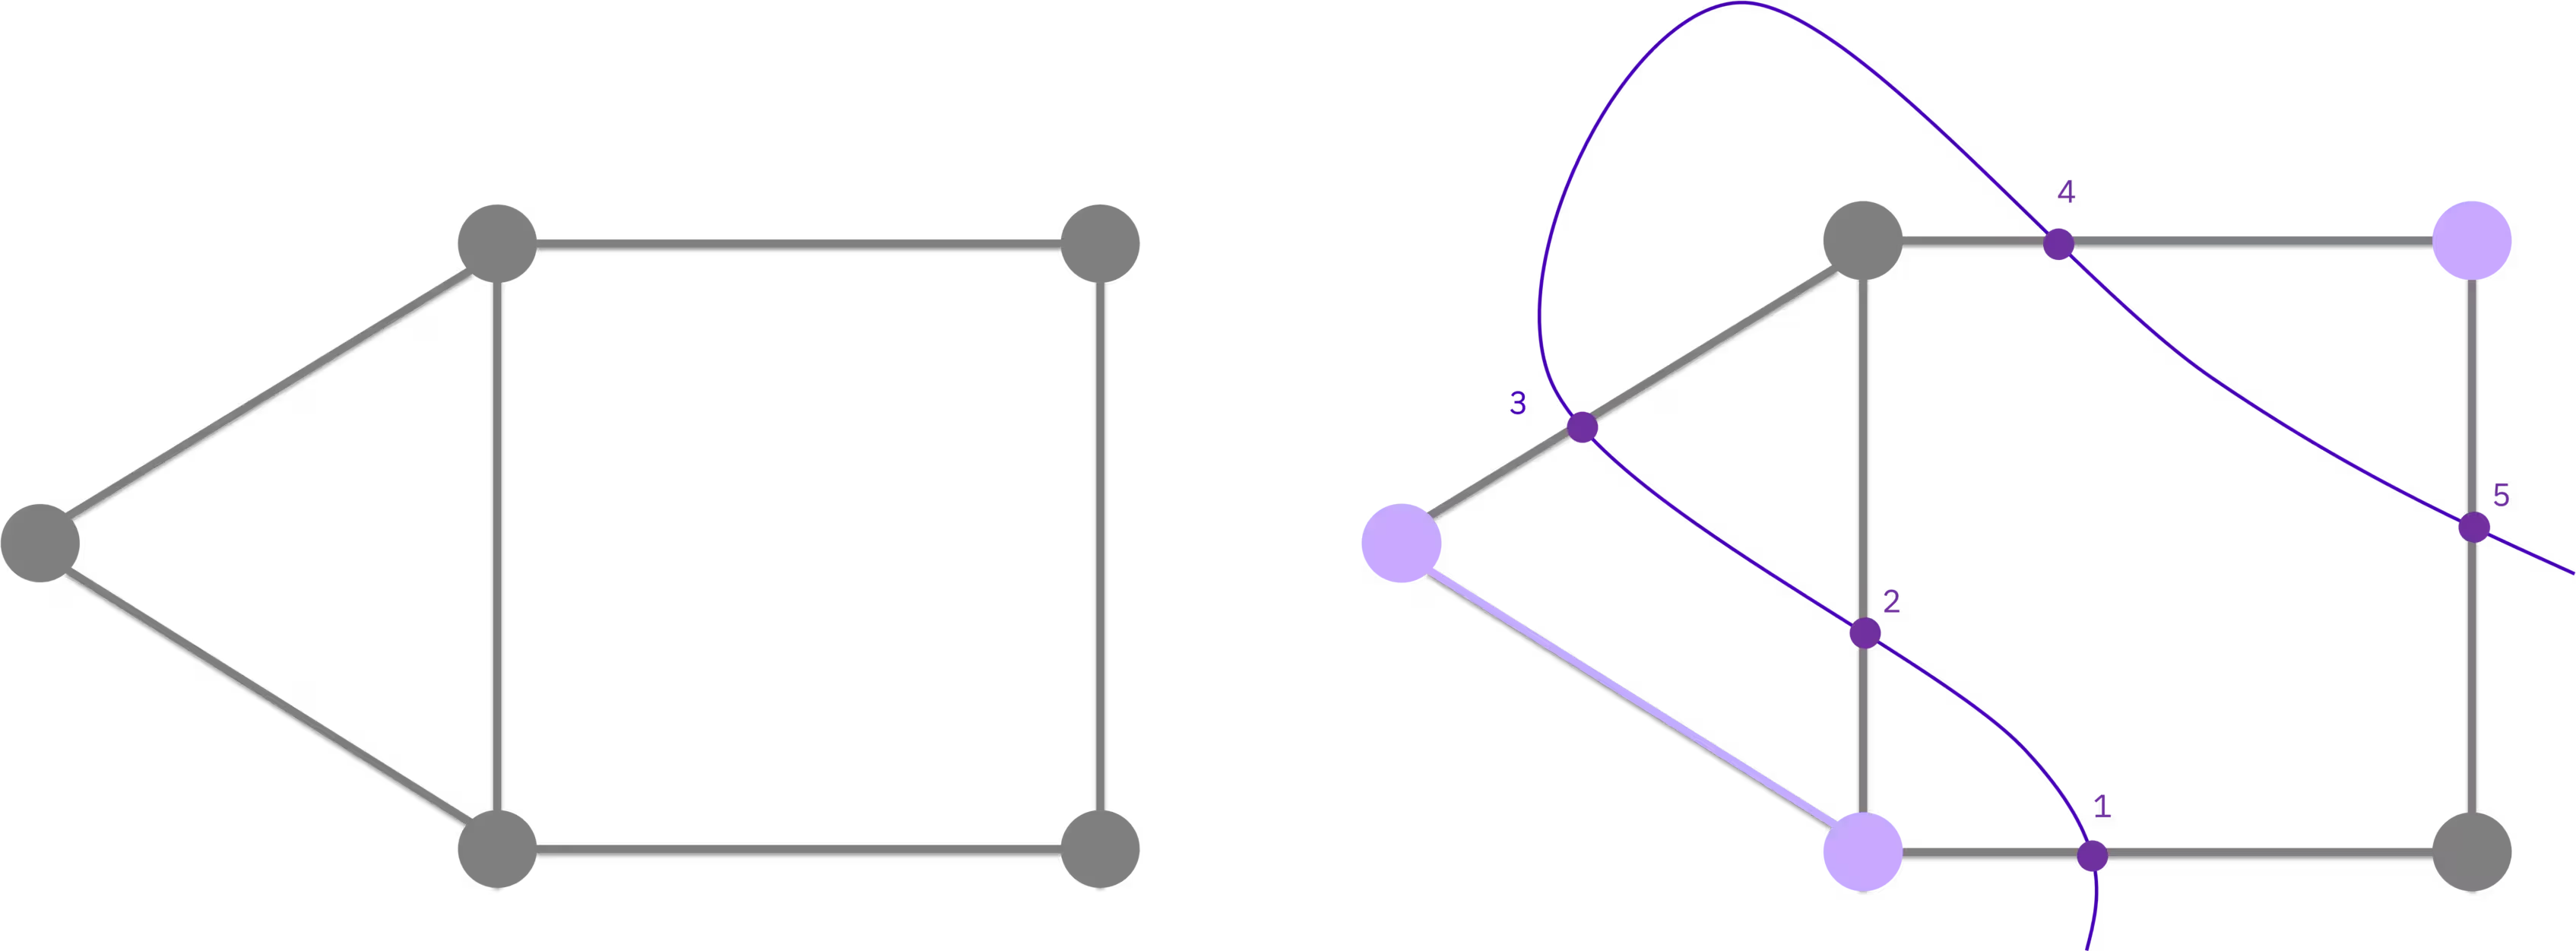
Kvantový aproximační optimalizační algoritmus (QAOA) je hybridní kvantově-klasická iterativní metoda pro řešení kombinatorických optimalizačních problémů. V tomto tutoriálu použiješ QAOA k vyřešení problému maximálního řezu (max-cut) — NP-těžkého optimalizačního problému s aplikacemi v clusterování, síťové vědě a statistické fyzice. Pro daný graf uzlů propojených hranami je cílem rozdělit uzly do dvou množin tak, aby byl maximalizován počet hran, které řez překračují.
Kombinatorická optimalizace se objevuje také v úkolech spojených s udržitelností, jako je plánování rozvozových tras za účelem snížení spotřeby paliva nebo alokace zdrojů k omezení materiálového odpadu. Příklad max-cut představuje postup vyjádření cílové funkce jako nákladového Hamiltoniánu a zkoumání kandidátních řešení pomocí QAOA. Uplatnění tohoto přístupu na problém udržitelnosti vyžaduje cílovou funkci a omezení, které reprezentují zamýšlenou aplikaci.
Od klasické optimalizace ke kvantovým Circuit
Max-cut lze vyjádřit jako klasický binární optimalizační problém. Každému uzlu je přiřazena binární proměnná označující, do které množiny patří. Cílem je maximalizovat počet hran, jejichž koncové body jsou v různých množinách:
To je ekvivalentně problém kvadratické neomezené binární optimalizace (QUBO) ve tvaru . Pomocí standardní substituce proměnných () lze QUBO přepsat jako nákladový Hamiltonián, jehož základní stav kóduje optimální řešení. Obecně má tento Hamiltonián jak kvadratické, tak lineární členy:
V tomto tutoriálu tuto substituci neprovádíš ručně. Qiskit addon Optimization Mapper (qiskit-addon-opt-mapper) poskytuje aplikační třídu Maxcut, která modeluje problém přímo z grafu, konvertor, který model převede na QUBO, a překladač, který QUBO zobrazí na . Pro zde uvažovaný neváhovaný problém max-cut lineární koeficienty zanikají () a každá hrana přispívá členem spolu s konstantním posunem, který dává do vztahu a hodnotu řezu. Stejný řetězec zpracuje váhované grafy a další problémy vyjádřitelné jako QUBO beze změny zbytku pracovního postupu.
Jak QAOA funguje
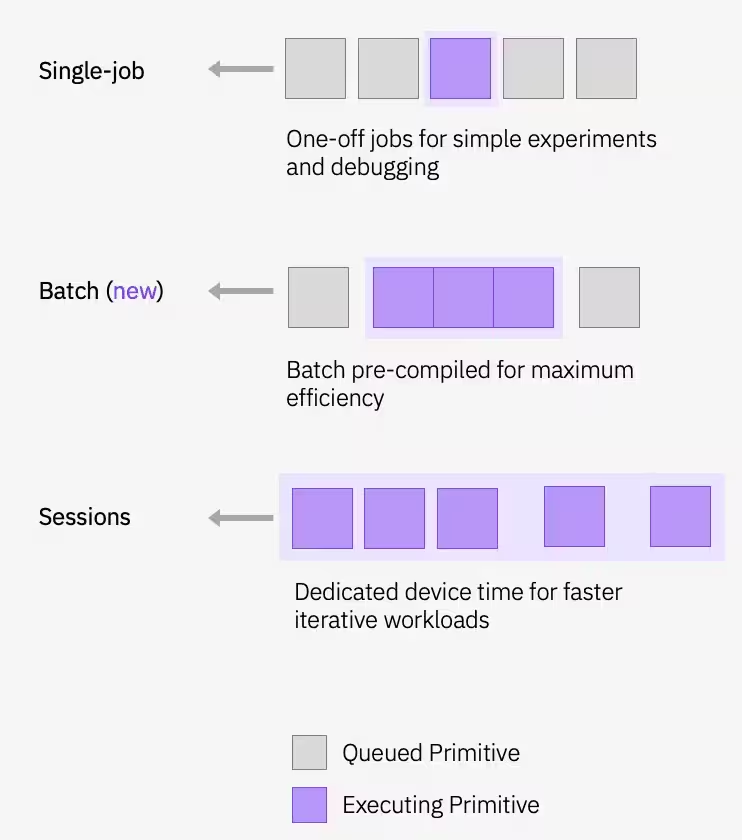
QAOA připravuje kandidátní řešení aplikací střídavých vrstev dvou operátorů na počáteční superpoziční stav : nákladového operátoru a mixujícího operátoru . Úhly a jsou optimalizovány v klasické zpětnovazební smyčce; kvantový počítač vyhodnocuje nákladovou funkci a klasický optimalizátor aktualizuje parametry až do konvergence. Tato iterační smyčka běží uvnitř Quantum Compute session, která udržuje kvantové zařízení rezervované napříč iteracemi pro nižší latenci.

Pro hlubší zpracování teorie QAOA, včetně úplného odvození QUBO-na-Hamiltonián, viz modul kurzu QAOA.
V tomto tutoriálu nejprve vyřešíš max-cut na malém grafu s pěti uzly a poté škáluješ stejný pracovní postup na problém se 100 uzly v užitkové škále na reálném hardwaru. Poznámka k přístupu dle plánu: Tento tutoriál používá Quantum Compute sessions, které jsou dostupné pouze v rámci Premium Plánu. Pokud jsi na Open Plánu, nemůžeš tento tutoriál spustit tak, jak je napsán; místo toho budeš muset vyměnit Session za režim úloh (job mode) (tedy odeslat každou iteraci jako nezávislou úlohu místo zabalení optimalizační smyčky do with Session(...)). Pracovní postup stále poběží, ale každá iterace čeká celou dobu ve frontě, místo aby znovu využila rezervované zařízení. Více informací viz Přehled dostupných plánů.
Požadavky
Před zahájením tohoto tutoriálu se ujisti, že máš nainstalováno následující:
-
Qiskit SDK v2.0 nebo novější s podporou vizualizace
-
Qiskit Runtime v0.22 nebo novější (
pip install qiskit-ibm-runtime) -
Qiskit addon Optimization Mapper (
pip install qiskit-addon-opt-mapper)
Kromě toho budeš potřebovat přístup k instanci na IBM Quantum® Platform.
Nastavení
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "rustworkx": "rustworkx", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import rustworkx as rx
from rustworkx.visualization import mpl_draw as draw_graph
import numpy as np
from scipy.optimize import minimize
from collections import defaultdict

from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import QAOAAnsatz
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import Session, EstimatorV2 as Estimator
from qiskit_ibm_runtime import SamplerV2 as Sampler

from qiskit_addon_opt_mapper.applications import Maxcut
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_addon_opt_mapper.translators import to_ising
Příklad v malém měřítku
Tato sekce tě provede jednotlivými kroky pracovního postupu QAOA na malé instanci max-cut s pěti uzly. Navzdory označení "malé měřítko" se tento příklad stále spouští na reálném hardwaru IBM Quantum — kód vybere Backend se 127 nebo více Qubity a spustí tam Circuit. Inicializuj svůj problém vytvořením grafu s uzly.
n_small = 5

graph = rx.PyGraph()
graph.add_nodes_from(np.arange(0, n_small, 1))
edge_list = [
    (0, 1, 1.0),
    (0, 2, 1.0),
    (0, 4, 1.0),
    (1, 2, 1.0),
    (2, 3, 1.0),
    (3, 4, 1.0),
]
graph.add_edges_from(edge_list)
draw_graph(graph, node_size=600, with_labels=True)

Krok 1: Mapování klasických vstupů na kvantový problém
Mapuj klasický graf na kvantové Circuity a operátory. Jak je popsáno v sekci Pozadí, max-cut je problém QUBO, jehož nákladový Hamiltonián má základní stav kódující optimální řez, a QAOA používá parametrizovaný ansatz Circuit k přípravě kandidátních základních stavů . Pomocí addonu Optimization Mapper se dostaneš z grafu k ve třech krocích: namodeluj problém, převeď ho na QUBO a přelož QUBO na Isingův Hamiltonián.
Namodeluj problém
Aplikační třída Maxcut přijímá graf rustworkx přímo a vrací OptimizationProblem, jehož cílem je hodnota řezu, kterou je třeba maximalizovat. Každá hrana přispívá do cílové funkce členem , přesně jako v sekci Pozadí.
maxcut = Maxcut(graph)
maxcut_problem = maxcut.to_optimization_problem()
print(maxcut_problem.prettyprint())
Problem name: Max-cut

Maximize
  -2*x_0*x_1 - 2*x_0*x_2 - 2*x_0*x_4 - 2*x_1*x_2 - 2*x_2*x_3 - 2*x_3*x_4 + 3*x_0
  + 2*x_1 + 3*x_2 + 2*x_3 + 2*x_4

Subject to
  No constraints

  Binary variables (5)
    x_0 x_1 x_2 x_3 x_4
Sestavení nákladového Hamiltoniánu
Převeď problém na QUBO pomocí OptimizationProblemToQubo a poté přelož QUBO na Isingův Hamiltonián pomocí to_ising. Konvertor změní maximalizaci na minimalizaci záporné hodnoty řezu a překladač aplikuje substituci . Vrací jako SparsePauliOp spolu se skalárním offset tak, že . Protože QUBO minimalizuje zápornou hodnotu řezu, hodnota řezu libovolného bitřetězce je .
qubo = OptimizationProblemToQubo().convert(maxcut_problem)
cost_hamiltonian, offset = to_ising(qubo)
print("Cost Function Hamiltonian:", cost_hamiltonian)
print("Offset:", offset)
Cost Function Hamiltonian: SparsePauliOp(['IIIZZ', 'IIZIZ', 'ZIIIZ', 'IIZZI', 'IZZII', 'ZZIII'],
              coeffs=[0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j, 0.5+0.j])
Offset: -3.0
Sestavení QAOA ansatz Circuit
Použij QAOAAnsatz k sestavení parametrizovaného QAOA Circuit z nákladového Hamiltoniánu. Zde používáme reps=2 (dvě vrstvy QAOA, čtyři parametry: ).
circuit = QAOAAnsatz(cost_operator=cost_hamiltonian, reps=2)
circuit.measure_all()

circuit.draw("mpl")

circuit.parameters
ParameterView([ParameterVectorElement(β[0]), ParameterVectorElement(β[1]), ParameterVectorElement(γ[0]), ParameterVectorElement(γ[1])])
Krok 2: Optimalizace problému pro spuštění na kvantovém hardwaru
Transpiluj abstraktní Circuit na instrukce nativní pro hardware. Tento krok řeší mapování Qubitů, dekompozici Gate, směrování a potlačení chyb. Více informací viz dokumentace k transpilaci.
service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=127
)
print(backend)

# Create pass manager for transpilation. Level 3 is the most aggressive
# preset: slower to transpile, but produces shorter circuits that are
# more robust to hardware noise.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)

candidate_circuit = pm.run(circuit)
candidate_circuit.draw("mpl", fold=False, idle_wires=False)
<IBMBackend('ibm_pittsburgh')>

Krok 3: Spuštění pomocí Qiskit primitiv
Optimalizační smyčka QAOA běží uvnitř Quantum Compute session, aby zařízení zůstalo rezervované napříč iteracemi. Estimator vyhodnocuje v každém kroku a klasický optimalizátor (COBYLA) aktualizuje parametry až do konvergence.
 Definuj počáteční parametry a spusť optimalizační smyčku:
# QAOA doesn't prescribe principled default angles — any bounded choice
# works as a warm start for problems this small. beta and gamma are
# periodic (beta in [0, pi] and gamma in [0, 2*pi] modulo the underlying
# Pauli-rotation periods), and pi/2 and pi are just midpoints of those
# ranges. For harder problems you would typically warm start from known
# good angles or transfer parameters from smaller instances.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_beta, initial_gamma, initial_gamma]
def cost_func_estimator(params, ansatz, hamiltonian, estimator):
    # transform the observable defined on virtual qubits to
    # an observable defined on all physical qubits
    isa_hamiltonian = hamiltonian.apply_layout(ansatz.layout)

    pub = (ansatz, isa_hamiltonian, params)
    job = estimator.run([pub])

    results = job.result()[0]
    cost = results.data.evs

    objective_func_vals.append(cost)

    return cost
objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    # If using qiskit-ibm-runtime<0.24.0, change `mode=` to `session=`
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit, cost_hamiltonian, estimator),
        method="COBYLA",
        tol=1e-2,
    )
    print(result)
message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -1.0164225323839062
       x: [ 1.404e+00  1.174e+00  4.036e+00  2.969e+00]
    nfev: 30
   maxcv: 0.0
Optimalizátoru se podařilo snížit náklady a najít lepší parametry pro Circuit.
Hladce klesající křivka, která se ustálí na plató, je charakteristickým znakem konvergence. Zašuměná, nemonotónní křivka obvykle naznačuje, že něco výše v procesu vyžaduje pozornost; běžnými příčinami jsou příliš málo shotů na vyhodnocení (vysoký rozptyl estimatoru), špatné počáteční parametry nebo Circuit, jehož hloubka je ovládána hardwarovým šumem. COBYLA nepoužívá derivace a je poměrně robustní vůči mírnému šumu, ale když šum zaplaví skutečná zlepšení nákladů na krok, jeho lineárně-aproximační model už nedokáže rozlišit skutečný sestup od náhodného chvění a optimalizátor začne bloudit.
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

Přiřaď optimalizované parametry a navzorkuj finální rozdělení pomocí primitiva Sampler.
optimized_circuit = candidate_circuit.assign_parameters(result.x)
optimized_circuit.draw("mpl", fold=False, idle_wires=False)

# If using qiskit-ibm-runtime<0.24.0, change `mode=` to `backend=`
sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit,)
job = sampler.run([pub], shots=int(1e4))
counts_int = job.result()[0].data.meas.get_int_counts()
counts_bin = job.result()[0].data.meas.get_counts()
shots = sum(counts_int.values())
final_distribution_int = {key: val / shots for key, val in counts_int.items()}
final_distribution_bin = {key: val / shots for key, val in counts_bin.items()}
print(final_distribution_int)
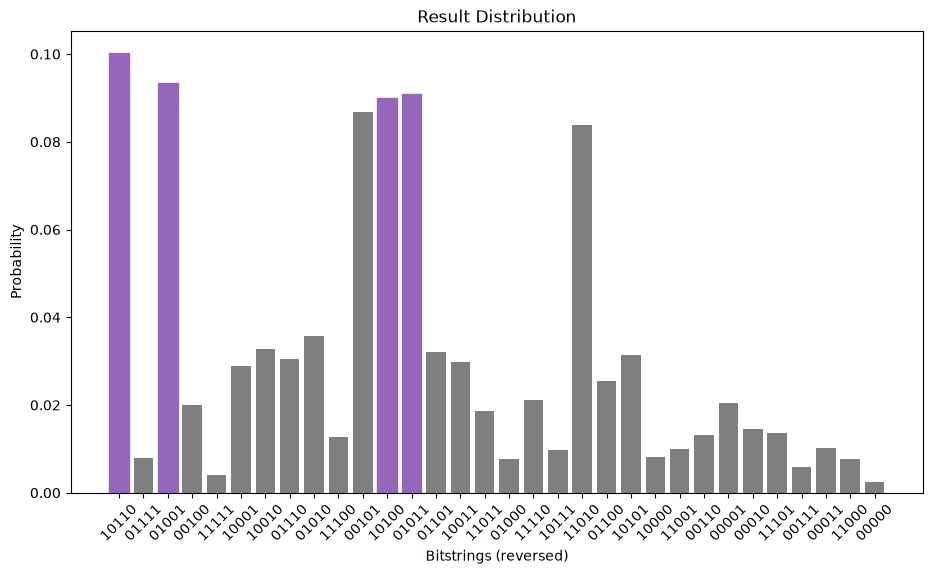
{22: 0.1003, 15: 0.008, 9: 0.0934, 4: 0.02, 31: 0.004, 17: 0.0288, 18: 0.0327, 14: 0.0305, 10: 0.0358, 28: 0.0128, 5: 0.0868, 20: 0.09, 11: 0.0908, 13: 0.0321, 19: 0.0298, 27: 0.0186, 8: 0.0077, 30: 0.0211, 23: 0.0098, 26: 0.0839, 12: 0.0254, 21: 0.0315, 16: 0.0082, 25: 0.01, 6: 0.0131, 1: 0.0205, 2: 0.0145, 29: 0.0137, 7: 0.0059, 3: 0.0101, 24: 0.0078, 0: 0.0024}
Krok 4: Následné zpracování a vrácení výsledku v požadovaném klasickém formátu
Extrahuj nejpravděpodobnější bitřetězec z navzorkovaného rozdělení. Ten reprezentuje nejlepší řez, který QAOA našel. Metoda interpret třídy Maxcut dekóduje bitřetězec na dvě množiny uzlů rozdělení.
# auxiliary functions to sample most likely bitstring
def to_bitstring(integer, num_bits):
    result = np.binary_repr(integer, width=num_bits)
    return [int(digit) for digit in result]

keys = list(final_distribution_int.keys())
values = list(final_distribution_int.values())
most_likely = keys[np.argmax(np.abs(values))]
most_likely_bitstring = to_bitstring(most_likely, len(graph))
most_likely_bitstring.reverse()

print("Result bitstring:", most_likely_bitstring)

partition = maxcut.interpret(np.array(most_likely_bitstring))
print("Partition:", partition)
Result bitstring: [0, 1, 1, 0, 1]
Partition: [[0, 3], [1, 2, 4]]
plt.rcParams.update({"font.size": 10})
final_bits = final_distribution_bin
values = np.abs(list(final_bits.values()))
top_4_values = sorted(values, reverse=True)[:4]
positions = []
for value in top_4_values:
    positions.append(np.where(values == value)[0])
fig = plt.figure(figsize=(11, 6))
ax = fig.add_subplot(1, 1, 1)
plt.xticks(rotation=45)
plt.title("Result Distribution")
plt.xlabel("Bitstrings (reversed)")
plt.ylabel("Probability")
ax.bar(list(final_bits.keys()), list(final_bits.values()), color="tab:grey")
for p in positions:
    ax.get_children()[int(p[0])].set_color("tab:purple")
plt.show()
Vizualizace nejlepšího řezu
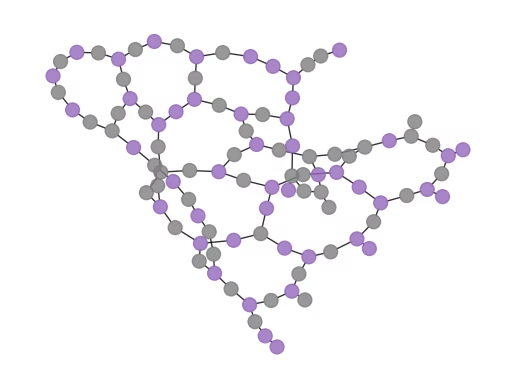
Z optimálního bitřetězce pak můžeš tento řez vizualizovat na původním grafu.
# auxiliary function to plot graphs
def plot_result(G, x):
    colors = ["tab:grey" if i == 0 else "tab:purple" for i in x]
    pos, _default_axes = rx.spring_layout(G), plt.axes(frameon=True)
    rx.visualization.mpl_draw(
        G, node_color=colors, node_size=100, alpha=0.8, pos=pos
    )

plot_result(graph, most_likely_bitstring)

Nyní spočítej hodnotu řezu. Cílem OptimizationProblem je přímo hodnota řezu, takže ji vyhodnoť přímo na bitřetězci. Můžeš ji také porovnat s hodnotou řezu odpovídající konečným nákladům optimalizátoru, , což je průměr přes celé navzorkované rozdělení, nikoli hodnota jednoho bitřetězce.
cut_value = maxcut_problem.objective.evaluate(np.array(most_likely_bitstring))
print("The value of the cut is:", cut_value)
print("Cut value implied by the optimized cost:", -(result.fun + offset))
The value of the cut is: 5.0
Cut value implied by the optimized cost: 4.016422532383906
Pro takto malý graf je skutečné optimum snadné získat hrubou silou, takže si můžeš výsledky ověřit porovnáním výsledku QAOA s přesnou odpovědí.
# Classical baseline: enumerate all 2**n_small bitstrings and take the best cut.
def brute_force_max_cut(problem) -> tuple[int, list[int]]:
    n = problem.get_num_vars()
    best_cut = -1
    best_x: list[int] = []
    for i in range(2**n):
        x = np.array([(i >> k) & 1 for k in range(n)])
        cut = problem.objective.evaluate(x)
        if cut > best_cut:
            best_cut = int(cut)
            best_x = x.tolist()
    return best_cut, best_x

classical_best, classical_x = brute_force_max_cut(maxcut_problem)
print(f"Classical optimum (brute force): {classical_best}")
print(f"QAOA cut value:                  {cut_value}")
Classical optimum (brute force): 5
QAOA cut value:                  5.0
Příklad na hardwaru ve velkém měřítku
Na IBM Quantum Platform máš přístup k mnoha zařízením s více než 100 Qubity. Vyber si jedno, na kterém vyřešíš max-cut na váhovaném grafu se 100 uzly. Jedná se o problém v "užitkové škále". Pracovní postup sleduje stejné kroky jako výše, aplikované na mnohem větší graf.
Kompletní pracovní postup v užitkové škále
Všechny čtyři kroky jsou ukázány níže, aplikované na graf se 100 uzly. Struktura je stejná jako u průvodce v malém měřítku: mapuj, transpiluj, spusť, po-zpracuj — ale s větším problémem a rozděleno do čtyř buněk níže pro přehlednost.
# Precomputed parity lookup table: _PARITY[b] = +1 if popcount(b) is even, else -1.
# We use this to vectorize expectation-value evaluation across all Pauli terms.
_PARITY = np.array(
    [-1 if bin(i).count("1") % 2 else 1 for i in range(256)],
    dtype=np.complex128,
)

def evaluate_sparse_pauli(state: int, observable: SparsePauliOp) -> complex:
    """Expectation value of a SparsePauliOp on a single computational-basis state.

    For a Z-only observable (which QAOA cost Hamiltonians are, after the
    QUBO-to-Hamiltonian mapping), the eigenvalue of each Pauli term on a
    computational-basis state is simply (-1)**popcount(z_mask AND state),
    i.e., the parity of the bitwise-AND of the term's Z-support and the
    measured bitstring.

    This routine packs the Z-support of every Pauli term into bytes, ANDs
    them against the measured state in a single vectorized op, and looks up
    the parity in _PARITY. For a 100-qubit / ~hundreds-of-terms Hamiltonian
    over 10_000 samples, this is dramatically faster than calling
    SparsePauliOp.expectation_value per sample.
    """
    packed_uint8 = np.packbits(observable.paulis.z, axis=1, bitorder="little")
    state_bytes = np.frombuffer(
        state.to_bytes(packed_uint8.shape[1], "little"), dtype=np.uint8
    )
    reduced = np.bitwise_xor.reduce(packed_uint8 & state_bytes, axis=1)
    return np.sum(observable.coeffs * _PARITY[reduced])

def best_solution(samples, hamiltonian):
    """Return the sampled bitstring (as int) with the lowest Hamiltonian cost."""
    min_cost = float("inf")
    min_sol = None
    for bit_str in samples.keys():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        if fval <= min_cost:
            min_cost = fval
            min_sol = candidate_sol
    return min_sol

def _plot_cdf(objective_values: dict, ax, color):
    x_vals = sorted(objective_values.keys(), reverse=True)
    y_vals = np.cumsum([objective_values[x] for x in x_vals])
    ax.plot(x_vals, y_vals, color=color)

def plot_cdf(dist, ax, title):
    _plot_cdf(dist, ax, "C1")
    ax.vlines(min(list(dist.keys())), 0, 1, "C1", linestyle="--")
    ax.set_title(title)
    ax.set_xlabel("Objective function value")
    ax.set_ylabel("Cumulative distribution function")
    ax.grid(alpha=0.3)

def samples_to_objective_values(samples, hamiltonian):
    """Convert the samples to values of the objective function."""
    objective_values = defaultdict(float)
    for bit_str, prob in samples.items():
        candidate_sol = int(bit_str)
        fval = evaluate_sparse_pauli(candidate_sol, hamiltonian).real
        objective_values[fval] += prob
    return objective_values
Krok 1: Sestav graf z mapy propojení Backendu, poté ho pomocí addonu Optimization Mapper zobraz na nákladový Hamiltonián a sestav ansatz.
# Step 1: build the 100-node graph, cost Hamiltonian, and QAOA ansatz.
n_large = 100
graph_100 = rx.PyGraph()
graph_100.add_nodes_from(np.arange(0, n_large, 1))
elist = set()
for u, v in backend.coupling_map:
    # The coupling map lists both directions of each coupler, so sort
    # the endpoints to avoid adding the same edge twice.
    if u < n_large and v < n_large:
        elist.add((min(u, v), max(u, v), 1.0))
graph_100.add_edges_from(sorted(elist))

maxcut_100 = Maxcut(graph_100)
maxcut_problem_100 = maxcut_100.to_optimization_problem()
qubo_100 = OptimizationProblemToQubo().convert(maxcut_problem_100)
cost_hamiltonian_100, offset_100 = to_ising(qubo_100)

circuit_100 = QAOAAnsatz(cost_operator=cost_hamiltonian_100, reps=1)
circuit_100.measure_all()
Krok 2: Transpiluj pro vybraný hardwarový Backend.
# Step 2: transpile for hardware.
pm = generate_preset_pass_manager(optimization_level=3, backend=backend)
candidate_circuit_100 = pm.run(circuit_100)
Krok 3: Spusť optimalizační smyčku QAOA uvnitř session a poté navzorkuj.
# Step 3: run the QAOA optimization loop on the device, then sample the
# final distribution with the optimized parameters.
initial_gamma = np.pi
initial_beta = np.pi / 2
init_params = [initial_beta, initial_gamma]

objective_func_vals = []  # Global variable
with Session(backend=backend) as session:
    estimator = Estimator(mode=session)
    estimator.options.default_shots = 1000

    # Set simple error suppression/mitigation options
    estimator.options.dynamical_decoupling.enable = True
    estimator.options.dynamical_decoupling.sequence_type = "XY4"
    estimator.options.twirling.enable_gates = True
    estimator.options.twirling.num_randomizations = "auto"
    estimator.options.environment.job_tags = ["TUT_QAOA"]

    result = minimize(
        cost_func_estimator,
        init_params,
        args=(candidate_circuit_100, cost_hamiltonian_100, estimator),
        method="COBYLA",
    )
    print(result)

# Assign optimal parameters and sample the final distribution.
optimized_circuit_100 = candidate_circuit_100.assign_parameters(result.x)

sampler = Sampler(mode=backend)
sampler.options.default_shots = 10000

# Set simple error suppression/mitigation options
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = "XY4"
sampler.options.twirling.enable_gates = True
sampler.options.twirling.num_randomizations = "auto"

# Add a unique tag to the job execution
sampler.options.environment.job_tags = ["TUT_QAOA"]

pub = (optimized_circuit_100,)
job = sampler.run([pub], shots=int(1e4))

counts_int = job.result()[0].data.meas.get_int_counts()
shots = sum(counts_int.values())
final_distribution_100_int = {
    key: val / shots for key, val in counts_int.items()
}
message: Return from COBYLA because the trust region radius reaches its lower bound.
 success: True
  status: 0
     fun: -4.214640355142735
       x: [ 2.586e+00  4.161e+00]
    nfev: 26
   maxcv: 0.0
Krok 4: Po-zpracuj navzorkované rozdělení k extrakci nejlepšího řezu.
# Step 4: find the best-cost sample and evaluate its cut value.
best_sol_100 = best_solution(final_distribution_100_int, cost_hamiltonian_100)
best_sol_bitstring_100 = to_bitstring(int(best_sol_100), len(graph_100))
best_sol_bitstring_100.reverse()

print("Result bitstring:", best_sol_bitstring_100)

cut_value_100 = maxcut_problem_100.objective.evaluate(
    np.array(best_sol_bitstring_100)
)
print("The value of the cut is:", cut_value_100)
Result bitstring: [1, 0, 0, 1, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 0, 1, 1, 1, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 0, 0, 0, 1, 0, 0, 1, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 1, 0, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 1, 1, 0, 1]
The value of the cut is: 78.0
Zkontroluj, že náklady minimalizované v optimalizační smyčce zkonvergovaly, a vizualizuj výsledky.
# Plot convergence
plt.figure(figsize=(12, 6))
plt.plot(objective_func_vals)
plt.xlabel("Iteration")
plt.ylabel("Cost")
plt.show()

# Visualize the cut
plot_result(graph_100, best_sol_bitstring_100)

# Plot cumulative distribution function
result_dist = samples_to_objective_values(
    final_distribution_100_int, cost_hamiltonian_100
)
fig, ax = plt.subplots(1, 1, figsize=(8, 6))
plot_cdf(result_dist, ax, backend.name)


Další kroky
Pokud tě tato práce zaujala, mohly by tě zajímat následující materiály:
- Pokročilé techniky pro QAOA — zkoumá pokročilé strategie pro zlepšení výkonu QAOA
- Výzva vícekriteriální optimalizace — vyzkoušej své dovednosti na této komunitní výzvě o vícekriteriální kvantové optimalizaci
- Dokumentace k transpilaci pro doladění optimalizace Circuit
- Potlačení a zmírnění chyb pro zlepšení výsledků na hardwaru