Rimay Quantum Feature Extraction - Qiskit Function od Kipu Quantum
Qiskit Functions jsou experimentální funkce dostupná pouze uživatelům plánů IBM Quantum® Premium Plan, Flex Plan a On-Prem (prostřednictvím IBM Quantum Platform API). Jsou ve stavu náhledového vydání a mohou se změnit.
Přehled
Rimay doplňuje klasické pipeline strojového učení o příznaky generované na kvantovém hardwaru. Funkce přijímá klasická tabulková data a vrací sadu kvantově transformovaných příznaků. Když kvantový systém data zpracuje, vygeneruje bohaté příznaky, které zachycují nelineární vztahy mezi vstupy. Vygenerované příznaky můžeš použít samostatně, nebo v kombinaci s původními příznaky k trénování libovolného klasického modelu. Na malých a středně velkých datasetech mohou kvantově transformované příznaky zlepšit kvalitu predikce oproti čistě klasickým referenčním modelům.
Tato funkce je určena pro následující uživatele:
-
Týmy datové vědy s existující pipeline strojového učení nad malými a středně velkými tabulkovými datasety, u kterých kvalita predikce stagnuje. Rimay přidáš jako jeden další krok předzpracování, aniž bys sám vytvářel jakékoli kvantové obvody.
-
Výzkumníky, kteří zkoumají kvantové metody pro úlohy strojového učení.
Popis
Algoritmus kvantové extrakce příznaků [1] kombinuje dva principy kvantového strojového učení. Prvním jsou kvantové mapy příznaků (feature maps), které vkládají data do vysokodimenzionálního Hilbertova prostoru, a vytvářejí tak expresivnější reprezentace. Druhým je kvantové reservoir computing, které využívá dynamiku kvantového mnohočásticového systému jako nelineární transformaci vstupu.
Rimay zakóduje hodnoty příznaků a vzájemnou informaci mezi příznaky do lokálních polí a vazebných koeficientů hamiltoniánu spinového skla. Kontradiabatická kvantová dynamika vyvíjí systém směrem k jeho stavům s nízkou energií, které obsahují nelineární směsi korelací ve vstupních datech. Rimay tyto korelace extrahuje měřením jedno- a dvoučásticových očekávaných hodnot. Očekávané hodnoty jsou kvantově transformované příznaky, které předáš svému modelu strojového učení.
Pracovní postup
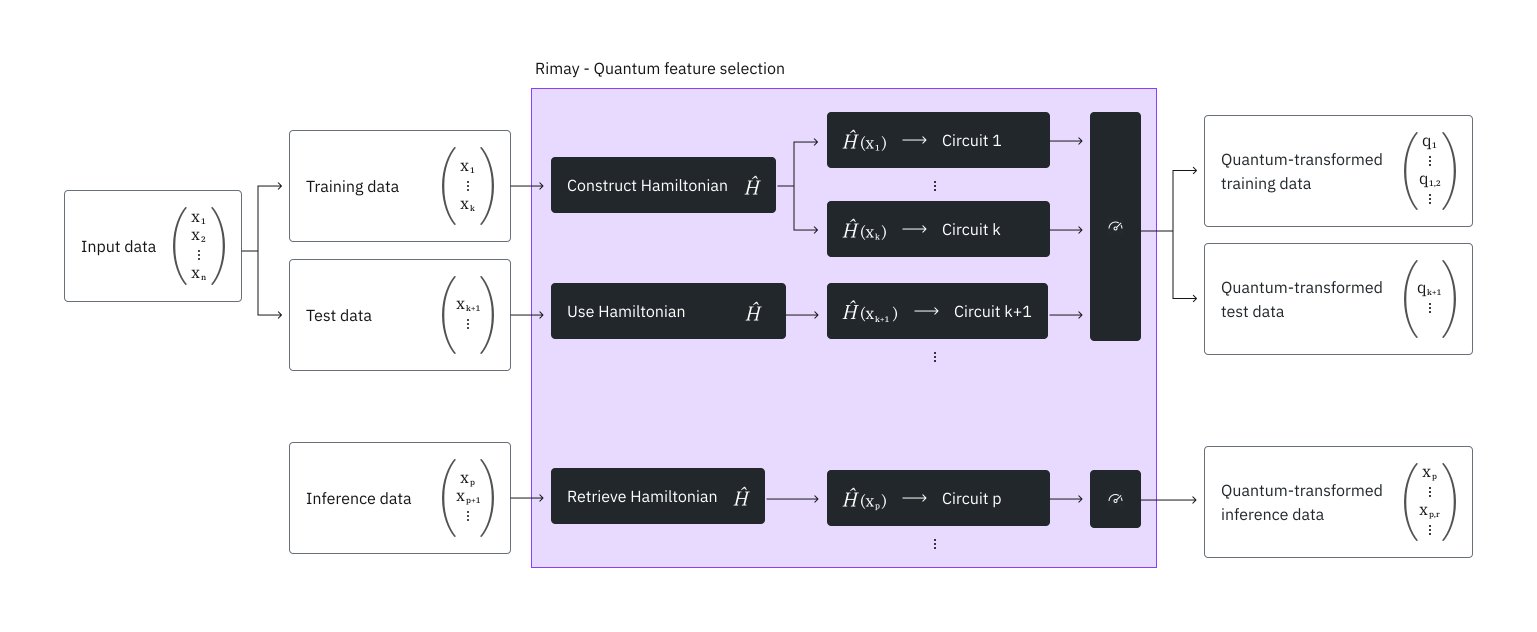
-
Předzpracuj tabulková data stejně jako pro klasické strojové učení. Rimay potřebuje číselné příznaky, proto převeď kategoriální příznaky na číselné, například pomocí
OneHotEncoderze scikit-learn. -
Rozděl data na trénovací a testovací sadu a obě nahraj do funkce, jak ukazuje sekce Příklad.
-
Rimay použije trénovací data k sestavení hamiltoniánu, který data reprezentuje. Každý příznak odpovídá jednomu qubitu a celá trénovací sada rozhoduje o tom, které příznaky, a tedy které qubity, spolu interagují. Rimay tuto strukturu uloží, aby testovací a pozdější inferenční data mapoval stejným hamiltoniánem.
-
Pro každý vzorek nastavují hodnoty příznaků lokální pole hamiltoniánu a vzájemná informace mezi příznaky nastavuje vazebné koeficienty struktury z kroku 3. Rimay digitalizuje kontradiabatický vývoj tohoto hamiltoniánu do obvodu a obvody spustí na QPU.
-
Rimay změří výsledné bitové řetězce a poté vypočítá jednočásticové očekávané hodnoty a dvoučásticové očekávané hodnoty fyzicky propojených qubitů.
-
Očekávané hodnoty si stáhneš ve formě, kterou můžeš přímo předat svému modelu nebo zkombinovat s původními příznaky.
Kvůli této struktuře se počet qubitů, které běh potřebuje, rovná počtu příznaků a počet obvodů, které odešle, se rovná počtu vzorků.
Po natrénování (fit) mapování můžeš jeho prostřednictvím mapovat nová data, například pro inferenci. Rimay poté načte hamiltonián, který vytvořil během fitu, a z něj sestaví obvody pro nové vzorky.
Začleň Rimay do své pipeline strojového učení
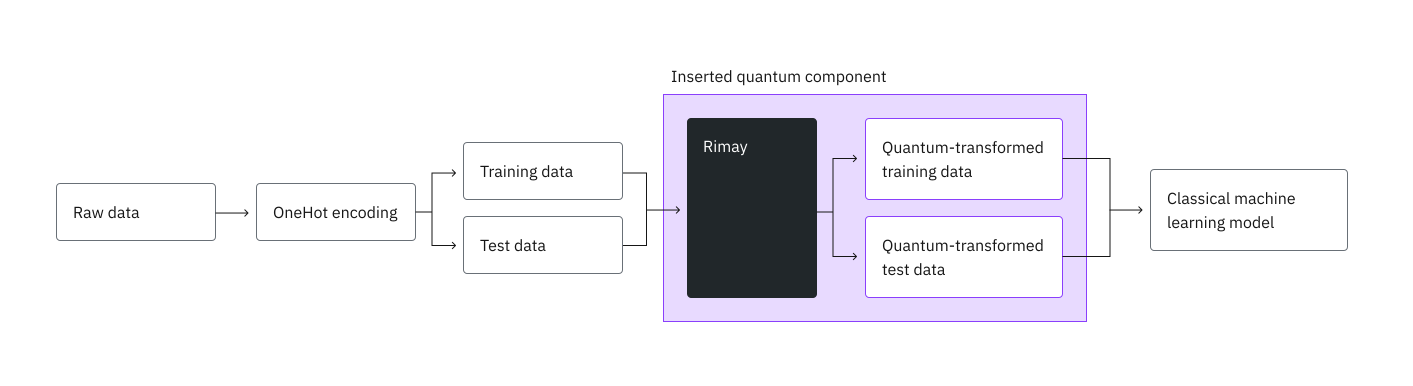
Stejně jako v klasické pipeline nejprve předzpracuješ surová data, například one-hot kódováním kategoriálních příznaků, a rozdělíš je na trénovací a testovací sadu. Místo abys obě sady předával přímo svému modelu, předáš je nejdřív Rimay a svůj model trénuješ na kvantově transformovaných příznacích.
Benchmarky
Kipu Quantum otestovala Rimay na datasetu German credit z OpenML [2], který klasifikuje 1000 žadatelů o úvěr jako dobré nebo špatné úvěrové riziko. Obsahuje 13 kategoriálních a sedm numerických atributů. One-hot kódování kategoriálních atributů vede k 48 numerickým příznakům. Benchmark ponechává 20 % vzorků jako testovací sadu.
Jako základ bylo natrénováno několik klasických modelů na klasických příznacích. S Rimay byl náhodný les (random forest) natrénován dvěma způsoby: pouze na kvantově transformovaných příznacích (Random forest Q) a na kvantově transformovaných příznacích zkombinovaných s klasickými (Random forest H, jako hybridní). Tabulka uvádí pouze náhodný les, protože na kvantově transformovaných příznacích dosáhl nejlepších výsledků.
| Model | Příznaky | Přesnost (Accuracy) | AUC | F1 skóre | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Klasické | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Klasické | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Klasické | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Klasické | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Kvantové | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybridní | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Hybridní příznaky zlepšují všechny metriky náhodného lesa kromě precision a hybridní náhodný les dosahuje vyšší AUC, F1 skóre a recall než CatBoost na klasických příznacích. Největší efekt je na recall, který stoupne z 0.921 na 0.957. Samotné kvantově transformované příznaky nedosahují precision klasických modelů.
Testovací sada obsahuje pouze 200 vzorků, takže správná predikce jednoho dalšího vzorku posune přesnost o 0.005. Rozdíly chápej jako trend, který vyžaduje další ověření, nikoli jako významný efekt. Přesnost predikce může také záviset na šumu extrahovaných příznaků způsobeném hardwarem. Proto používej dostatek shotů, aby výsledek neomezoval shot noise.
Benchmark použil následující prostředky:
| Příklad | Počet qubitů | Počet vzorků | Počet shotů | Celkový čas (min) | Využití QPU (min) | Procesor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Počet vzorků, který je zároveň počtem obvodů, určuje čas na QPU. Použij typ procesoru Nighthawk r2, protože výrazně snižuje potřebný čas na QPU.
Vstupy
Parametr mode určuje, které parametry běh potřebuje. Popis každého vstupního parametru najdeš v referenční příručce API.
Vstupní soubory
-
Každý soubor nahraj pomocí
catalog.file_upload()před spuštěním funkce. -
Nahrání nahradí jakýkoli dřívější soubor se stejným názvem, a to i pro úlohu, kterou jsi odeslal, ale která ještě nezačala. Chceš-li spustit několik úloh současně, dej souborům každé úlohy vlastní názvy, například
run1_x_train.csvarun2_x_train.csv. -
Každý soubor je soubor CSV s řádkem záhlaví. Každý sloupec souboru příznaků je jeden příznak a každá hodnota musí být číselná.
-
y_trainobsahuje přesně jeden číselný sloupec, s jednou značkou (label) na každý řádekx_train. Kategoriální značky namapuj na čísla, například dobrý a špatný na 1 a 0. -
x_testax_inferencemusí mít stejné sloupce jakox_train, ve stejném pořadí.
mapping_id je jediný způsob, jak se dostat k mapování, které tvůj fit vytvořil, a nelze jej dohledat ani obnovit. Opravňuje k použití tohoto mapování, proto s ním zacházej jako s přihlašovacím údajem a nesdílej ho. Pokud ho ztratíš, musíš natrénovat nové mapování, což stojí další běh na kvantovém hardwaru. Zaznamenej si také backend_name použitý při fitu, protože mapování běží pouze na tomto procesoru.
Limity
-
Každý příznak je mapován na jeden qubit, takže procesor musí mít alespoň tolik qubitů, kolik má tvoje data příznaků. Pokud máš příznaků více, nejprve je omez technikou výběru příznaků.
-
Každý vzorek se stane jedním obvodem a běh počítá trénovací a testovací vzorky dohromady. Jeden běh může obsahovat nejvýše 15 000 vzorků.
-
Jedna úloha může požadovat nejvýše 10 milionů provedení, takže počet vzorků krát
shotsnesmí překročit 10 milionů. -
Úloha musí skončit do 24 hodin, včetně doby, kterou její obvody čekají ve frontě procesoru. Úloha, která běží déle, je zastavena bez výsledku. Na vytíženém procesoru držej velké datasety výrazně pod těmito limity.
Výstupy
job.result() vrací slovník. Samotné kvantově transformované příznaky se zapisují do souborů CSV, které stáhneš pomocí catalog.file_download(). Popis každého klíče slovníku najdeš v referenční příručce API. Čas, který zabrala každá fáze provádění, najdeš v části Metadata běhu.
Každý výstupní soubor obsahuje jeden řádek na každý vstupní řádek, v pořadí vstupního souboru, a jeden sloupec na každý kvantově transformovaný příznak. Sloupce, jejichž názvy začínají corr_, jsou dvoučásticové očekávané hodnoty. Soubory neobsahují sloupec se značkami. Značky tvých trénovacích dat zůstávají v tvém souboru y_train.
Metadata běhu
resource_usage obsahuje jednu položku pro každou fázi provádění, kterou běh prošel: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" a na QPU obvykle "RUNNING: WAITING_FOR_QPU". Každá položka obsahuje CPU_TIME, tedy reálný čas fáze v sekundách, a QPU_TIME, tedy čas QPU v sekundách. Na QPU je čas QPU, který IBM vyúčtovala, zaznamenán pod "RUNNING: MAPPING", tedy ve fázi, ve které se obvody spouštěly.
"RUNNING: WAITING_FOR_QPU" je doba, po kterou tvoje úlohy čekaly ve frontě IBM. Běh tento čas přebírá z časových razítek úloh IBM a nezapočítává ho do "RUNNING: MAPPING". Pokud IBM tato časová razítka nenahlásí pro každou úlohu, položka chybí a čekání je součástí "RUNNING: MAPPING".
IBM® dokončí výpočet využití až nějakou dobu po skončení úlohy. Běh na něj čeká až přibližně minutu. Využití, které se po této době stále počítá, není zahrnuto v QPU_TIME a konečné využití se zobrazí na IBM Quantum Platform. Pokud běh nemůže využití od IBM přečíst, je QPU_TIME rovno None.
Například:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Začínáme
Autentizuj se pomocí svého API klíče IBM Quantum Platform a vyber Qiskit Function následujícím způsobem:
Následující kód předpokládá, že sis uložil své přihlašovací údaje. Pokud ne, postupuj podle pokynů v části Instalace klienta Qiskit Functions Catalog a ulož svůj účet pomocí API klíče.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Velikosti funkce
Každá úloha běží v jedné velikosti — S, M nebo L. Pokud je zadaná velikost příliš malá, úloha je zamítnuta. Pokud je velikost větší, než je potřeba, úloha běží na větším výpočetním profilu, než práce vyžaduje.
Velikost úlohy Rimay závisí na počtu vzorků, které mapuje: řádky x_train a x_test pro fit-transform a řádky x_inference pro transform. Značky v y_train se nepočítají a běh delete nemapuje žádné vzorky.
| Velikost | Vzorků na úlohu | Výpočetní profil | vCPU | RAM |
|---|---|---|---|---|
S | Do 2 999 | 8x32 | 8 | 32 GB |
M | 3 000 až 9 999 | 8x32 | 8 | 32 GB |
L | 10 000 až 15 000 | 16x128 | 16 | 128 GB |
Počet vzorků je jediné kritérium. Velikost nemění nic kromě výpočetního profilu: limity pro příznaky, vzorky a shoty jsou pro každou velikost stejné. S a M běží na stejném výpočetním profilu a liší se počtem vzorků, který každá pokrývá.
Výchozí je M, použije se, když úloha nepožaduje velikost. Úloha s více než 9 999 vzorky proto musí požadovat L.
Mapování si také můžeš přečíst přímo z funkce pomocí rimay.sizes_map a velikost, ve které úloha běží, když žádnou nepožaduje, pomocí rimay.default_size.
Výpočet velikosti před odesláním
Spusť to na svých vlastních vstupech. Pouze je přečte a nic jiného nedělá: neodešle se žádná úloha a nic se nerezervuje, takže to můžeš volat, jak často chceš.
Předej samotné datasety, ne názvy jejich souborů, ve stejném pořadí jako v input_file, spolu s mode běhu. Volání ukazuje krok 2 příkladu.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Pokud je velikost příliš malá, úloha selže s chybou 4600 a zpráva uvede velikost, kterou použít místo ní. Pokud je větší, než je potřeba, úloha proběhne normálně a zaznamená poradní událost 4601.
Příklad
Tento příklad ukazuje, jak nahrát data, spustit funkci a získat kvantově transformované příznaky. Kompletní příklad včetně předzpracování a trénování klasického modelu najdeš v tutoriálu.
1. Nahrání dat
Tento příklad používá malý syntetický dataset se čtyřmi číselnými příznaky a binární značkou, takže běh potřebuje jen čtyři qubity a skončí rychle. Následující buňka jej zapíše do čtyř souborů CSV: trénovací příznaky, trénovací značky, testovací příznaky a příznaky pro krok 4 tohoto příkladu. Chceš-li použít vlastní data, zapiš místo toho své předzpracované trénovací a testovací sady do souborů se stejným rozvržením.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Nahraj trénovací a testovací soubory. Soubor x_inference.csv nahraješ v kroku 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Spuštění funkce
Vypočítej velikost běhu z dat, která jsi nahrál, pomocí kalkulátoru z Velikosti funkce.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Vyber procesor s alespoň tolika qubity, kolik mají tvoje data příznaků, a spusť funkci v režimu fit-transform s touto velikostí. Ukázková data mají čtyři příznaky, takže je může spustit libovolný procesor IBM Quantum.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Zkontroluj stav úlohy nebo získej výsledky následujícím způsobem:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Získání výsledků
Stáhni kvantově transformované příznaky. Předej target_name, aby se každý soubor uložil pod vlastním názvem.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Mapování nových dat
Po natrénování modelu namapuj nová data pomocí natrénovaného mapování, například pro inferenci. Tento příklad mapuje x_inference.csv, který zapsala první buňka tohoto příkladu. Předej mapping_id, které vrátil fit, aby se nové řádky mapovaly stejným mapováním místo nového.
Mapování je sestaveno pro rozvržení qubitů jednoho procesoru, proto předej stejný backend_name jako při fitu, který fit vrátil v result["backend_name"]. K výběru procesoru nepoužívej least_busy(), protože může vrátit jiný. Rimay odmítne jakýkoli jiný procesor dříve, než cokoli odešle. Počet shotů také pochází z fitu.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Smazání mapování
Když natrénované mapování už nepotřebuješ, smaž ho. Běh delete nedělá žádnou kvantovou práci, takže nepotřebuje procesor, shoty ani velikost funkce. Smazání nelze vrátit zpět. Po smazání se mapping_id už na nic neodkazuje a běh transform s ním selže.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Získání chybových zpráv
Pokud je stav tvé úlohy ERROR, získej chybovou zprávu pomocí job.error_message() následujícím způsobem:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Každá chyba, kterou Rimay hlásí, nese kód z chybových kódů IBM Quantum, zprávu a řešení, které uvádí hodnotu, kterou jsi předal, a hodnotu, která je povolena. Následující tabulka uvádí nejčastější chyby:
| Kód | Příčina |
|---|---|
1221 | Chybí parametr nebo má špatný typ, mode není platný, soubor uvedený v input_file nebyl nahrán, soubory si navzájem neodpovídají, příznak není číselný nebo mapping_id neodpovídá uloženému mapování. |
1221 | Běh "transform" uvádí jiný backend_name než fit, který vytvořil jeho mapování. |
1216 | Tvoje instance nemá procesor s backend_name, který jsi předal. Řešení uvádí procesory, které má. |
1200 | Tvůj API klíč nemá přístup k instanci, pod kterou úloha běží. |
3200 | backend_name nezačíná na ibm_. |
4500 | Data mají více příznaků, než má procesor qubitů. |
6000 | Počet vzorků krát shots překračuje 10 milionů provedení. |
6001 | shots je menší než 1. |
6002 | Data mají více vzorků, než běh umožňuje. |
Případy použití
Při klasifikaci tabulkových dat na malých a středně velkých datasetech použila Kipu Quantum kvantovou extrakci příznaků v následujících oblastech:
Mimo tabulková data mohou zmrazené neuronové sítě transformovat obrázky na numerické příznaky, které kvantová extrakce příznaků následně mapuje na kvantově transformované příznaky:
Získání podpory
Podporu získáš na support@kipu-quantum.com.
Další kroky
-
Navštiv referenční příručku API této Qiskit Function.
-
Vyzkoušej tutoriál Klasifikace úvěrového rizika pomocí kvantové extrakce příznaků Rimay od Kipu Quantum.
Reference
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Další informace
Rimay je slovo z kečuánštiny, které znamená „vysvětlovat“.