Parity Twine Optimizer: Qiskit Function od společnosti ParityQC
Qiskit Functions jsou experimentální funkce dostupné pouze uživatelům plánů IBM Quantum® Premium Plan, Flex Plan a On-Prem (přes IBM Quantum Platform API). Nacházejí se ve stavu preview release a mohou se měnit.
Přehled
Parity Twine Optimizer umožňuje uživatelům řešit optimalizační úlohy na kvantových počítačích pomocí metody Parity Twine. Tento přístup, postavený na Parity Architecture, používá kompilátor ParityQC k minimalizaci počtu hradel a hloubky obvodu potřebných ke spuštění kvantového algoritmu při zohlednění konektivity zařízení.
Toto snížení nároků na zdroje umožňuje řešit prakticky relevantní optimalizační úlohy o velikostech, které jsou neproveditelné pomocí standardních, na SWAP hradla náročných transpilačních metod. Parity Twine Optimizer automatizuje kroky transpilace a lze jej použít s minimálním vstupem od uživatele.
Přístup Parity Twine překonává všechny ostatní kompilační metody z hlediska snížení počtu hradel a hloubky obvodu pro kvantové algoritmy, jako je quantum approximate optimization algorithm (QAOA) a quantum Fourier transform (QFT). Odstíněním kvantové informace od fyzických qubitů jsou nelokální interakce implementovány bez SWAP hradel. Místo toho řetězce Parity Twine (sekvence hradel CNOT) systematicky distribuují logickou paritní informaci mezi qubity.
Optimalizátor používá QAOA k minimalizaci energie dané účelové (nákladové) funkce. QAOA je hybridní kvantově-klasický variační algoritmus navržený k řešení kombinatorických optimalizačních úloh aproximací základního stavu nákladového hamiltoniánu (). Mixovací člen () řídí přechody mezi stavy za účelem prozkoumání prostoru řešení. Střídavá sekvence těchto členů, řízená parametry a , definuje unitární operátor , který působí na počáteční stav.
Kódování unitárního operátoru úlohy, exp(), vyžaduje kódování všech logických -tělesových rotačních operátorů (exp()). Toho lze dosáhnout pomocí -tělesových generátorů (sítí Parity Twine), které snižují hloubku obvodu QAOA a počet dvouqubitových hradel.
Popis
Vstupem nástroje Parity Twine Optimizer je optimalizační úloha, název zvoleného hardwaru IBM Quantum a další volitelné argumenty pro přizpůsobení nastavení transpilace a spuštění na hardwaru. Optimalizační funkce předá definici úlohy kompilátoru Parity Twine Compiler. Obrázek 1 ukazuje shrnutí pracovního postupu funkce.
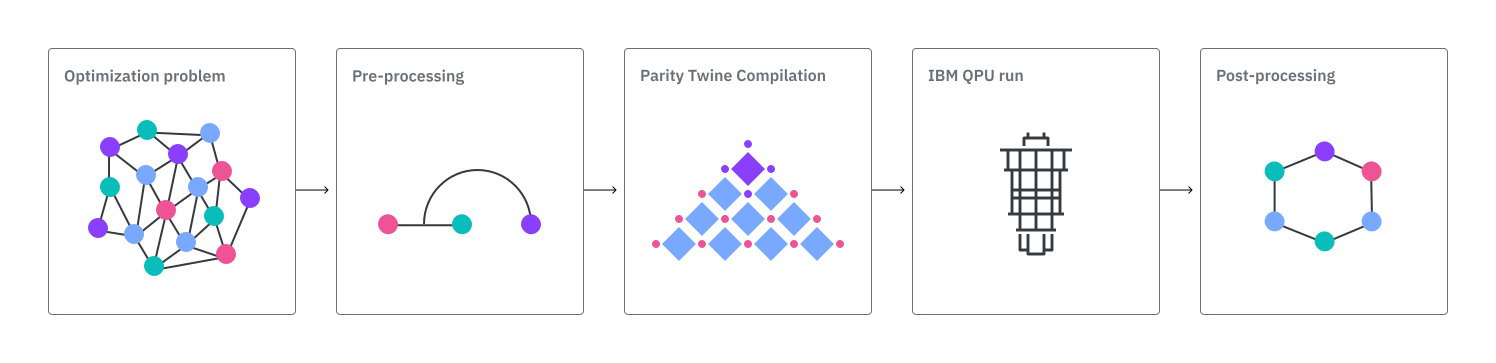
Vstupní optimalizační úloha je předzpracována do (normalizovaného) hamiltoniánu. Kompilátor ParityQC poté sestaví parametrizovaný ansatz obvod Parity Twine, který je transpilován na logický ansatz odpovídající nativní sadě hradel zvoleného hardwaru.
Parametry obvodu QAOA jsou klasicky optimalizovány pomocí přístupu "efficient depth one" a přiřazeny k transpilovanému obvodu. Protože se používá jedno kolo QAOA, optimální parametry a se získávají pomocí prohledávání mřížky (grid search) na CPU bez nutnosti nákladné iterativní optimalizace přes mnoho volání obvodu. Tím se výrazně minimalizuje potřebná doba běhu optimalizátoru na QPU. Doba spuštění na obvod je z velké části dána konstantní režií spuštění úlohy na QPU. S nastavenými parametry obvodu je úloha odeslána na zadané QPU IBM®.
Surové výsledky se poté dále zpracují (post-processing). Tento krok používá lokální hladové (greedy) vyhledávání, které náhodně prochází řetězec řešení a mění hodnoty bitů, pokud to sníží hodnotu nákladové funkce.
Benchmarky
Výkon může záviset jak na konkrétní instanci úlohy, tak na následných zpracovatelských krocích. V některých případech mohou klasické vzorky a kvantově generované vzorky po ekvivalentním post-processingu dosáhnout podobné konečné kvality řešení. Hodnocení by proto mělo zohledňovat celý optimalizační pracovní postup.
Model Sherrington-Kirkpatrick
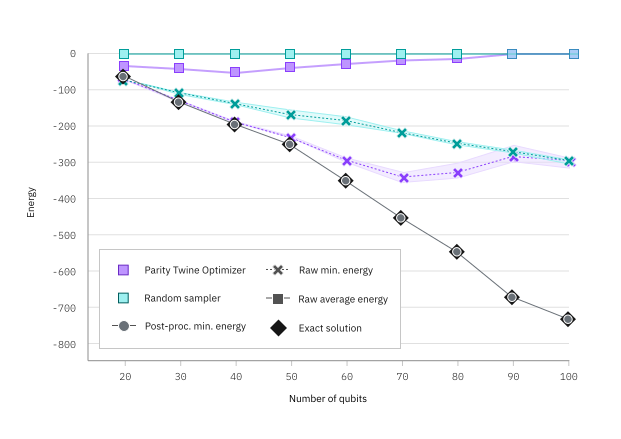
Obrázek 2 demonstruje účinnost nástroje Parity Twine Optimizer. Porovnává výsledky získané pomocí optimalizátoru s náhodným vzorkováním pro model Sherrington-Kirkpatrick se zvyšujícím se počtem qubitů.
Post-processing jak náhodných, tak výsledků optimalizátoru vede k přesným základním stavům, ale surový výstup minimální energie z Twine QAOA je vždy lepší než náhodné hodnoty. Pro největší uvažované počty qubitů (90 a 100) šum hardwaru degraduje výsledek optimalizátoru natolik, že se vrací k surovým hodnotám odpovídajícím náhodnému vzorkování.
Viz tento tutoriál pro úvod do modelu Sherrington-Kirkpatrick a podrobnosti, jak jej řešit pomocí nástroje Parity Twine Optimizer.
Úloha Market Split
Tabulka 1 ukazuje konkrétní výkonnostní metriky nástroje Parity Twine Optimizer aplikovaného na různé instance úlohy Market Split (MS). Ty byly získány z QOBLIB - Quantum Optimization Benchmarking Library a odpovídají příspěvkům zaslaným do knihovny pomocí nástroje Parity Twine Optimizer.
MS violation je metrika přesnosti, která měří, jak daleko je řešení od splnění všech omezení, definovaná jako . Nižší hodnoty této metriky značí přesnější řešení.
Tabulka 1 uvádí zprůměrované hodnoty z pěti běhů každé instance s použitím nástroje Parity Twine Optimizer se zařízením ibm_boston jako backendem a 100 000 shoty.
Uvádí se minimální hodnota MS violation získaná z běhů dané instance.
| Instance | Qubity | Dvoukubitová hradla | Dvoukubitová hloubka | MS violation | Doba mapování (s) | Doba běhu QPU (s) | Doba post-processingu (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tabulka 1: Výkonnostní metriky pro různé instance úlohy Market Split. Názvy instancí odpovídají příslušným příkladům v knihovně úloh QOBLIB. Jak již bylo zmíněno v části Popis, doba běhu QPU je minimální a téměř konstantní, protože se používá pouze jedno kolo QAOA s optimálními parametry obvodu získanými na CPU.
Viz tento tutoriál pro úvod do úlohy Market Split a podrobnosti, jak ji řešit pomocí nástroje Parity Twine Optimizer.
Úloha Maximum Independent Set
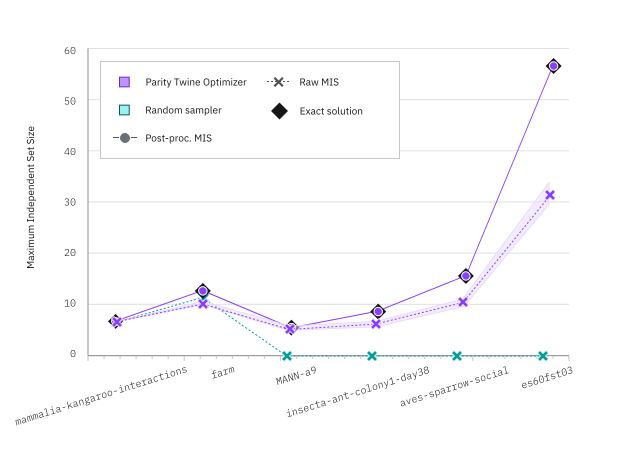
Obrázek 3 porovnává výsledky získané pomocí optimalizátoru Parity Twine s náhodným vzorkováním pro úlohu maximum independent set u vybraných instancí získaných z QOBLIB - Quantum Optimization Benchmarking Library. Tyto instance mají rozsah od 18 (mammalia-kangaroo-interactions) do 114 (es60fst03) qubitů.
U malých instancí jsou surové výsledky velikosti Maximum Independent Set z optimalizátoru a náhodného vzorkování podobné, ale u větších instancí dává optimalizátor mnohem lepší výsledky. Post-processing výsledků z náhodného vzorkování i z optimalizátoru opět vede k velikostem množin shodným s přesnými hodnotami.
Začínáme
Autentizuj se pomocí svého API tokenu IBM Quantum Platform a vyber Qiskit Function takto:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Příklad
Nástroj Parity Twine Optimizer lze aplikovat na jednoduchý příklad QUBO následujícím způsobem. Úloha je nejprve definována pomocí slovníku:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Poté je třeba definovat typ proměnné jako binary nebo spin:
variable_type = "spin"
Tím se definuje účelová funkce , kde .
Vyber backend. Například:
backend_name = "ibm_phoenix"
Pomocí catalog.backends() zobrazíš seznam dostupných backendů z uživatelského účtu/instance.
Pokud není zadán žádný backend, automaticky se vybere nejméně vytížený backend (ten s nejmenším počtem čekajících úloh).
Jakmile je optimalizátor načten (viz výše), můžeš jej spustit na úloze s výchozími možnostmi:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Stav úlohy zkontroluješ takto:
# Monitor the job status
function_job.status()
Výsledky získáš takto:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Po vypsání výsledků dostaneš:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Slovník solution odpovídá qubitům definovaným v úloze ( a ) a udává jejich optimalizované spinové hodnoty.
objective_value je náklad nebo energie optimalizační úlohy. Kvantifikuje kvalitu solution.
metadata poskytuje informace o transpilaci (počty/hloubka dvouqubitových hradel, použitá hradla, aktivní qubity) a různé doby běhu jak kvantového, tak klasického výpočetního času.
Navíc metadata poskytuje náhled do vnitřního fungování algoritmu. Můžeš vidět optimalizované variační parametry (beta a gamma) a zkontrolovat, jak se rozdělení naměřených bitových řetězců zlepšilo po aplikaci klasického post-processingu na surové kvantové výsledky.
Všechny bitové řetězce ve výstupu výsledku lze namapovat na proměnné úlohy pomocí variable_mapping.
Například 'solution_bitstring': '100' můžeš pomocí 'variable_mapping': {'0': 0, '1': 1, '2': 2} namapovat na binární řešení: {'0': 1, '1': 0, '2': 0}.
Protože úlohu řešíš ve spinových proměnných, musíš aplikovat transformaci z binárních na spinové hodnoty (0 -> 1, 1 -> -1 ).
Poté dojdeš k finálnímu řešení 'solution': {'0': -1, '1': 1, '2': 1}.
Podrobnosti o vstupu a výstupu funkce Parity Twine Optimizer najdeš v referenční příručce API.
Seznam změn
[1.0.2] - 2026-09-15
Notes
Toto vydání představuje první stabilní produkční verzi Qiskit Function Parity Twine Optimizer. Od budoucích vydání se očekává, že přinesou následující:
- kompilaci úloh vyššího řádu,
- další optimalizační algoritmy a
- vylepšení v pre- a post-processingu.
Funkce
- Řešení řídkých a hustých úloh QUBO pomocí efektivního kompilátoru Parity Twine Compiler.
Dokumentace
- Uživatelská příručka pro začátek práce.
- Tutoriály s příklady pro úlohy Market Split a Sherrington-Kirkpatrick.
- Dokumentace API.
Získej podporu
S jakýmikoli dotazy nebo problémy kontaktuj ParityQC.
Další kroky
- Požádej o přístup k této funkci vyplněním tohoto formuláře.
- Navštiv referenční příručku API pro tuto Qiskit Function.
- Vyzkoušej tutoriál pro použití Parity Twine Optimizer na úlohu Market Split.
- Vyzkoušej tutoriál pro použití Parity Twine Optimizer na model Sherrington-Kirkpatrick.
- Projdi si preprint Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025) na ArXiv.