Klasifikace úvěrového rizika pomocí Kipu Quantum Rimay Quantum Feature Extraction
Qiskit Functions jsou experimentální funkce dostupná pouze uživatelům plánů IBM Quantum® Premium Plan, Flex Plan a On-Prem (přes IBM Quantum Platform API) Plan. Jsou ve stavu předběžného vydání (preview) a mohou se změnit.
Odhad využití: 2 minuty na procesoru Nighthawk r2. (POZNÁMKA: Jde pouze o odhad. Skutečná doba běhu se může lišit.)
Výsledky učení
-
Připrav tabulková data s kategoriálními a numerickými sloupci pro Qiskit Function Rimay.
-
Natrénuj kvantové mapování příznaků na trénovacích datech a v tomtéž běhu namapuj testovací data.
-
Trénuj klasické modely na kvantově transformovaných příznacích, samotných i v kombinaci s původními příznaky.
-
Porovnej výsledky s čistě klasickým základním modelem.
Předpoklady
Než začneš s tímto tutoriálem, měl/a bys být obeznámen/a s následujícími tématy:
-
Klasifikace s učitelem pomocí scikit-learn
Pozadí
Mnoho problémů strojového učení v průmyslu pracuje s malými nebo středně velkými tabulkovými datovými sadami, kde přidání dalších dat není možné a přesnost modelu stagnuje. Typickým příkladem je hodnocení úvěrového rizika. Věřitel používá několik desítek atributů, aby rozhodl, zda žadatel úvěr pravděpodobně splatí.
Rimay, Qiskit Function od společnosti Kipu Quantum, přidává do takového pipeline krok kvantového předzpracování. Implementuje algoritmus digitalizované kontradiabatické kvantové extrakce příznaků [1]. Každý vstupní příznak se mapuje na jeden qubit. Hodnoty příznaků a vzájemná informace mezi příznaky určují lokální pole a vazby Hamiltoniánu spinového skla. Kontradiabatická dynamika pak vyvíjí kvantový systém směrem k jeho stavům s nízkou energií a jedno- a dvoučásticové střední hodnoty změřené na konci se stávají novými, kvantově transformovanými příznaky. Tyto příznaky zachycují nelineární korelace mezi vstupy a můžeš je předat libovolnému klasickému modelu.
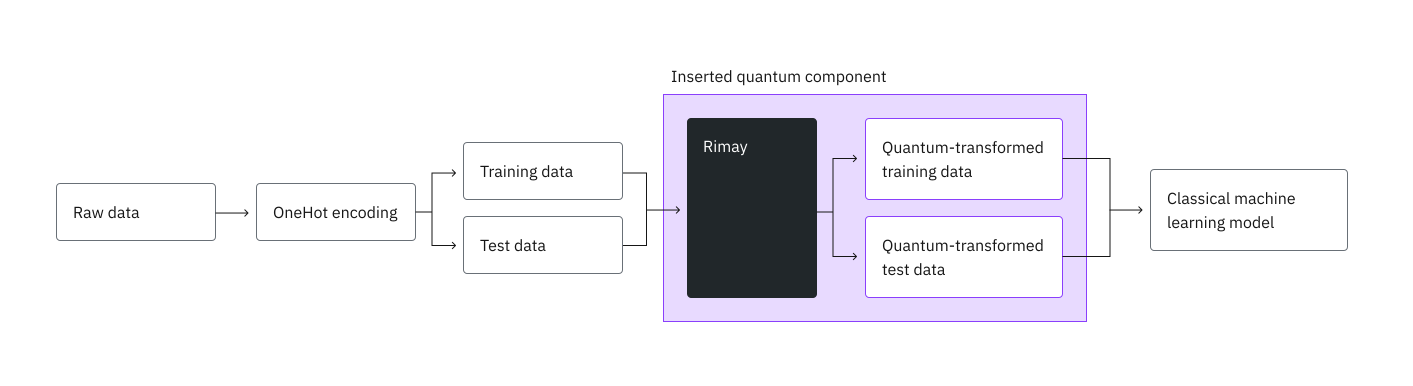
Tento tutoriál používá německou úvěrovou datovou sadu z OpenML [2] s 1000 žadateli a 20 atributy k trénování klasifikátoru náhodného lesa. Nejprve vytvoříš klasický základní model, poté pošleš data do Rimay a nakonec natrénuješ stejný typ modelu na kvantově transformovaných příznacích, samotných i v kombinaci s původními příznaky.
Požadavky
Než začneš s tímto tutoriálem, ujisti se, že máš nainstalované následující balíčky:
-
Klient IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Potřebuješ také přístup k funkci Rimay z katalogu Qiskit Functions.
Nastavení
Importuj balíčky a definuj dvě pomocné funkce: jednu, která trénuje náhodný les, a druhou, která počítá metriky používané v celém tutoriálu.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Nastavení přihlašovacích údajů IBM Quantum
Ověř se pomocí svého API klíče IBM Quantum Platform, načti funkci Rimay a vyber nejméně vytížený kvantový procesor dostupný ve své instanci.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Krok 1: Mapování klasických vstupů na kvantový problém
Rimay mapuje každý numerický vstupní příznak na jeden qubit, takže prvním krokem je převést surovou tabulku na numerické příznaky.
Načtení datové sady
Načti německou úvěrovou datovou sadu přímo z OpenML. Sloupec class obsahuje štítek: good pro žadatele, kteří úvěr splatili, a bad pro ty, kteří ho nesplatili.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Kódování příznaků
Převeď štítek na binární hodnotu a proveď one-hot kódování 13 kategoriálních sloupců. Kód vypouští první kategorii každého sloupce, aby se předešlo redundantním příznakům, což vede k 48 numerickým příznakům.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Rozdělení na trénovací a testovací sady
Ponech 20 % žadatelů stranou jako testovací sadu. Stratifikované rozdělení udržuje podíl dobrých a špatných úvěrů v obou sadách stejný.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Vytvoření klasického základního modelu
Natrénuj náhodný les na klasických příznacích. V kroku 4 s jeho metrikami porovnáš kvantově transformované příznaky.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Nahrání dat do Rimay
Rimay čte své vstupy ze souborů CSV, které do funkce nahraješ. Příznaky a štítky jdou do oddělených souborů. Nahraješ také testovací sadu, aby ji Rimay namapovalo stejným mapováním, jaké natrénuje na trénovací sadě.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Krok 2: Optimalizace problému pro spuštění na kvantovém hardwaru
Rimay sestaví a transpiluje obvody pro procesor, který vybereš, takže není třeba nic ručně optimalizovat. Zadej počet shotů na obvod v rámci následujících omezení:
-
Každý příznak potřebuje jeden qubit, takže procesor musí mít alespoň tolik qubitů, kolik má datová sada příznaků.
-
Rimay spouští jeden obvod na řádek, trénovací a testovací řádky dohromady. Jedna úloha může požadovat nejvýše 10 milionů spuštění, takže počet řádků krát
shotsmusí zůstat v tomto rozpočtu.
Zkontroluj obě omezení před odesláním úlohy.
Úloha musí také skončit do 24 hodin, včetně doby, kterou její obvody čekají ve frontě, jinak je zastavena bez výsledku.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Výpočet velikosti funkce
Každá úloha běží s určitou velikostí funkce, S, M nebo L, která určuje výpočetní prostředky, na nichž běží. U Rimay závisí velikost na počtu řádků, které úloha mapuje, trénovacích a testovacích dohromady. Pokud požaduješ příliš malou velikost, úloha selže s chybou 4600. Velikosti a jejich limity najdeš v části Function sizes v průvodci Rimay.
Následující buňka definuje kalkulátor velikosti. Běží na tvém počítači, čte pouze data, která mu předáš, a nic neodesílá.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Předej datové sady ve stejném pořadí jako soubory v input_file spolu s režimem běhu:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Krok 3: Spuštění pomocí primitiv Qiskit
Spusť Rimay v režimu fit-transform. Natrénuje kvantové mapování příznaků na x_train.csv a y_train.csv a namapuje s ním trénovací i testovací sadu. Pořadí souborů v input_file je důležité. Uveď trénovací příznaky, trénovací štítky a poté volitelné testovací příznaky. Jako function_size předej velikost, kterou jsi vypočítal/a.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Sledování úlohy
Během běhu kontroluj stav úlohy. job.result() blokuje, dokud úloha neskončí.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Výsledek obsahuje mapping_id, který identifikuje mapování natrénované tímto během. V tomto tutoriálu ho nepotřebuješ, protože testovací sada byla namapována ve stejném běhu. Toto ID si zaznamenej, pokud chceš později mapovat nové řádky pomocí mode="transform". Je to jediný způsob, jak získat natrénované mapování, a bez něj musíš natrénovat a zaplatit nové. Mapování je sestaveno pro rozložení qubitů tohoto procesoru, takže pozdější běh transform musí předat stejné backend_name.
mapping_id = result["mapping_id"]
Krok 4: Následné zpracování a vrácení výsledku v požadovaném klasickém formátu
Stažení kvantově transformovaných příznaků
Stáhni soubory, které úloha zapsala, pomocí názvů v output_files. Každý název začíná ID úlohy, takže soubory tohoto běhu zůstanou dostupné i po pozdějších bězích. Předej target_name, aby se každý soubor uložil pod vlastním názvem.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Trénování na kvantově transformovaných příznacích
Natrénuj náhodný les pouze na kvantově transformovaných příznacích.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Trénování na kombinaci klasických a kvantových příznaků
Spoj původní a kvantově transformované příznaky a natrénuj stejný model na této kombinaci.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Porovnání výsledků
Porovnej tři modely na testovací sadě.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

AUC měří, jak dobře model řadí dobré úvěry nad špatné, nezávisle na prahu rozhodnutí, což z něj dělá nejinformativnější metriku na této nevyvážené datové sadě (70 % dobrých úvěrů). V benchmarcích Kipu Quantum dosáhly samotné kvantově transformované příznaky AUC podobné klasickému základnímu modelu a hybridní model, který kombinuje obojí, dosáhl nejvyššího AUC a skóre F1. Kvantově transformované příznaky tedy přidávají informaci, kterou samotné klasické příznaky neposkytují.
Úklid (volitelné)
Natrénované mapování zůstává dostupné, dokud ho nesmažeš. Pokud s ním nechceš mapovat další data, smaž ho. Smazání neprovádí žádnou kvantovou práci, nespotřebuje čas QPU a nelze ho vrátit zpět.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Závěr
Čeho jsi dosáhl/a
V tomto tutoriálu jsi dosáhl/a následujícího:
-
Připravil/a jsi reálnou datovou sadu úvěrového rizika s kategoriálními a numerickými atributy pro kvantovou extrakci příznaků.
-
Vytvořil/a jsi klasický základní model náhodného lesa.
-
Použil/a jsi Rimay k natrénování kvantového mapování příznaků na kvantovém hardwaru a k namapování trénovací a testovací sady v jednom běhu.
-
Natrénoval/a jsi stejný model na kvantově transformovaných i na kombinovaných příznacích a porovnal/a jsi je se základním modelem.
Hlavní poznatky
-
Rimay zapadá do existujícího pipeline strojového učení jako jeden dodatečný krok předzpracování. Zachováš si svou přípravu dat i svůj klasický model.
-
Počet qubitů omezuje počet vstupních příznaků a počet řádků krát
shotsomezuje velikost jedné úlohy. -
Jako výchozí volbu používej kvantově transformované příznaky v kombinaci s původními příznaky, protože model může využít obojí.
Další kroky
- Přečti si průvodce Rimay, abys poznal/a všechny vstupy, mapoval/a nová data pomocí
mode="transform"a viděl/a další benchmarky. - Přečti si, jak byla kvantová extrakce příznaků použita při klasifikaci satelitních snímků [3].
Reference
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.