Řešení problému maximální nezávislé množiny s více proměnnými než qubity pomocí SQOA Solveru od JIJ
Qiskit Functions jsou experimentální funkce dostupná pouze uživatelům plánů IBM Quantum® Premium Plan, Flex Plan a On-Prem (přes IBM Quantum Platform API). Jsou ve stavu předběžného vydání (preview) a podléhají změnám.
Odhad využití: 10 sekund na procesoru Heron r2. (POZNÁMKA: Jde pouze o odhad. Tvá doba běhu se může lišit.)
Pozadí
Tento tutoriál ukazuje, jak pomocí SQOA Solveru, Qiskit Function od JIJ řešit problém maximální nezávislé množiny (MIS) s více binárními proměnnými, než má vybraný QPU qubitů. Základní kroky jsou: načíst instanci MIS z Quantum Optimization Benchmarking Library (QOBLIB) [1], formulovat ji ve tvaru kvadratické neomezené binární optimalizace (QUBO) pomocí qiskit-addon-opt-mapper, odeslat ji do SQOA Solveru ke spuštění na QPU od IBM® a ověřit vrácené řešení.
Problém maximální nezávislé množiny
Nezávislá množina je podmnožina uzlů v grafu taková, že žádné dva vybrané uzly nesdílejí hranu. Maximální nezávislá množina (MIS) je nezávislá množina s největším možným počtem uzlů. Mezi aplikace MIS patří plánování, alokace zdrojů a návrh sítí.
MIS je NP-těžký. Při vyčerpávajícím hledání každý další uzel zdvojnásobí počet podmnožin, které je třeba zvážit, takže tento přístup je nepraktický i pro středně velké grafy. QOBLIB zahrnuje MIS jako jednu ze svých deseti tříd problémů, takže je užitečným benchmarkem pro hodnocení kvantových optimalizačních pracovních postupů na skutečném hardwaru.
Matematická formulace
Pro daný neorientovaný graf přiřaď každému uzlu binární proměnnou :
-
, pokud je uzel vybrán.
-
otherwise.
Binární lineární formulace maximalizuje počet vybraných uzlů a zároveň zabraňuje tomu, aby byly vybrány oba koncové uzly jakékoli hrany:
Cíl počítá vybrané uzly. Společně omezení hran zajišťují, že vybrané uzly tvoří nezávislou množinu.
Tento tutoriál používá binární neomezenou formulaci z QOBLIB, která nahrazuje omezení hran kvadratickými penalizacemi:
Kdykoli jsou vybrány oba koncové uzly hrany, druhý člen odečte od cíle dvojku. Tato penalizace činí konfliktní výběr méně výhodným než ponechání kteréhokoli koncového uzlu samotného. Výsledný cíl je QUBO, což je vstupní formát, který SQOA Solver přijímá.
Proč používat SQOA Solver?
Mnoho přístupů ke kvantové optimalizaci přiřazuje jeden qubit každé binární proměnné, takže kapacita kvantového hardwaru může přímo omezovat velikost problému. SQOA Solver kombinuje několik technik redukce a hybridních výpočtů, aby toto omezení zmírnil:
-
Dokáže řešit problémy s více binárními proměnnými, než má QPU qubitů. Presolve aplikuje redukční pravidla, která mohou fixovat proměnné a zjednodušit zbývající QUBO při zachování alespoň jednoho optimálního řešení. Empiricky může presolve také učinit zbývající QUBO řidším, což pomáhá kódování založenému na QRAC, které následuje.
Solver poté používá kódování založené na QRAC odvozené z Quantum Random Access Optimization (QRAO) [3], aby na jednom qubitu reprezentoval více proměnných (až tři) bez přímé QUBO interakce.
Redukce z presolve a kódování závisí na struktuře problému. Například v tomto tutoriálu problém s 200 proměnnými využije pouze 67 qubitů.
-
Může být méně citlivý na hardwarový šum. Sample-based quantum diagonalization [4], [5] používá QPU k vzorkování bitových řetězců, ale diagonalizaci provádí klasicky. Tím se vyhne opakovaným vyhodnocením na QPU kvůli aktualizacím variačních parametrů a může snížit dopad šumu na optimalizační pracovní postup.
-
Automatizuje pracovní postup od presolve po následné zpracování. Poskytneš správně formátovanou instanci QUBO a vybereš backend. SQOA Solver poté spustí celý pracovní postup automaticky. Aplikuje presolve, mapuje klasické proměnné na uvolněný kvantový problém, sestaví a transpiluje vzorkovací obvody, provede kvantové vzorkování a klasickou diagonalizaci, zaokrouhlí a zpřesní přiřazení a rekonstruuje a vyhodnotí klasické řešení.
Požadavky
Než začneš s tímto tutoriálem, ujisti se, že máš nainstalované následující balíčky:
-
Klient Qiskit Functions Catalog (
pip install qiskit-ibm-catalog). -
Qiskit addon optimization mapper, používaný k formulaci problému (
pip install qiskit-addon-opt-mapper). -
NetworkX a Matplotlib, používané ke zpracování a vykreslení grafu (
pip install networkx matplotlib).
Také potřebuješ přístup k SQOA Solveru z Qiskit Functions Catalog. Vyplň formulář a požádej o přístup k funkci.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "networkx": "networkx", "ommx": "ommx", "ommx_quantum_benchmarks": "ommx-quantum-benchmarks", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# %pip install qiskit-ibm-catalog qiskit-addon-opt-mapper networkx matplotlib
Nastavení
Nejprve importuj potřebné balíčky a nástroje.
import urllib.request

import matplotlib.pyplot as plt
import networkx as nx
from qiskit_addon_opt_mapper import OptimizationProblem
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_ibm_catalog import QiskitFunctionsCatalog
SQOA Solver přijímá problém QUBO jako slovník koeficientů ve formátu n-tice-řetězec používaném optimalizačními funkcemi IBM®. Definuj pomocnou funkci, která převede QUBO vrácené funkcí OptimizationProblemToQubo do tohoto formátu.
Převodník vždy vrací problém minimalizace, což odpovídá tomu, jak SQOA Solver zachází s problémem zadaným jako slovník. Klíče používají indexy proměnných QUBO a každá proměnná dostane lineární položku, i s nulovým koeficientem, aby vrácené řešení pokrývalo všechny proměnné.
def to_problem_dict(qubo: OptimizationProblem) -> dict[str, float]:
    """Convert a QUBO from OptimizationProblemToQubo to the SQOA Solver dictionary format."""
    objective = qubo.objective
    payload = {"()": objective.constant}
    # Keep every variable in the problem, even with a zero linear coefficient.
    payload.update({f"({i},)": 0.0 for i in range(qubo.get_num_vars())})
    for i, coefficient in objective.linear.to_dict().items():
        payload[f"({i},)"] += coefficient
    for (i, j), coefficient in objective.quadratic.to_dict().items():
        # Fold a binary diagonal term x_i * x_i = x_i into the linear term.
        key = f"({i},)" if i == j else f"({i}, {j})"
        payload[key] = payload.get(key, 0.0) + coefficient
    return {key: float(value) for key, value in payload.items()}
Krok 1: Mapování klasických vstupů na kvantový problém
SQOA Solver přijímá problém QUBO a kvantové mapování provádí uvnitř funkce. V tomto tutoriálu stáhneš instanci MIS z QOBLIB a formuluješ ji jako QUBO pomocí qiskit-addon-opt-mapper. Tento krok zahrnuje následující:
-
Připojení k SQOA Solveru.
-
Pochopení frameworku SQOA.
-
Načtení instance problému.
-
Formulace QUBO a jeho převod pro odeslání.
Připojení k SQOA Solveru
Připoj se ke Qiskit Functions Catalog pomocí svých přihlašovacích údajů IBM Quantum Platform a poté načti SQOA Solver. Následující kód předpokládá, že jsi již uložil svůj účet do místního prostředí.
Pokud připojení selže, ověř, že správce tvého účtu IBM Quantum Platform udělil vybrané instanci služby přístup k SQOA Solveru.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
solver = catalog.load("jij/sqoa-solver")
Pochopení frameworku SQOA
Sampling-based Quantum Optimization Algorithm with Quantum Relaxation (SQOA-QR) [2] kombinuje Quantum Random Access Optimization (QRAO) se sample-based quantum diagonalization:
-
Kvantová relaxace a kódování: SQOA Solver převede QUBO na minimalizační Isingův cíl tvaru , kde . QRAO [3] poté mapuje každou spinovou proměnnou na Pauliho observabl. Pro zde použité kódování -QRAC je uvolněný hamiltonián
kde je jednotkový operátor, přiřazuje proměnnou qubitu a jednomu z , nebo a je počet proměnných mapovaných na stejný qubit jako . Když oba relevantní qubity obsahují tři proměnné, lineární a kvadratické škálovací faktory se stanou , respektive .
Proměnným, které sdílejí qubit, jsou přiřazeny různé nekomutující Pauliho observabily. Proměnné, které v QUBO interagují, jsou udržovány na různých qubitech, zatímco proměnné bez přímé QUBO interakce mohou sdílet qubit. Snížení počtu qubitů tedy závisí na struktuře problému.
-
Kvantové vzorkování: Kvantový procesor vzorkuje bitové řetězce z obvodů navržených k prozkoumání nízkoenergetických stavů uvolněného hamiltoniánu.
-
Diagonalizace založená na vzorcích: Solver promítne uvolněný hamiltonián na podprostor generovaný bázovými stavy získanými ze vzorkovaných bitových řetězců a promítnutý hamiltonián klasicky diagonalizuje [4], [5]. Pro pevnou množinu vzorkovaných bitových řetězců nechť je podprostor generovaný různými bázovými stavy, takže . Jeho odhadnutá energie základního stavu je:
kde je energie základního stavu úplného uvolněného hamiltoniánu. Větší zachovaný podprostor tedy nemůže zvýšit odhadnutou energii základního stavu.
Toto uspořádání předpokládá stejný výsledek vzorkování a týká se energie uvolněného hamiltoniánu před zaokrouhlením. Teoreticky nezaručuje lepší vrácené klasické řešení. V QRAO se však heuristicky očekává, že stav s nižší energií poskytne lepší klasické řešení.
-
Zaokrouhlení: Uvolněný stav získaný z diagonalizace se převede na klasické binární přiřazení.
SQOA Solver obklopuje tento framework klasickým zpracováním. Před kvantovým mapováním presolve aplikuje redukční pravidla, která mohou fixovat proměnné a zjednodušit zbývající QUBO při zachování alespoň jednoho optimálního řešení. Po diagonalizaci a zaokrouhlení klasické lokální vyhledávání zpřesní přiřazení a OMMX rekonstruuje a vyhodnotí úplné řešení.
Načtení instance
QOBLIB distribuuje každou instanci MIS jako graf ve formátu DIMACS .gph, řádkovém formátu, ve kterém řádek začínající p udává počty uzlů a hran a každý řádek začínající e definuje hranu.
QOBLIB také zveřejňuje optimální nebo nejlepší známé referenční řešení pro každou instanci. Následující funkce stáhnou obojí z repozitáře QOBLIB. DIMACS označuje uzly od 1, takže graf je přeznačen tak, aby začínal od 0.
Pokud chceš místo toho začít s vlastním grafem, přeskoč stahování a problém formuluj ze svého grafu NetworkX stejným způsobem.
QOBLIB_URL = "https://raw.githubusercontent.com/ZIB-AOPT/QOBLIB/refs/heads/main/07-independentset"

def fetch_qoblib_graph(name: str) -> nx.Graph:
    """Download a QOBLIB independent-set instance as a NetworkX graph."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/instances/{name}.gph"
    ) as response:
        lines = response.read().decode().splitlines()
    graph = nx.Graph()
    for fields in map(str.split, lines):
        if fields and fields[0] == "p":
            # Header: p edge <number of nodes> <number of edges>
            graph.add_nodes_from(range(int(fields[2])))
        elif fields and fields[0] == "e":
            # DIMACS labels nodes from 1; relabel them to start from 0.
            graph.add_edge(int(fields[1]) - 1, int(fields[2]) - 1)
    return graph

def fetch_reference_objective(name: str) -> float:
    """Read the objective value of the QOBLIB reference solution."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/solutions/{name}.opt.sol"
    ) as response:
        for line in response.read().decode().splitlines():
            if line.startswith("# Objective value"):
                return float(line.split("=")[1])
    raise ValueError(f"No objective value found for {name}.")

INSTANCE_NAME = "gen200_p0-9_44"
G = fetch_qoblib_graph(INSTANCE_NAME)
reference_objective = fetch_reference_objective(INSTANCE_NAME)
Hodnotu cíle referenčního řešení později použiješ k posouzení výsledku ze SQOA Solveru. Tento tutoriál řeší tento problém na zařízení se 156 qubity.
print(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
print(f"Reference objective: {reference_objective:g}")
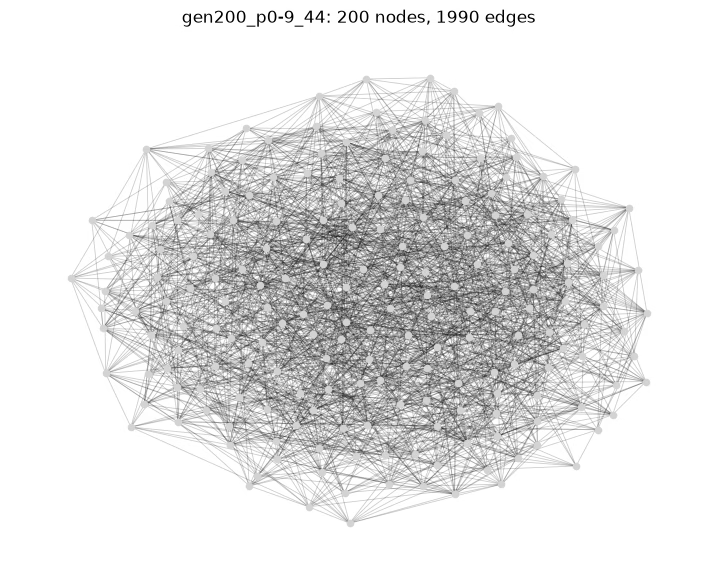
gen200_p0-9_44: 200 nodes, 1990 edges
Reference objective: 44
Vizualizuj graf. Později jej také použiješ k ověření, že uzly vrácené SQOA Solverem tvoří nezávislou množinu.
layout = nx.forceatlas2_layout(
    G, max_iter=500, scaling_ratio=3.0, gravity=1.0, seed=7
)
node_size = max(8, min(60, 4000 / max(G.number_of_nodes(), 1)))

fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G, layout, node_size=node_size, node_color="lightgray", ax=ax
)
ax.set_title(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
ax.set_axis_off()
plt.show()
Formulace QUBO
Sestav binární lineární formulaci ze sekce Pozadí jako OptimizationProblem s jednou binární proměnnou na uzel, cílem, který počítá vybrané uzly, a jedním omezením na hranu. Poté ji převeď pomocí OptimizationProblemToQubo.
S váhou penalizace 2 převodník nahradí každé omezení hrany penalizačním členem a změní maximalizaci na minimalizaci, takže převedený problém je binární neomezená formulace z QOBLIB s opačným znaménkem. Indexy proměnných QUBO jsou označení uzlů grafu. Aplikační třída IndependentSet v qiskit_addon_opt_mapper.applications sestaví stejný model s omezeními pomocí IndependentSet(G).to_optimization_problem().
Nakonec převeď QUBO do formátu slovníku pomocí to_problem_dict(). Protože problém je binární QUBO, požadavek v kroku 2 deklaruje jeho doménu proměnných jako "binary". Funkce provádí presolve, kvantové mapování a sestavení obvodu po odeslání.
mis = OptimizationProblem(INSTANCE_NAME)
mis.binary_var_list(G.number_of_nodes(), name="x")
mis.maximize(linear={v: 1 for v in G.nodes})
for u, v in G.edges:
    mis.linear_constraint({u: 1, v: 1}, "<=", 1)

converter = OptimizationProblemToQubo(penalty=2)
qubo = converter.convert(mis)
problem_dict = to_problem_dict(qubo)

print(f"QUBO variables: {qubo.get_num_vars()}")
print(f"Dictionary entries: {len(problem_dict)}")
QUBO variables: 200
Dictionary entries: 2191
Krok 2: Optimalizace problému pro spuštění na kvantovém hardwaru
SQOA Solver provádí kvantové mapování a přípravu hardwaru uvnitř funkce. Nejprve aplikuje presolve na QUBO a poté mapuje zbývající proměnné na uvolněný hamiltonián pomocí kódování založeného na QRAC.
Pro kvantové vzorkování sestaví obvody založené na uvolněném hamiltoniánu a transpiluje je pro vybraný backend. Redukce velikosti problému a počtu qubitů z presolve a kódování závisí na problému, proto solver konfiguruj bez předpokladu pevného redukčního faktoru.
Konfigurace vstupů solveru
SQOA Solver vyžaduje dva vstupy:
-
problem, slovník z kroku 1. -
variable_type, což je pro toto QUBO"binary".
Přijímá také dva volitelné vstupy:
-
backend_namevybírá QPU. Pokud je vynechán nebo jeNone, funkce vybere nejméně vytížený provozní QPU, který je přístupný tvé instanci. -
optionsje slovník, který řídí rozpočet vzorkování (shots), klasický seed (seed), použití session (session), klasické lokální vyhledávání (postprocessing_level) a štítky úlohy (job_tags). Pokud zvýšíšshots, statistika vzorkování se může zlepšit.
Všechny vstupy, jejich výchozí hodnoty a pravidla validace najdeš v referenci API.
Tento tutoriál pojmenuje backend explicitně, použije výchozí hodnoty pro shots, session a postprocessing_level a nastaví klasický seed. Shromáždi vstupy do slovníku, abys je mohl předat do solver.run() v kroku 3.
# ibm_fez has 156 qubits
backend_name = (
    "ibm_fez"  # Omit this key or pass None for automatic selection.
)

sqoa_input = {
    "problem": problem_dict,
    "variable_type": "binary",
    "backend_name": backend_name,
}
sqoa_input["options"] = {
    "shots": 4096,
    "seed": 42,
    "session": False,
    "postprocessing_level": 1,
}
Krok 3: Spuštění pomocí primitiv
Odešli úlohu pomocí připojení k SQOA Solveru vytvořeného v kroku 1. Funkce spustí primitivum IBM Quantum Sampler na vybraném backendu, shromáždí změřené bitové řetězce a pokračuje klasickou diagonalizací a následným zpracováním. Pracuješ s jedinou úlohou funkce.
job = solver.run(**sqoa_input)
print(f"Job ID: {job.job_id}")
Job ID: dcee8e26-b8ac-4dd7-a76e-5adb5bc388e5
Stav zátěže zjistíš podle Kontrola stavu úlohy. Funkce interně prochází fázemi mapování, optimalizace pro hardware, čekání ve frontě, spuštění na QPU a následného zpracování.
job.status()
'INITIALIZING'
job.result() blokuje, dokud se úloha nedokončí, a vrací slovník s řešením, jeho hodnotou cíle a přípustností a metadaty, která obsahují informace o solveru a využití zdrojů. Úplnou definici vstupů a výstupů najdeš v referenci API.
result = job.result()
Krok 4: Následné zpracování výsledku a jeho převod do klasického formátu
Prozkoumej úplný výstup funkce, namapuj vrácené přiřazení zpět na graf, ověř vybrané uzly a vizualizuj výsledek.
Prozkoumání výsledku
Slovník výsledku obsahuje čtyři pole nejvyšší úrovně:
-
solutionje úplné přiřazení proměnných s klíčix_i, kde i je index proměnné (napříkladx_17). V tomto tutoriálu je index proměnné označením uzlu. -
objective_valueje hodnota cíle tohoto přiřazení vyhodnocená na odeslaném slovníku, tedy na minimalizačním QUBO. -
feasiblese týká pouze domény proměnných, protože slovník nemá žádná omezení. -
metadataobsahujesolver_infoaresource_usage.solver_infozaznamenává efektivníseedběhu. Pokud proběhlo klasické lokální vyhledávání,solver_infotaké zaznamenává zaokrouhlené přiřazení před tímto zpřesněním vsolution_before_postprocessing.
solver_info = result["metadata"]["solver_info"]

print(f"Result fields: {list(result)}")
print(f"Solution entries: {len(result['solution'])}")
print(f"First entries: {dict(list(result['solution'].items())[:3])}")
print(f"Objective value: {result['objective_value']}")
print(f"Feasible: {result['feasible']}")
print(f"Solver-info fields: {list(solver_info)}")
print(f"Effective seed: {solver_info['seed']}")
print(f"Resource-usage phases: {list(result['metadata']['resource_usage'])}")
Result fields: ['solution', 'objective_value', 'feasible', 'metadata']
Solution entries: 200
First entries: {'x_0': 0.0, 'x_1': 0.0, 'x_2': 1.0}
Objective value: -35.0
Feasible: True
Solver-info fields: ['seed', 'solution_before_postprocessing']
Effective seed: 42
Resource-usage phases: ['RUNNING: MAPPING', 'RUNNING: OPTIMIZING_FOR_HARDWARE', 'RUNNING: WAITING_FOR_QPU', 'RUNNING: EXECUTING_QPU', 'RUNNING: POST_PROCESSING']
Mapování řešení na graf
Shromáždi vrácené hodnoty v pořadí indexů proměnných a pomocí interpret() je namapuj zpět na proměnné původního problému. Vybrané uzly jsou proměnné s hodnotou 1 a is_feasible() zkontroluje přiřazení vůči omezením hran původního problému.
x_qubo = [result["solution"][f"x_{i}"] for i in range(qubo.get_num_vars())]
x = converter.interpret(x_qubo)
selected_nodes = [node for node, value in enumerate(x) if value > 0.5]

print(f"Selected nodes: {len(selected_nodes)}")
print(f"Satisfies every edge constraint: {mis.is_feasible(x)}")
Selected nodes: 35
Satisfies every edge constraint: True
Porovnání s řešením před následným zpracováním
Protože postprocessing_level je 1, solver_info také zaznamenává zaokrouhlené přiřazení před klasickým lokálním vyhledáváním v solution_before_postprocessing. Používá stejné klíče jako solution.
Vyhodnoť jej na QUBO, abys viděl, jak moc zpřesnění výsledek zlepšilo. Obě hodnoty jsou cíle odeslaného minimalizačního QUBO, takže nižší hodnota je lepší. Pole je vynecháno, pokud lokální vyhledávání neproběhne, například když presolve fixuje každou proměnnou.
before = solver_info.get("solution_before_postprocessing")
if before is None:
    print("The classical local search did not run for this problem.")
else:
    x_before = [before[f"x_{i}"] for i in range(qubo.get_num_vars())]
    changed = sum(
        before[key] != value for key, value in result["solution"].items()
    )
    print(
        f"Objective before local search: {qubo.objective.evaluate(x_before)}"
    )
    print(f"Objective after local search: {result['objective_value']}")
    print(f"Variables changed by local search: {changed}")
Objective before local search: -12.0
Objective after local search: -35.0
Variables changed by local search: 19
Ověření omezení nezávislosti
Protože QUBO reprezentuje sousednost pomocí penalizačních členů místo explicitních omezení, heuristický výsledek může stále vybrat sousední uzly. Zkontroluj vrácené uzly přímo vůči grafu. Pro porovnání a vizualizaci v následujících sekcích zkopíruj vrácenou množinu a hladově odstraň jeden koncový uzel každého zjištěného konfliktu.
returned_set = set(selected_nodes)
conflicts = [
    (u, v) for u, v in G.edges if u in returned_set and v in returned_set
]
print(f"Conflicting edges in the returned set: {len(conflicts)}")

independent_set = returned_set.copy()
for u, v in conflicts:
    if u in independent_set and v in independent_set:
        # Drop the endpoint that has more selected neighbors.
        drop = max(
            (u, v),
            key=lambda node: sum(nb in independent_set for nb in G[node]),
        )
        independent_set.remove(drop)

assert all(
    not (u in independent_set and v in independent_set) for u, v in G.edges
)
print(f"Independent set size after repair: {len(independent_set)}")
Conflicting edges in the returned set: 0
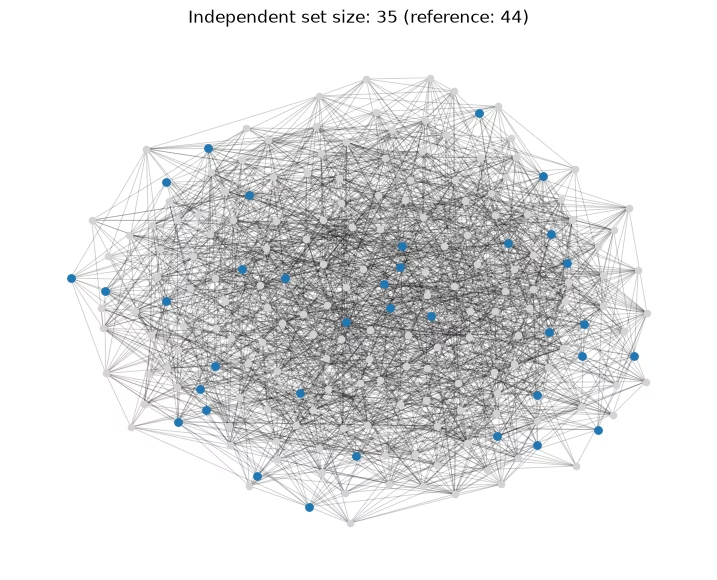
Independent set size after repair: 35
Porovnání s referenčním řešením
V kroku 1 jsi stáhl(a) hodnotu účelové funkce referenčního řešení QOBLIB. Referenční řešení QOBLIB mohou být optimální nebo nejlepší známá, proto výsledek porovnávej s referenční hodnotou účelové funkce a nepředpokládej, že jde vždy o certifikované optimum.
U této maximalizační úlohy poměr 1.0 znamená, že opravený výsledek odpovídá referenční hodnotě účelové funkce.
ratio_to_reference = len(independent_set) / reference_objective

print(f"Reference objective: {reference_objective:g}")
print(f"Ratio to reference: {ratio_to_reference:.3f}")
Reference objective: 44
Ratio to reference: 0.795
Vizualizace výsledku
Vykresli graf znovu se zvýrazněnou opravenou nezávislou množinou. Žádné dva zvýrazněné uzly nesdílejí hranu.
fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=[v for v in G if v not in independent_set],
    node_size=node_size,
    node_color="lightgray",
    ax=ax,
)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=sorted(independent_set),
    node_size=node_size * 1.4,
    node_color="tab:blue",
    ax=ax,
)
ax.set_title(
    f"Independent set size: {len(independent_set)} "
    f"(reference: {reference_objective:g})"
)
ax.set_axis_off()
plt.show()
Zjištění využití zdrojů
Metadata výsledku uvádějí CPU_TIME pro fáze jiné než RUNNING: EXECUTING_QPU, pokud je k dispozici. Fáze RUNNING: EXECUTING_QPU může uvádět QPU_TIME, tedy využití QPU vrácené službou Quantum Compute, pokud je pro každou úlohu Quantum Compute k dispozici konečné využití.
usage = result["metadata"]["resource_usage"]

for phase, metrics in usage.items():
    line = f"{phase:36s}"
    if "CPU_TIME" in metrics:
        line += f" CPU {metrics['CPU_TIME']:8.1f} s"
    if "QPU_TIME" in metrics:
        line += f" QPU {metrics['QPU_TIME']:8.1f} s"
    print(line)
RUNNING: MAPPING                     CPU     11.8 s
RUNNING: OPTIMIZING_FOR_HARDWARE     CPU     15.4 s
RUNNING: WAITING_FOR_QPU             CPU     16.5 s
RUNNING: EXECUTING_QPU               QPU      3.0 s
RUNNING: POST_PROCESSING             CPU     55.8 s
Závěr
V tomto tutoriálu jsi stáhl(a) instanci MIS z QOBLIB, zformulovala(a) ji jako QUBO pomocí qiskit-addon-opt-mapper, připojil(a) ses k SQOA Solver, nakonfiguroval(a) a odeslal(a) úlohu, namapoval(a) vrácené přiřazení zpět na graf a zkontroloval(a) vybrané uzly vůči původnímu grafu.
Také jsi porovnal(a) výsledek s referenčním řešením QOBLIB, prozkoumal(a) přínos klasického následného zpracování a prohlédl(a) si využití zdrojů v každé fázi provádění.
SQOA Solver kombinuje presolve, QRAO s kódováním založeným na QRAC, sestavení vzorkovacích obvodů, transpilaci s ohledem na hardware, diagonalizaci založenou na vzorcích, zaokrouhlování a klasické zpřesňování. Tento postup dokáže zobrazit více binárních proměnných, než by umožnilo kódování jedna proměnná na jeden qubit. Míra redukce z presolve a kódování závisí na struktuře úlohy a kvalita řešení závisí na získaných vzorcích.
Nastavení shots a postprocessing_level řídí rozpočet kvantového vzorkování, respektive klasické zpřesňování, aniž by se měnil postup odeslání.
Příloha: Odeslání úlohy jako instance OMMX
SQOA Solver přijímá také ommx.v1.Instance ze sady SDK OMMX. Balíček OMMX Quantum Benchmarks distribuuje úlohy QOBLIB jako instance OMMX spolu s jejich referenčními řešeními, takže můžeš načíst stejné QUBO, aniž bys ho musel(a) sám/sama formulovat.
Při vstupu OMMX se objective_value vyhodnocuje ve smyslu dané instance a výsledek obsahuje také kanonické ommx.v1.Solution. Nainstaluj balíček, který zároveň nainstaluje OMMX SDK:
# %pip install ommx-quantum-benchmarks
Načti model binary_unconstrained stejné instance. Zavaděč datové sady vypisuje zprávy o průběhu, proto je kód zachytává, aby byl výstup stručný.
%%capture
from ommx_quantum_benchmarks.qoblib import IndependentSet

ommx_instance, _ = IndependentSet()("binary_unconstrained", INSTANCE_NAME)
SQOA Solver přijímá instanci OMMX jako standardní řetězec Base64 s paddingem a vrací kanonické řešení ve stejném formátu. Definuj dvě pomocné funkce pro tento převod:
-
to_problem_payload()serializujeommx.v1.Instancedo řetězce, který předáš jakoproblem. -
to_ommx_solution()dekóduje kanonickéommx.v1.Solutionz výsledku.
import base64

from ommx.v1 import Instance, Solution

def to_problem_payload(instance: Instance) -> str:
    """Serialize an OMMX instance into the `problem` string for SQOA Solver."""
    return base64.b64encode(instance.to_bytes()).decode()

def to_ommx_solution(result: dict) -> Solution:
    """Decode the canonical OMMX solution from a SQOA Solver result."""
    payload = result["metadata"]["solver_info"]["ommx_solution"]
    return Solution.from_bytes(base64.b64decode(payload, validate=True))
Odešli instanci se stejnými vstupy jako dříve, jen nahraď problem. Poté dekóduj kanonické řešení a načti vybrané uzly podle názvu proměnné.
ommx_job = solver.run(
    **{**sqoa_input, "problem": to_problem_payload(ommx_instance)}
)
ommx_result = ommx_job.result()

ommx_solution = to_ommx_solution(ommx_result)
x_values = ommx_solution.extract_decision_variables("x")
ommx_nodes = sorted(
    node for (node,), value in x_values.items() if value > 0.5
)

print(f"Objective value: {ommx_result['objective_value']}")
print(f"Selected nodes: {len(ommx_nodes)}")
Objective value: 35.0
Selected nodes: 35
Další kroky
- Použij tento postup na vlastní úlohy QUBO. Sestav
OptimizationProblem, jak je ukázáno v příručce k SQOA Solver. Kroky převodu a odeslání zůstávají stejné, ale validaci přizpůsob struktuře své úlohy. - Odešli úlohu jako instanci OMMX, jak je ukázáno v příloze. Přijímané formáty úloh a vracená pole najdeš v referenci API.
- Prozkoumej další instance nezávislých množin v repozitáři QOBLIB nebo prostřednictvím OMMX Quantum Benchmarks.
- Dozvíš se více o modelování pomocí qiskit-addon-opt-mapper nebo JijModeling a o výměně úloh pomocí OMMX.
Odkazy
[1] Koch, T., Bernal Neira, D. E., Chen, Y., Cortiana, G., Egger, D. J., Heese, R., Hegade, N. N., Gomez Cadavid, A., Huang, R., Itoko, T., et al. (2026). Quantum optimization benchmarking library: The intractable decathlon. Nature Computational Science, 6, 653–671. DOI, arXiv:2504.03832
[2] Matsuyama, H., & Yamashiro, Y. (2025). Sampling-based quantum optimization algorithm with quantum relaxation. 2025 IEEE International Conference on Quantum Computing and Engineering (QCE), 1, 2323–2333. DOI, arXiv:2504.12629
[3] Fuller, B., Hadfield, C., Glick, J. R., Imamichi, T., Itoko, T., Thompson, R. J., Jiao, Y., Kagele, M. M., Blom-Schieber, A. W., Raymond, R., et al. (2024). Approximate solutions of combinatorial problems via quantum relaxations. IEEE Transactions on Quantum Engineering, 5, 1–15. DOI, arXiv:2111.03167
[4] Kanno, K., Kohda, M., Imai, R., Koh, S., Mitarai, K., Mizukami, W., & Nakagawa, Y. O. (2026). Quantum-selected configuration interaction: Classical diagonalization of Hamiltonians in subspaces selected by quantum computers. Physical Review Research, 8(2), 023268. DOI, arXiv:2302.11320
[5] Robledo-Moreno, J., Motta, M., Haas, H., Javadi-Abhari, A., Jurcevic, P., Kirby, W., et al. (2025). Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11(25), eadu9991. DOI, arXiv:2405.05068