Obnovení vlastností backendu pomocí benchmarkingu v reálném čase
Odhad využití: 3 minuty na ibm_kingston (POZNÁMKA: Toto je pouze odhad. Tvůj skutečný čas se může lišit.)
Výstupy z učení
-
Proč vlastnosti hlášené QPU mohou zaostávat za aktuálním chováním zařízení a kdy se vyplatí je přeměřit sám
-
Co měří každý z pěti standardních charakterizačních experimentů (čtení, jednoqubitový randomizovaný benchmarking, vrstvený dvouqubitový randomizovaný benchmarking, a )
-
Jak spustit celou charakterizační sadu jedním voláním nebo postupně krok za krokem a získat zpět objekt backendu s obnovenými vlastnostmi
-
Jak porovnat naměřené vlastnosti s hlášenými a proč některé rozdíly odrážejí spíše metodiku měření než posun zařízení
Předpoklady
-
Pracovní postup Qiskit patterns
-
Režimy spuštění Qiskit Runtime, zejména batch mode
-
Jak zkoumat informace o QPU, jako jsou vlastnosti backendu a kalibrační data
Souvislosti
Každé QPU IBM Quantum® hlásí sadu vlastností popisujících, jak dobře v současnosti funguje každý jeho qubit: relaxační časy (), koherenční časy (), chyby čtení a chyby jedno- a dvouqubitových hradel. Tato čísla mají v praxi význam. Transpilátor je používá k rozhodnutí, na kterých fyzických qubitech by měl tvůj obvod běžet, techniky zmírnění chyb se na ně spoléhají a ty je můžeš použít k posouzení, zda zařízení funguje dostatečně dobře pro daný experiment.
Hlášené vlastnosti pocházejí z kalibračních procedur, které se obvykle spouštějí přibližně jednou denně. Supravodivé qubity se však mohou posouvat v kratších časových horizontech a přechodné defekty (tzv. dvouhladinové systémy) mohou dočasně zhoršit qubit, který v době kalibrace vypadal výborně. Kromě toho je úloha často transpilovaná dlouho před svým skutečným spuštěním, takže rozhodnutí založená na hlášených vlastnostech mohou vycházet z neaktuálních informací. Tutoriál Benchmarking v reálném čase pro výběr qubitů ukazuje, jak výrazně se tyto vlastnosti mohou den ode dne měnit, a ručně sestavuje kompletní charakterizační pracovní postup z jednotlivých Qiskit Experiments.
Tento tutoriál ukazuje zjednodušenou verzi tohoto pracovního postupu, a to pomocí nástroje BackendCharacterization z Qiskit Device Benchmarking, který sestavování experimentů, odesílání úloh a fitování křivek zabalí do několika volání. Strávíš přibližně 70 sekund času QPU a získáš zpět objekt backendu, jehož vlastnosti odrážejí zařízení právě teď, připravený k porovnání s hlášenými hodnotami nebo předání navazujícím nástrojům.
Charakterizační experimenty
Sada měří pět vlastností, každou pomocí standardního experimentu:
-
Chyba čtení (
readout): Každý qubit je připraven do stavu nebo a okamžitě změřen. Pravděpodobnost přečtení nesprávného stavu udává chybu přípravy a měření stavu (SPAM). -
Chyba jednoqubitového hradla (
rb_1q): Randomizovaný benchmarking (RB) spouští sekvence náhodných jednoqubitových Cliffordových hradel, jejichž složení by v ideálním případě dalo identitu. Způsob, jakým pravděpodobnost přežití klesá s délkou sekvence, dává průměrnou chybu na hradlo, nezávislou na chybách SPAM. -
Chyba dvouqubitového hradla (
rb_2q): Stejná myšlenka RB aplikovaná na celé vrstvy nepřekrývajících se dvouqubitových hradel prováděných současně, jako v experimentu vrstvové věrnosti. Protože běží mnoho hradel najednou, výsledné míry chyb zahrnují efekty přeslechů a jsou blíže tomu, co skutečně zažívá hluboký obvod. -
(
t1): Každý qubit je excitován a měřen po rostoucích prodlevách. Pokles populace excitovaného stavu udává relaxační čas. -
(
t2): Experiment s Hahnovým echem uvede každý qubit do superpozice, uprostřed prodlevy aplikuje echo pulz a měří, jak rychle dochází ke ztrátě fázové koherence. Ve výchozím nastavení se používá jedno echo; víceechová varianta (ve stylu CPMG) je demonstrována na konci tohoto tutoriálu.
Co obnovení dělá a co ne
Při používání tohoto pracovního postupu měj na paměti tři body:
-
Obnovené vlastnosti existují pouze v objektu backendu, který ti byl vrácen. Na samotném zařízení ani v kalibračních datech, která IBM Quantum hlásí ostatním uživatelům, se nic nemění.
-
Naměřené hodnoty jsou snímkem pořízeným konkrétní metodikou. Některé z nich, zejména vrstvové dvouqubitové chyby a paralelní jednoechové hodnoty , jsou měřeny jinak než hlášená kalibrační data, takže část jakéhokoli pozorovaného rozdílu je způsobena metodikou, nikoli posunem zařízení. Tento tutoriál upozorňuje, kde k tomu dochází.
-
Samotná charakterizace stojí čas QPU (přibližně 70 sekund pro celou sadu na procesoru Heron r2), což je cena za aktuální informace.
Pracovní postup se řídí čtyřmi kroky vzoru Qiskit:
-
Krok 1: Mapování klasických vstupů na kvantový problém. Vyber zařízení a sadu vlastností k měření.
-
Krok 2: Optimalizace problému pro spuštění na kvantovém hardwaru. Nástroj sestavuje experimentální obvody přímo v nativních hradlech zařízení a paralelizuje je napříč čipem.
-
Krok 3: Spuštění pomocí Qiskit primitiv. Experimenty běží jako úlohy Sampler uvnitř dávky.
-
Krok 4: Následné zpracování a vrácení výsledku v požadovaném klasickém formátu. Fituj naměřená data do map chyb pro jednotlivé qubity, obnov backend a porovnej naměřené vlastnosti s hlášenými.
Požadavky
Před zahájením tohoto tutoriálu se ujisti, že máš nainstalováno následující:
-
Qiskit SDK v2.0 nebo novější, s podporou vizualizace
-
Qiskit Runtime v0.40 nebo novější (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, který také nainstaluje Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Nastavení
Importuj požadované knihovny.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Sada charakterizačních testů vytváří několik experimentů, odesílá více úloh a fituje výsledky, což může trvat celkově několik minut. Zapni logování na úrovni INFO, aby každá fáze průběžně vypisovala, jak postupuje.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Příklad s malým simulátorem
Tento tutoriál neobsahuje příklad se simulátorem. Pracovní postup měří fyzikální nedokonalosti konkrétního zařízení: jak rychle jeho qubity relaxují a defázují a jak často selhávají jeho gates a čtení (readout). Ideální simulátor žádné z těchto nedokonalostí nemá, takže není co charakterizovat. Mohl bys sice připojit syntetický šumový model k fake backendu, ale experimenty by pak jen znovu získaly čísla, která jsi do něj sám vložil. Z tohoto důvodu přejdeme přímo k hardwaru; postup rozdělíme do čtyř kroků vzoru Qiskit.
Příklad s rozsáhlým hardwarem
Krok 1: Mapování klasických vstupů na kvantový problém
V tomto pracovním postupu je „problémem“ samotné zařízení: klasickými vstupy jsou QPU, který chceš charakterizovat, a seznam vlastností, které chceš měřit, a kvantovými experimenty jsou charakterizační circuits z nich vygenerované.
Nejprve vyber backend. Tento tutoriál používá ibm_kingston, 156-qubitový procesor Heron r2; můžeš jej nahradit libovolným zařízením IBM Quantum, ke kterému máš přístup (nebo vybrat pomocí service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Dále zvol, které vlastnosti chceš měřit. Můžeš zadat libovolnou podmnožinu následujících experimentů:
-
readout: experiment SPAM (state preparation and measurement) -
rb_1q: izolované jednoqubitové randomizované benchmarkování -
rb_2q: simultánní dvouqubitové randomizované benchmarkování z experimentu layer fidelity -
t2: experiment Hahn echo (ve výchozím nastavení jedno echo) -
t1: experiment relaxace
Spusť celou sadu, abys získal ucelený obrázek o zařízení; odeber položky ze seznamu, pokud tě zajímají jen některé vlastnosti a chceš ušetřit čas QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Krok 2: Optimalizace problému pro spuštění na kvantovém hardwaru
Ve většině tutoriálů je toto místo, kde bys transpiloval své circuits. Zde se o to interně stará BackendCharacterization. Vytváří experimentální circuits přímo v nativních gates zařízení, spouští jednoqubitové experimenty na všech qubitech paralelně a plánuje dvouqubitové benchmarkování napříč disjunktními vrstvami coupling mapy, takže je celé zařízení pokryto hrstkou úloh. Díky této paralelizaci spotřebuje celá sada jen asi 70 sekund času QPU.
Inicializuj třídu, která spravuje pracovní postup:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Krok 3: Spuštění pomocí Qiskit primitiv
Metoda run_experiments vytváří circuits a odesílá je jako úlohy Sampler. Spusť ji uvnitř kontextu Batch, aby byly úlohy naplánovány společně na QPU, a metoda se vrátí, jakmile jsou všechny úlohy odeslány. (Můžeš ji spustit i mimo batch, nebo uvnitř Session.)
Může se ti zobrazit varování o tom, že je předáván Backend, zatímco je otevřený kontextový manažer relace. To je očekávané a lze to bezpečně ignorovat.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Metoda vrací odeslané úlohy jako slovník klíčovaný podle experimentu, což je užitečné pro jejich sledování na řídicím panelu IBM Quantum Platform nebo pro ladění.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Krok 4: Post-processing a vrácení výsledku v požadovaném klasickém formátu
Analýza výsledků
Metoda analyze_results čeká na dokončení úloh a fituje naměřená data (proloží je křivkami): exponenciální rozpady pro a , rozpady pravděpodobnosti přežití pro experimenty RB a přiřazovací matice pro readout. Vrací slovník map chyb, jednu položku pro každou měřenou vlastnost, přičemž každá mapuje qubit (nebo pár qubitů) na jeho naměřenou hodnotu.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Mapy pokrývají chybu readoutu, chyby jednoqubitových gates x a sx, vrstvené dvouqubitové chyby (lf_error_map, z experimentu layer fidelity) a časy a v sekundách.
Aktualizace vlastností backendu
Metoda update_backend zapisuje naměřené hodnoty do vlastností kopie backendu a vrací ji. Původní objekt backend si ponechává nahlášená kalibrační data, takže je můžeme oba porovnat, jak je ukázáno níže. Pamatuj, že tato aktualizace je čistě lokální pro tvou relaci Pythonu; nemění nic na zařízení ani pro ostatní uživatele.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Porovnání naměřených vlastností s nahlášenými
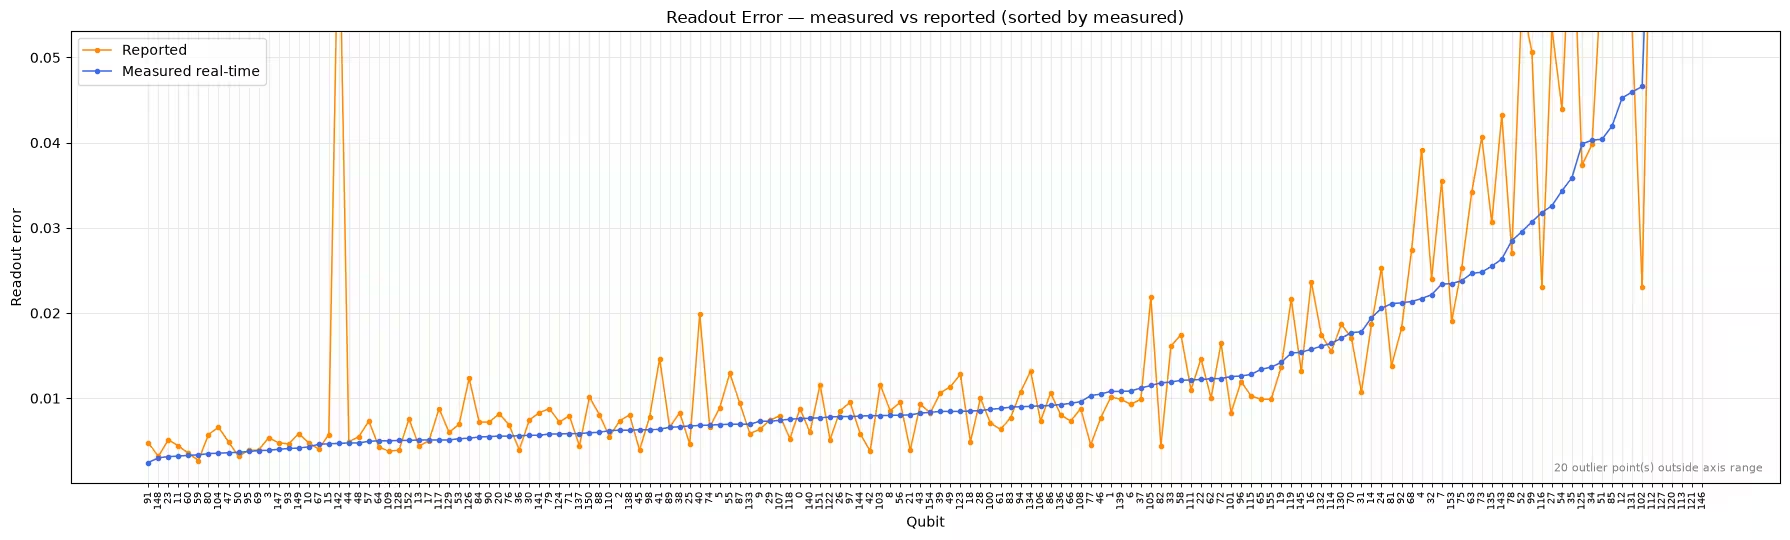
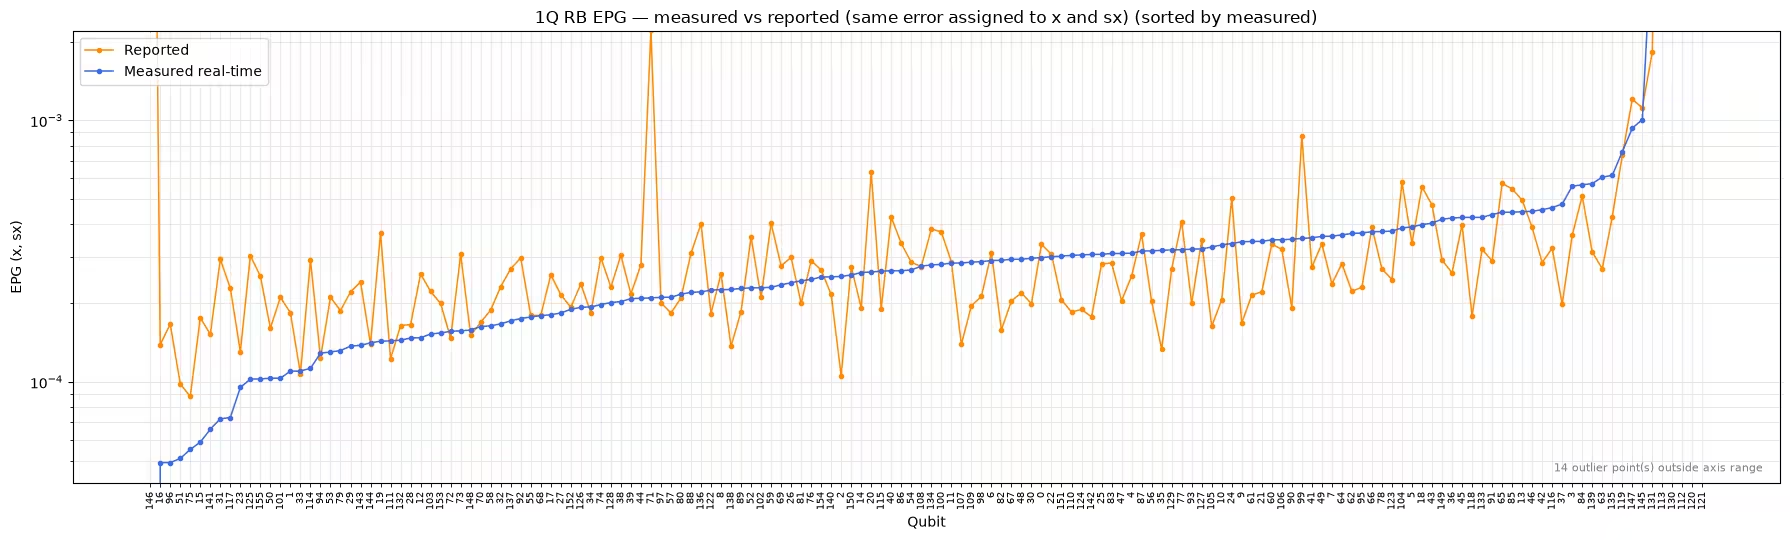
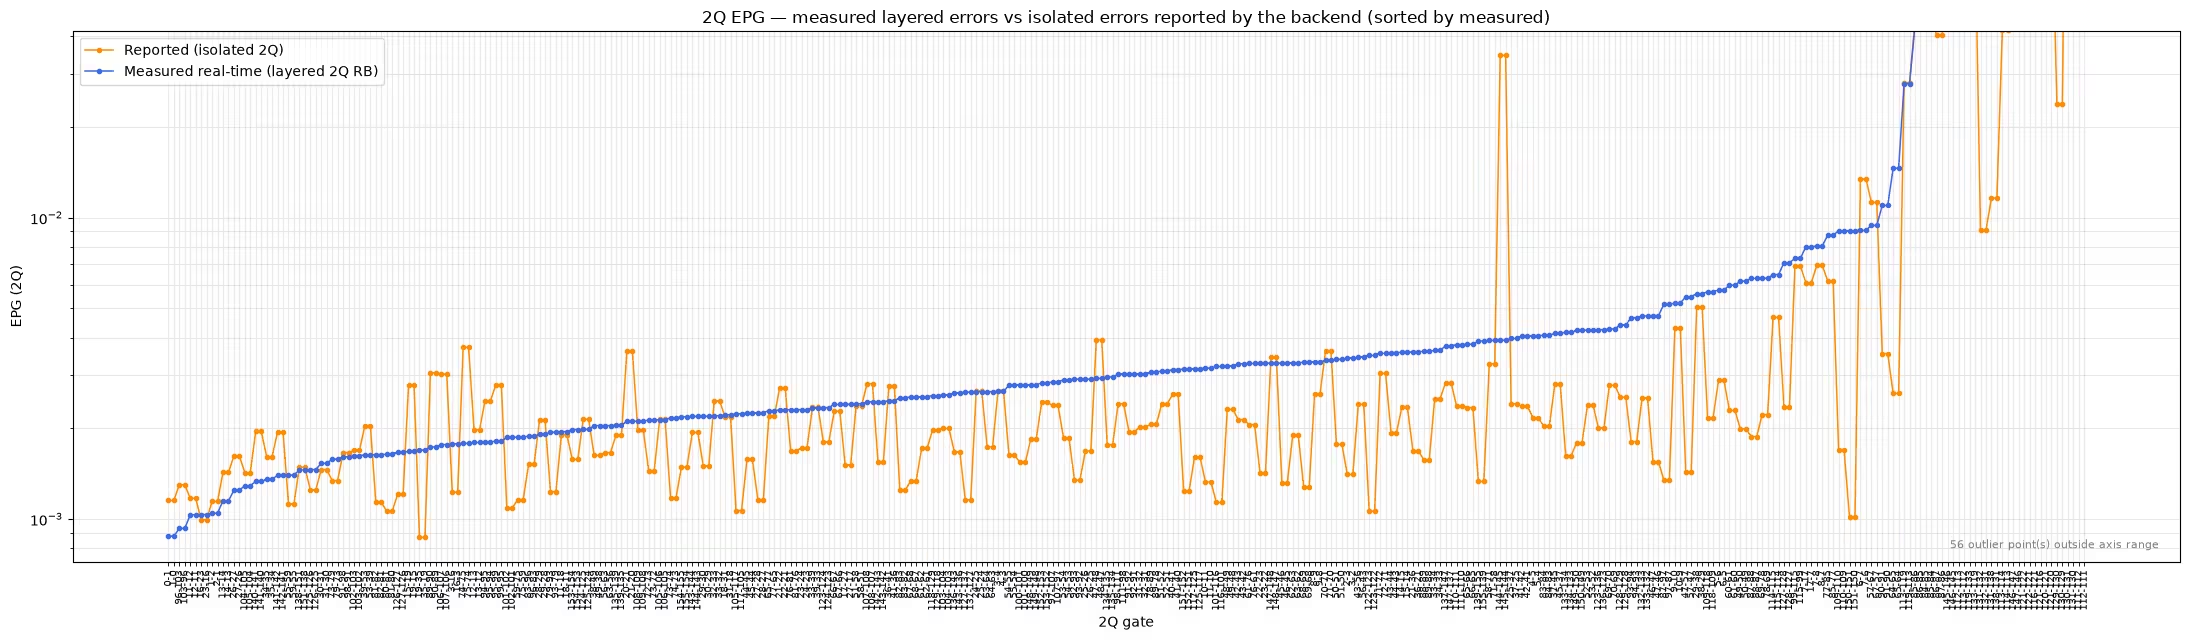
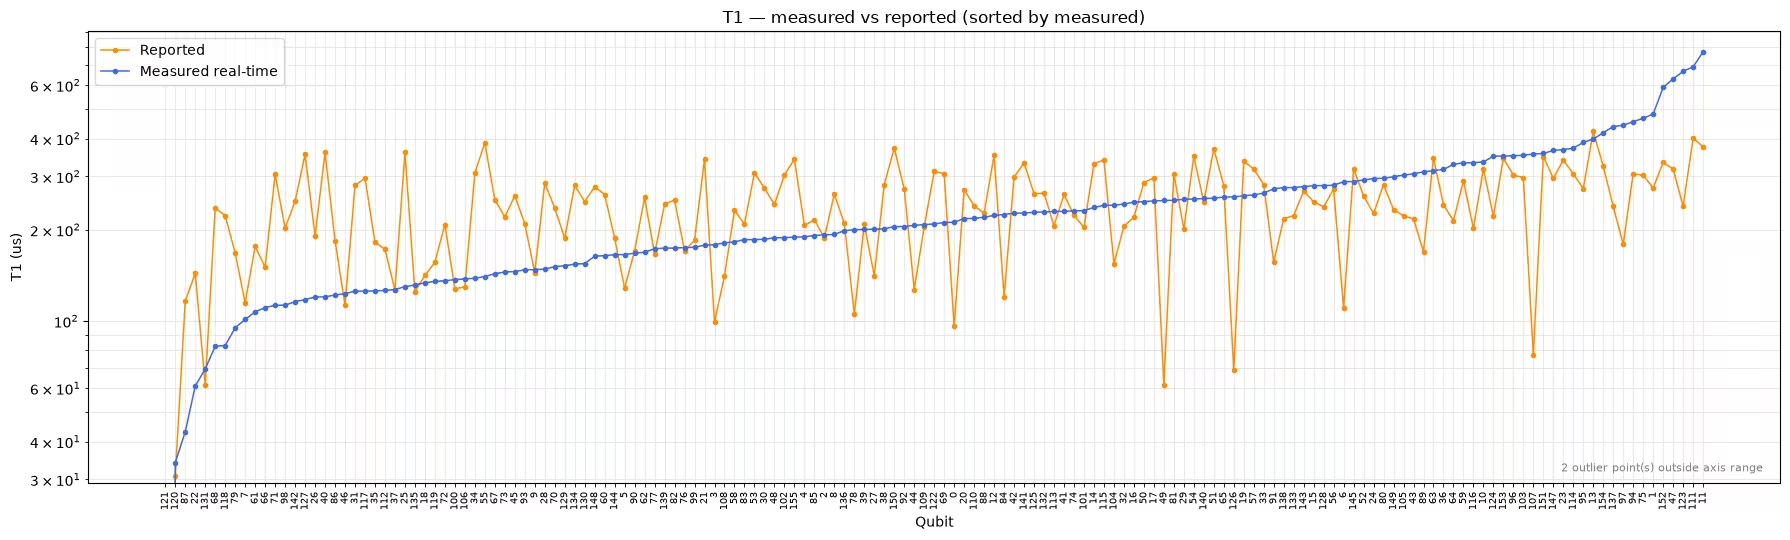
Nakonec vykresli naměřené vlastnosti v reálném čase proti hodnotám, které backend hlásí. V každém panelu jsou qubity (nebo páry qubitů) seřazeny podle naměřené hodnoty, takže naměřená křivka je díky konstrukci hladká a rozptyl nahlášených hodnot kolem ní ukazuje, kde se obě liší. Pro jednoqubitové RB je zobrazen jediný graf, protože stejná naměřená chyba na gate je přiřazena jak gate x, tak sx. Meze os jsou zvoleny na základě hlavní části dat, aby pár extrémních odlehlých hodnot grafy nestlačil; body mimo rozsah se počítají v anotaci v grafu (nebo lze meze přepsat předáním ylim).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
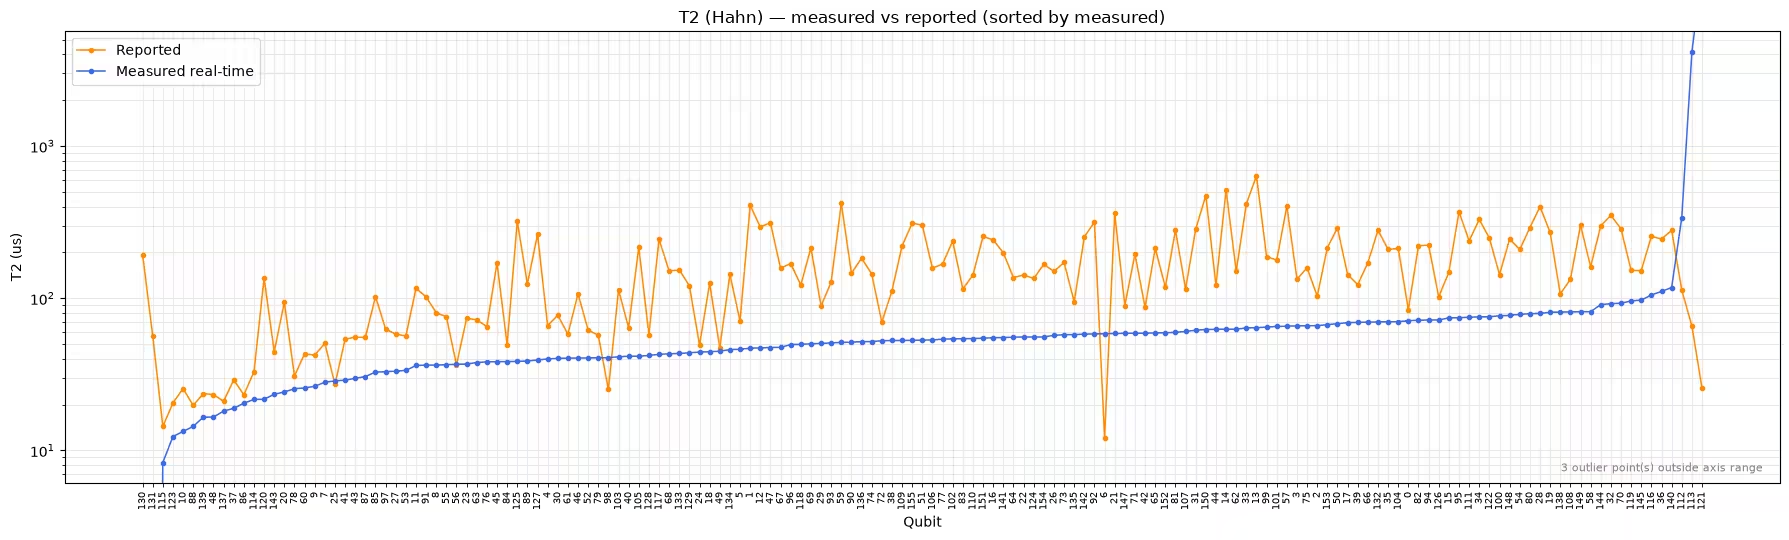
Tyto grafy vyžadují pečlivé čtení, protože ne každá mezera mezi oběma křivkami znamená, že zařízení driftovalo:
-
Readout a jednoqubitové chyby: Naměřené hodnoty sledují nahlášené u většiny qubitů, zatímco nahlášená hodnota u hrstky qubitů je od naměřené křivky značně vzdálena. Tyto lokalizované nesrovnalosti jsou právě drift, který má tento pracovní postup zachytit.
-
: Obě datové sady se rozptylují kolem sebe bez systematického posunu, což odpovídá tomu, že přirozeně kolísá v čase.
-
Dvouqubitové chyby: Naměřené hodnoty se systematicky nachází nad nahlášenými. To je očekávané, protože nahlášené hodnoty se měří na izolovaných gates, zatímco experiment layer fidelity spouští mnoho gates současně, a proto zahrnuje crosstalk. Vrstvená čísla jsou relevantnější pro hluboké circuits, ale nejsou přímo srovnatelná s nahlášenými kalibračními daty.
-
: Naměřené hodnoty jsou u většiny qubitů výrazně pod nahlášenými. I zde hraje velkou roli metodologie, jak je rozebráno v následující části.
Prozkoumání výsledků jednotlivých experimentů
Surové výsledky jednotlivých charakterizačních experimentů si můžeš prohlédnout také přes vlastnost experiment_data, která vrací příslušné objekty ExperimentData z Qiskit Experiments. Následující příklad například zobrazí naměřenou křivku rozpadu jednoho qubitu, což se hodí k ověření kvality fitu předtím, než začneš vypočtenému číslu důvěřovat.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Měření T2 pomocí sekvence dynamické decoupling
Ve výchozím nastavení experiment aplikuje jedno Hahn echo a měří všechny qubity paralelně, což, jak ukázal srovnávací graf výše, může vést k výrazně nižším hodnotám , než jaké backend hlásí. Jednou z hypotéz je počet ech: nahlášené hodnoty mohou být kalibrovány s použitím dynamického decouplingu (dynamického oddělování), který potlačuje nízkofrekvenční šum. Abys to otestoval, spusť charakterizaci pouze pro s t2_num_echoes nastaveným na vyšší hodnotu, což aplikuje sekvenci echo pulzů ve stylu CPMG. Prodlevy představují v obou případech celkovou dobu volné evoluce, takže nafitované hodnoty jsou přímo srovnatelné s výsledky s jedním echem.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
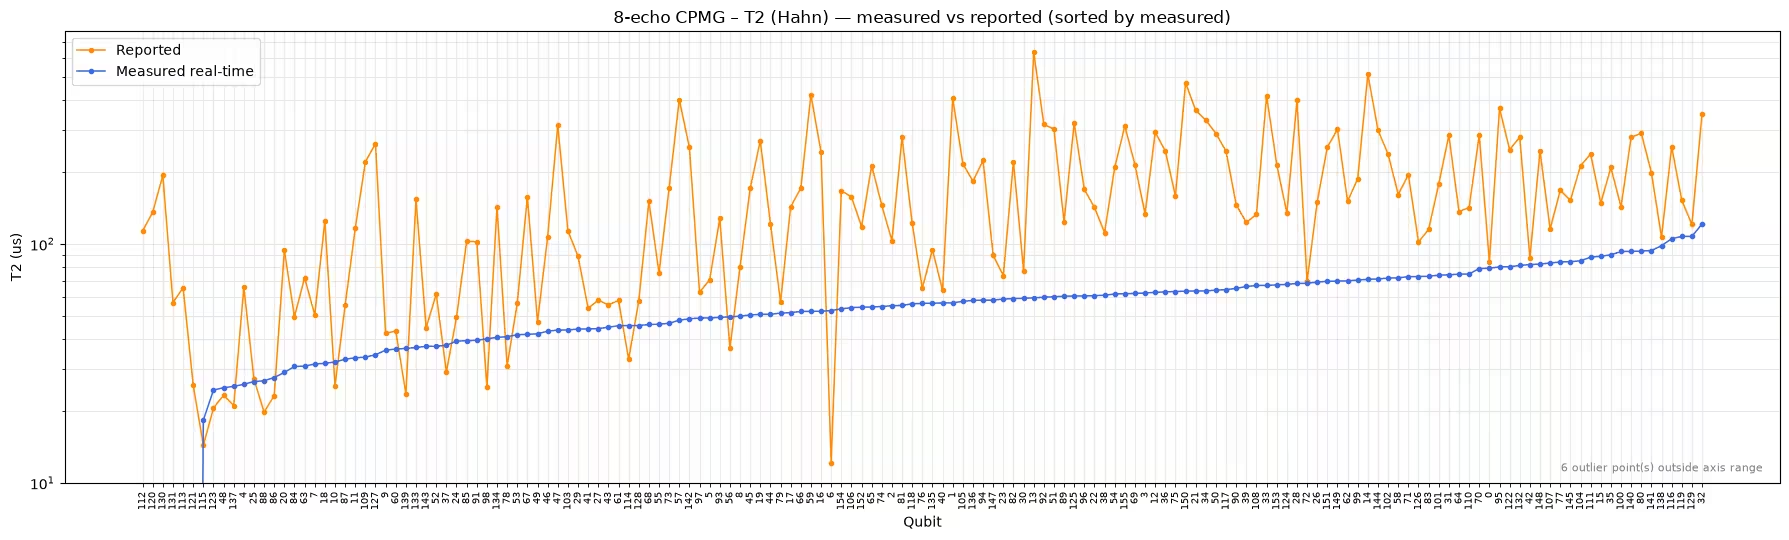
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
V tomto běhu extra echa výsledek téměř nezměnila: medián s 8 echy (56 µs) je blízko mediánu s jedním echem (53 µs) a oba zůstávají hluboko pod nahlášeným mediánem (142 µs). Samotný počet ech tento rozdíl nevysvětluje; hrají v tom roli i další metodologické rozdíly, jako detaily kalibračního postupu, měření všech qubitů paralelně místo izolovaně a podobně.
Praktickým ponaučením je přistupovat ke srovnávání (a vrstvené dvouqubitové chyby) napříč metodologiemi s opatrností. Obnovené hodnoty jsou vzájemně konzistentní snímek pořízený za podmínek blízkých reálné zátěži, což je činí vhodnými pro porovnávání qubitů mezi sebou nebo sledování zařízení v čase. Rozdíl oproti nahlášeným kalibračním datům ale automaticky neznamená důkaz driftu.
Kroky 1–4 sloučené do jediného volání
Pro každodenní použití zpravidla mezivýsledky nepotřebuješ. Metoda run_and_update řetězí vše, co jsi udělal výše (vytvoření, odeslání, přizpůsobení a aktualizaci) do jediného volání, které vrací obnovený backend. Přijímá stejný seznam experiments (a předává další volby jako t2_num_echoes) a lze ji stejně tak obalit kontextem Batch nebo Session.
Následující buňka nevrátí výsledek, dokud nejsou dokončeny všechny úlohy a post-processing.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Obnovený objekt backend_updated je nyní připraven k použití kdekoli, kde vlastnosti backendu vstupují do tvého pracovního postupu. Vyzkoušej tento proces spolu s tutoriálem Benchmarkování v reálném čase pro výběr qubitů, abys při transpilaci obvodu vybral nejlépe fungující qubity. Protože zařízení neustále driftuje, obnovuj vlastnosti co nejblíže okamžiku, kdy skutečně spouštíš svou úlohu.
Další kroky
Pokud tě tato práce zaujala, mohly by tě zajímat následující materiály:
- Použij obnovené vlastnosti k výběru lepších qubitů v tutoriálu Benchmarkování v reálném čase pro výběr qubitů
- Zjisti, jak jsou nahlášená kalibrační data zpřístupněna v příručce Informace o QPU
- Prozkoumej jednotlivé charakterizační experimenty v dokumentaci Qiskit Experiments
- Projdi si další benchmarky na úrovni zařízení v repozitáři Qiskit Device Benchmarking